ロボットの世界モデルは、現在のフレームとロボットの動作列から未来のフレームを生成するもので、方策の評価やモデルに基づく計画に使えます。動作ラベルのない動画からこうしたダイナミクスを学ぶ一般的な方法が潜在動作モデルです。隣り合う 2 フレーム間の見た目の変化を「代理の動作」として符号化し、次のフレームを再構成することで学習します。問題は、再構成という目的のせいで、潜在動作がロボット自身の動きと物体の反応やその他のシーンの変化をまとめて符号化してしまい、あとで実際のロボットの制御量をこの空間へ写像するときにきれいに対応しないことです。ハルビン工業大学(深圳)、シンガポール国立大学 Show Lab、平安科技の著者らはプレプリント SkeLAM(arXiv 2610.31474、2026-10-22)で、ロボットの骨格画像を教師として潜在動作を「運動学」と「残差」の 2 つに分け、ロボットの動作は運動学の部分だけに写像しました。著者らは、DROID の評価クリップ 400 本で、エンドエフェクタの平均変位誤差(ADE)が 41.15 ピクセルと DreamDojo の 51.11 より 19.5% 低く、知覚的な誤差 LPIPS が 0.1310 と 0.1473 より 11.1% 低いと報告しています。本記事では 2 点を詳しく読みます。骨格は学習時にしか現れないので、デプロイ時には何がロボットの動作をつなぐのか。そして、これらの数字と方策評価の結果がそれぞれどう測られたかです。数字はすべて著者報告 [R] で、本サイトでは再現していません。
課題:再構成で学んだ潜在動作は「アームの動き」と「物体の反応」を区別できない
論文の例では、似たエンドエフェクタの動きでも、接触状態が違えば物体の反応が変わります。潜在動作が両方を符号化していると、ロボットの動作から潜在動作を回帰するとき、回帰の目標にロボットの動きとは関係のない、シーンに依存するばらつきが入り込みます。著者らはこの情報を捨てたいわけではありません。正確なシミュレーションには、ロボットの動きが周囲のシーンにどう影響するかを予測することこそが必要だからです。そこで 2 つの成分を設けます。動作適応の目標となる専用の運動学成分と、世界モデルの学習のために補完的な視覚ダイナミクスを残す残差成分です。
骨格画像はロボットの構成と動きを表し、シーンの見た目を含みません。既存研究(論文は OSCAR などを挙げています)は、骨格の系列や運動学のレンダリングをそのまま生成の条件に使います。SkeLAM は違います。骨格は RGB から学ぶ運動学潜在を教師するためだけに使い、デプロイ時のインターフェースは RGB 観測とロボットの動作だけです。
手法:3 つの学習段階、骨格は最初の段階のあとで退場する
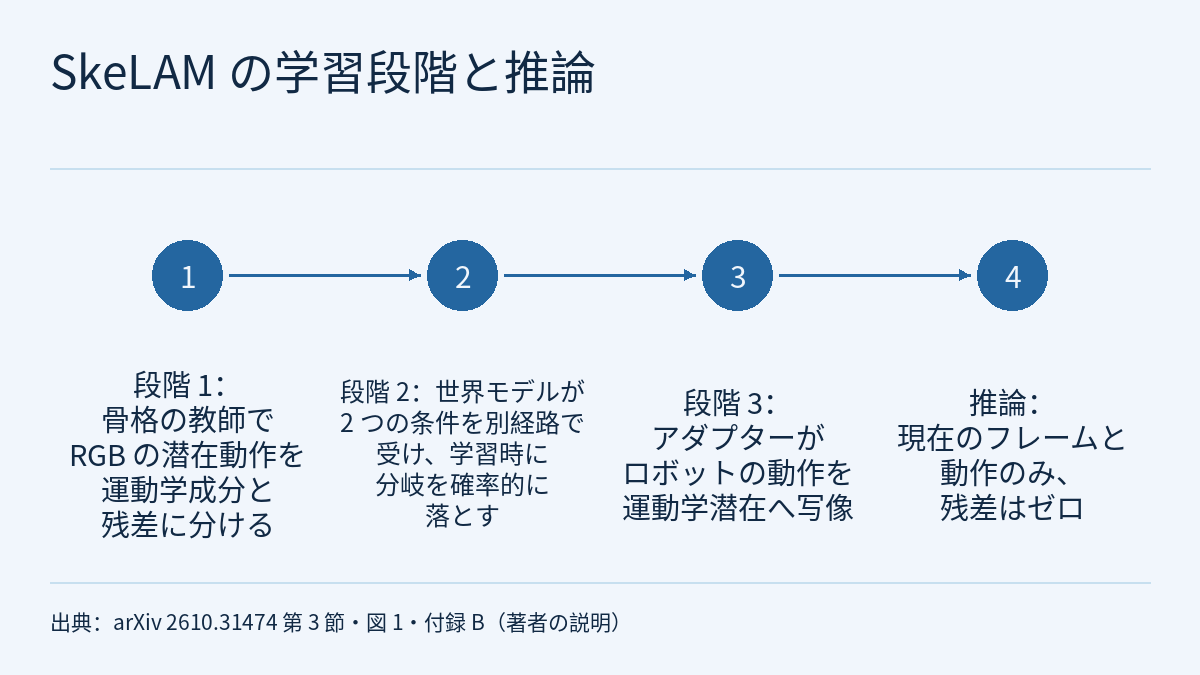
潜在動作モデルは 2 つの Transformer VAE で、運動学潜在と残差潜在はそれぞれ 32 次元です。世界モデルのバックボーンは Cosmos-Predict2.5-2B です。付録に示された学習の流れは次のとおりです(K は千回の更新)。
| 段階 | 内容 | 更新回数 |
|---|---|---|
| 1A | RGB と骨格の 2 つのブランチがそれぞれ条件付き再構成を学ぶ。RGB ブランチは現在のフレームと 2 種類の潜在から次のフレームを、骨格ブランチは現在の骨格画像と骨格の運動潜在から次の骨格画像を再構成する | 60K |
| 1B | 骨格のエンコーダーとデコーダーを凍結する。RGB の運動学潜在の事後平均を凍結した骨格デコーダーに入れ、次の骨格画像を再構成させる(グラウンディング)。さらに正規化したうえで、対になった骨格の運動潜在と整合させる | 20K |
| 1C | クロスモーダル入れ替え再構成。RGB の運動学潜在を対になった骨格の事後平均に置き換え、残差はそのままにして、同じ RGB フレームを再構成させる。その後、段階 1 のモデル全体を凍結する | 5K |
| 2A / 2B | 2 つの成分をそれぞれの MLP 射影で世界モデルの条件にする。2A は条件の射影だけを学習し、2B は DiT バックボーン全体をファインチューニングする。この間、クリップごとにブランチを確率的に落とす | 5K / 20K |
| 3A / 3B | 3A では 7→256→256→32 の MLP アダプターだけを学習し、ロボットの動作を運動学潜在の事後平均へ回帰する。3B ではアダプターの予測を使って世界モデル全体をファインチューニングし、残差を段階的に外す | 2K / 30K |
入れ替え再構成の役割。潜在空間で RGB と骨格を整合させるだけでは、RGB デコーダーが骨格側の動きの条件を実際に受け入れる保証はありません。入れ替え再構成では、同じデコーダー、同じ現在フレーム、同じ目標が、2 種類の運動学入力のどちらでも成り立つことを求めます。著者らは、これによりクロスモーダルの対応が潜在空間から再構成のレベルへ広がると述べています。
ブランチ・ドロップアウト。残差潜在は未来のフレームを使うため、デプロイ時には得られません。世界モデルの学習では、クリップごとに 1 つのモードを選びます。両方を残す、両方を落とす、運動学だけを落とす、残差だけを落とす、の 4 つです。4 つのモードの確率は、段階 2 の最初の 1,000 ステップでは 0.80、0.10、0.05、0.05、それ以降は 0.50、0.10、0.05、0.35 で、「残差だけを落とす」の割合が上がります。このモードはデプロイ時の「現在フレームと運動学の条件」という状況に対応し、教師となる目標は常に未来のクリップ全体です。
動作のインターフェース。DROID の動作は、連続してサンプリングされた状態どうしの 7 次元の変化量として定義されます。ロボットのベース座標系での並進、相対回転の回転ベクトル、次の時点でのグリッパーの開き具合です。関節空間の指令でも、クリップの開始時点からの量でもありません。段階 3B では、残差を最初の 2,000 回の更新では確率 0.5 で残し、2,000〜7,999 回の更新の間に線形に 0 まで下げ、それ以降は 0 にします。推論時は観測フレーム 1 枚と 12 ステップの動作だけを与え、残差とマスクをゼロにして、12 枚の未来フレームを生成します。
DROID の数字をどう読むか
評価セットは DROID の 400 クリップで、400 本の軌跡から 1 本ずつ取り、動きの大きさの四分位ごとに 100 本、さらにカメラで層別しています。各クリップは条件フレーム 1 枚と未来フレーム 12 枚、解像度 480×640、15 FPS、長さ 0.8 秒です。ADE は画像平面上の 2 次元のエンドエフェクタ変位誤差で、単位はピクセル、最初のフレームからの変位で計算します。著者らによると、エンドエフェクタの追跡が無効な軌跡はスコアから除かれますが、カバレッジの分母には残ります。そのため手法ごとに有効なサブセットが異なり得ます。本記事が依拠したテキストには、手法ごとの有効な軌跡の数は示されていません。
| 手法 | 制御インターフェース | LPIPS ↓ | ADE(px)↓ | 方向 F1 ↑ | 大きさの相関 r ↑ |
|---|---|---|---|---|---|
| Ctrl-World | 動作埋め込み | 0.4029 | 42.96 | 0.5888 | 0.5154 |
| OSCAR | 骨格 | 0.4788 | 43.74 | 0.5810 | 0.5029 |
| DreamDojo | 動作 a(大規模な相互作用で事前学習) | 0.1473 | 51.11 | 0.4989 | 0.3335 |
| CD-LAM | 動作→潜在 z | 0.1586 | 53.90 | 0.4903 | 0.3179 |
| SkeLAM | 動作→運動学潜在 | 0.1310 | 41.15 | 0.5465 | 0.5277 |
- 誰に対して、どれだけ上回るか。著者らは、SkeLAM が動作条件付きモデルの中で 8 指標のうち 7 指標で 1 位、視覚的な忠実度の 4 指標はすべて 1 位だとしています。2 つの潜在動作ベースラインに対し、ADE はそれぞれ 19.5% と 23.7%、LPIPS は 11.1% と 17.4% 低くなっています(本サイトで表と照合し一致)。ただし、動作埋め込みを直接使う Ctrl-World との ADE の差は 1.81 ピクセルにとどまり、方向 F1 は Ctrl-World と OSCAR のほうが高くなっています。SkeLAM と Ctrl-World の主な差は画像の忠実度で、LPIPS は 0.1310 対 0.4029 です。
- アブレーション。同じ学習予算で構成要素を 1 つずつ外した結果です。骨格の教師を外すと ADE は 64.59 に上がり、大きさの相関は 0.2009 に下がります。入れ替え再構成を外すと ADE は 66.74、LPIPS は 0.1436 に上がります。動作適応の回帰による教師を外すと ADE は 65.84 に上がります。残差を外すと LPIPS はほとんど変わらず(0.1305)、ADE は 43.37 に上がります。本サイトで比べると、骨格の教師、入れ替え再構成、アダプターの回帰のどれか 1 つを外すだけで、ADE は 2 つの潜在動作ベースライン(DreamDojo 51.11、CD-LAM 53.90)をいずれも上回ります。つまり 2 成分の構造だけでは足りません。
- 運動学成分に何が入っているか。凍結した表現の上で線形プローブを学習してエンドエフェクタの変位を予測すると、32 次元の運動学成分の R² は 0.3200、残差を連結した 64 次元の表現は 0.3277、DreamDojo は 0.0078 でした。特権的な骨格入力を使う骨格教師は 0.4312 です。別の介入実験では、RGB デコーダーの運動学入力を対になった骨格の平均に置き換えると再構成 MAE の増加は 0.53% にとどまり、対にならない骨格に置き換えると 11.67% 増えました。運動学成分をゼロにすると 5.78%、残差をゼロにすると 0.61% 増えました。
人からロボットへの動きの転移と方策評価
転移の証拠は定性的なものだけです。著者らは UniSkill の人間のデモ動画を動きのプロンプトとして使いました。RGB エンコーダーが人間の動画から潜在動作を取り出してそのまま条件とし、ロボットの観測 1 枚を初期シーンとし、パラメータはすべて固定です。論文の図には 2 つの例があり、タオルを押す(エンドエフェクタが下へ伸びる)とティッシュを引く(上へ動く)です。比較した DreamDojo の事前学習チェックポイントでは、エンドエフェクタの変位はわずかでした。定量的な指標はありません。
方策評価は開ループのリプレイです。RoboArena で 7 つの方策、15 セッション、計 105 エピソードを評価しました。2 つの世界モデルには同じ初期観測と、実機実行時に記録された動作を与えます。生成された映像の中でタスクが成功したかを人間のアノテーターが判定し、実機の結果と比べます。比較対象は Cosmos-Predict2.5 だけで、これは SkeLAM の世界モデルのバックボーンの出発点です。
| モデル | バランス精度 | 成功の再現率 | MCC | Spearman ρ | Pearson r | 成功率の MAE(ポイント) |
|---|---|---|---|---|---|---|
| Cosmos-Predict2.5 | 48.44% | 0.00% | −0.0525 | −0.0756 | −0.1936 | 7.62 |
| SkeLAM | 63.02% | 33.33% | 0.2483 | 0.5347 | 0.6091 | 4.76 |
著者ら自身、33.33% という成功の再現率は控えめで、生成された映像の中で成功という結末を再現するのはまだ難しいと述べています。実機で成功したエピソードのうち、生成映像でも成功と判定されたのは 3 分の 1 だけです。方策レベルの相関は 7 つの方策だけに基づいています。各方策が 15 エピソードずつだとすると(105 = 7×15、本サイトの推定)、1 つの方策の成功率は 6.67 ポイント刻みで動くので、平均誤差 4.76 ポイントは 7 方策の合計でおよそ 5 エピソード、Cosmos-Predict2.5 の 7.62 はおよそ 8 エピソードのずれに相当します(本サイトの換算)。開ループのリプレイでは、方策は生成されたフレームを見ず、それに反応もしません。著者らは閉ループの方策評価を今後の課題に挙げています。
本サイトの他の記事との関係
本サイトではこれまで、世界モデルで方策の成功率を見積もる論文を 2 本取り上げました。フロンティア・レーダー|Token-World は RGB を生成せず VLM の token 空間で展開し、フロンティア・レーダー|PhysCanvas は触覚とタスク状態をキャンバスに加えます。SkeLAM が扱うのはその手前の段階で、動画から学んだ世界モデルに動作をどうつなぐかです。3 本の論文は方策、タスク、ラベル付けの方法、相関の定義がいずれも異なるので、数字は比べられません。フロンティア・レーダー|EgoJEPA も動画から潜在動作を学びますが、目的は方策の学習です。SkeLAM の潜在動作は世界モデルの条件になります。7 次元の状態変化量のような動作の定義の違いは、フィジカルAIラボ 1.5:データはどこから来る? で扱った動作空間と照らし合わせて読めます。7 つの方策と 105 エピソードに基づく相関や再現率は、フィジカルAIラボ 1.8:評価 の方法で読むことができます。
制約と注意点
- arXiv のプレプリントで、数字はすべて著者報告 [R] です。本サイトでは再現していません。読んだテキストには信頼区間や複数の乱数シードでの結果はありません。DROID の推論では各クリップを 1 回だけ生成しています。
- 動きの指標は 1 台のカメラ画像上の 2 次元のピクセル量で、エンドエフェクタの追跡に依存します。追跡が無効な軌跡はスコアに入らず、手法ごとに有効なサブセットが異なり得ます。読んだテキストには有効数は示されていません。
- 学習には RGB と骨格画像の対が必要です。骨格画像は OSCAR の対応するサブセットで事前にレンダリングされたもので、ロボットの運動学とカメラの射影に依存します。別のロボットや校正されていない動画でこの教師が得られるかどうかは、読んだテキストでは議論されていません。
- 人からロボットへの転移は定性的な 2 例だけです。方策評価は開ループのリプレイと人による判定で、比較対象は Cosmos-Predict2.5 だけ、成功の再現率は 33.33% です。閉ループの評価でもハードウェアの安全性検証でもありません。
- 著者らによると、1 回の完全な学習は NVIDIA A100 で約 2 日かかり、段階 1B/1C は A100 80GB 8 基で学習しています。著者情報の欄にはプロジェクトページが示されていますが、読んだテキストにはコードや重みを公開しているかどうかの記載がなく、本サイトはそのページの内容を確認していません。
リンク
- Skeleton-Grounded Latent Action Model for Robot World Models(arXiv 2610.31474)
- 論文 HTML 全文
- フロンティア・レーダー|Token-World:VLM の token 空間で世界モデルを展開し、RGB 再構成なしで VLA 方策をシミュレーションする
- フロンティア・レーダー|PhysCanvas:視覚・触覚・タスク状態を 1 枚のキャンバスに描き、凍結した 3 つの報酬モデルで世界モデル内の成否を実機に近づける
- フロンティア・レーダー|EgoJEPA:人からロボットへのリターゲティングをやめ、一人称視点の人間の動画から潜在動作を学び、ロボットごとにアダプター 1 組を加えて調整する
- フィジカルAIラボ 1.5:データはどこから来る?――SO-101 のメタデータからお手本の長さを求め、三つの入手ルートの単位と動作空間を見分ける
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)