大規模言語モデルでタスク計画用のファインチューニングデータを自動生成すると、生成した問題そのものに解がないことがよくあります。シーングラフに重要な物体や属性が欠け、タスクの目標と環境が食い違い、PDDL プランナーが解を見つけられず、そのサンプルは通常捨てられます。中国科学院自動化研究所と中国科学院大学人工知能学院の著者らはプレプリント SCOPE(arXiv 2610.31518、2026-10-22)で別の扱い方をとりました。プランナーの失敗を診断信号とみなし、欠けている前提を逆算してシーングラフに補い、実行可能な計画が得られるまで計画し直します。著者らの報告では、SCOPE で生成した 1 万件のデータで Qwen2.5-7B-Instruct を LoRA ファインチューニングすると、AI2-THOR のシーングラフでの全体成功率は 63.00% で、DELTA で生成した同量のデータでは 50.67% でした。差は 12.33 ポイントです。本記事では、この「失敗を修復に変える」工程の仕組みと、2 つの実験がそれぞれ何を示し、何を示さないかを中心に読みます。以下の数値はすべて著者の報告 [R] で、本サイトでは再現していません。
問題:自動生成した計画データはなぜ「解けない」のか
論文は、タスク・動作計画(TAMP)のファインチューニング用サンプルを 3 つの要素に分けます。環境の状態を記述するシーングラフ、タスクの目標を定める指示、解となる計画です。人手による注釈は品質が高い一方でコストも高く、ファインチューニングに必要な規模まで広げるのは困難です。LLM で直接合成すれば安価ですが、著者らは品質の問題が主に 2 つあると考えています。1 つは均質化です。モデルの好みのためにシーングラフの重複が多く、データセットの情報エントロピーが不足し、汎化が制限されます。もう 1 つは解けないことです。幻覚によってシーングラフに論理的な欠陥、たとえば操作対象の物体の欠落や属性の誤りが生じ、タスクが物理的に解けなくなり、訓練データに多くのノイズが入ります。著者らは、PDDL プランナーにもとづく既存のパイプラインは論理的な一貫性が高いものの、シーングラフの構造が単純で多様性に欠け、やはり解けることを保証できないと指摘しています。
生成の流れ:シーン、指示、計画の 3 段階
シーングラフ。モデルが出現頻度の高い部屋タイプを好む傾向に対抗するため、SCOPE は生成履歴における部屋タイプごとの累積使用頻度を記録し、経験分布 p̂_t(r_i) を求め、次の選択確率を P_t(r_i) ∝ exp(−α · p̂_t(r_i)) で調整します。α は経験的に 3.0 です。ある部屋タイプが多く生成されるほど、次に選ばれる確率は下がります。同じ部屋タイプの中でも、毎回アセットライブラリから家具 5–10 点と物体 20–30 個を無作為に選んでプロンプトに入れ、モデルが同じありふれた物ばかり使わないようにします。シーングラフは一度に出力させず、軽量な DSL の命令列として粗から細へ組み立てます。AddRoom と SetAgent で部屋タイプとエージェントの初期状態を決め、AddFurn で大型の家具を置き、PlaceObj で物体を家具の内側または外側に配置します。著者らによると、完全なシーングラフを一度に出力させると、支える家具のない物体や包含関係の矛盾といった構造上の誤りがよく生じます。
指示。モデルは「目標のサンプリング → 行動連鎖の構築 → 指示の言語化」という思考連鎖の順序に従い、線形化したシーングラフから操作可能な物体を選び、目標状態に至る因果的な行動連鎖を組み立て、自然言語の指示にします。ユーザーの意図をどれだけ明示するかによって、simple、complex、vague の 3 段階に分けます。後処理では集合照合により、指示に含まれる目標の物体と場所がすべてシーンの実体に含まれるかを確認し、含まれないタスクは捨てます。
計画。SCOPE はロボットの低レベル操作能力を 9 つの高レベル原子行動にまとめています。place_on、place_in、open、close、power_on、power_off、fill、pour、slice です。シーングラフは初期 PDDL 状態に変換され、指示は LLM によって段階的に行動列へ分解されてサブゴールに対応づけられます。そのうえで DELTA の自己回帰的な方法と同様に、サブゴールを 1 つずつ古典的なヒューリスティック探索プランナーに渡して解きます。シーングラフと指示をどの LLM で生成したかは、読んだ本文には書かれていません。
要となる工程:計画の失敗を修復の信号に変える
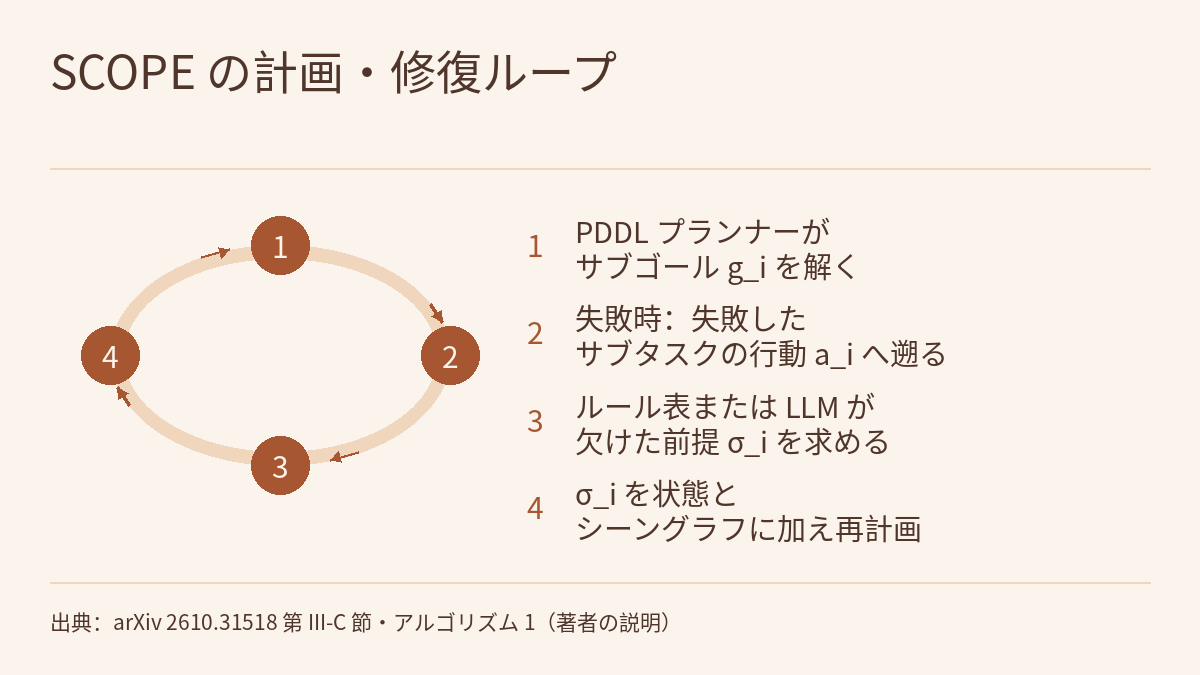
サブゴールが解けないとき、SCOPE はサンプルを捨てません。失敗したサブタスクの中核となる行動 a_i まで遡り、失敗の原因となった状態の不足 σ_i = f(a_i | s_i)、つまり現在の状態でその行動を実行するのに必要だがシーングラフに欠けている静的属性や初期状態を求めます。次に σ_i を現在の状態とシーングラフの両方に加え(s_new = s_old ∪ σ_i、SG_new = SG_old ∪ σ_i)、プランナーに戻して解き直します。σ_i を求める関数 f は 2 層です。1 層目はあらかじめ定義した「行動–前提」対応表で、著者らの例では power_on の計画が失敗したときに物体へ “powerable” 属性を加えます。表にないロングテールの行動は、制限した物体の状態と失敗した行動をまとめて LLM に渡し、補うべき属性と初期状態を推論させます。すべてのサブゴールで有効なサブ計画が得られたら、それらを連結して完全な計画 Π とし、修復後のシーングラフおよび指示と合わせて 1 件の訓練サンプル ⟨SG_final, I, Π⟩ とします。
結果を読むうえで大事な点があります。修復が変えるのはシーンであり、計画ではありません。データ生成ではこれは妥当です。シーンはもともと合成したもので、シーンをタスクと整合させることこそが目的だからです。ただしこれは、SCOPE が最終的に残すのが「解けるように書き換えた問題」であって、元の問題の解ではないことを意味します。論文のアルゴリズム 1 では、修復ループは「π_i が失敗である間」繰り返すと書かれています。読んだ本文には、反復回数の上限、修復が発生する割合、修復が成功しない場合の扱い、補った属性が常識的に妥当かの確認は示されていません。
2 つの実験はそれぞれ何を測っているか
著者らは評価セットを 2 つ自作しました。いずれもシーングラフ 100 件と指示 300 件からなり、simple、complex、vague の 3 段階に分かれます。評価ではまず PDDLGym と VAL のツールチェーンで行動列が実行できるかを確認し、次に LLM-as-a-Judge が 0–4 点で採点します。指標は 3 つです。実行可能率 EX は、タスクとの関連にかかわらず、環境での行動が成功した割合だけを数えます。平均品質スコア AQS は 0–4 点の平均です。成功率 SR は満点の 4 点のタスクだけを成功と数えます。読んだ本文には、採点役のモデル名は書かれていません。
| 実験 | シーングラフの出どころ | 何を比べているか | 全体の結果(SR / EX / AQS) |
|---|---|---|---|
| 表 I:ノイズを含むシーングラフでの計画 | LLM が生成し、論理的な幻覚や属性の欠落を含む(LLM-Synthetic Noisy Dataset) | 各手法が同じノイズ入りのシーングラフと指示に対して直接計画する。ファインチューニングは含まない | SCOPE 70.67% / 92.67% / 3.28、DELTA 46.33% / 67.00% / 2.25、LLM+P 41.67% / 48.00% / 1.76、LLM-As-Planner 27.00% / 29.67% / 1.84、LLMGenPlan 23.00% / 61.33% / 1.24 |
| 表 II:異なるデータでファインチューニングしたモデル | AI2-THOR シミュレータの状態から直接抽出し、論理的な欠陥がない(AI2-THOR Grounded Dataset) | 同じベースモデル Qwen2.5-7B-Instruct を、各手法で生成した 10,000 件の三つ組と同一の LoRA 設定でファインチューニングし、得られたモデルを評価する | SCOPE(多様性+誤り訂正)63.00% / 85.33% / 3.08、DELTA のデータ 50.67% / 77.67% / 2.67、LLM-As-Planner のデータ 25.00% / 26.00% / 1.57 |
表 I で、DELTA と LLM+P は計画を PDDL ソルバーに任せます。著者らは、両者の弱点が初期状態への完全な依存にあると見ています。シーングラフに前提が欠けていると、ソルバーは解なしを返すかタイムアウトします。SCOPE の complex での成功率は 55.00% で DELTA は 31.00%、vague では 71.00% 対 39.00% です。LLMGenPlan は再試行を加えると実行可能率が 61.33% に上がりますが、成功率は 23.00% にとどまります。著者らは、テキストレベルのフィードバックは無効な行動表現を除くだけで、シーングラフの論理的な誤りは直せないためだと説明しています。
数値を読むときの注意点
- 表 I は厳密には同じ問題を比べていません。SCOPE は計画の途中で入力のシーングラフを書き換えますが、ほかの手法は元のグラフをそのまま受け入れるしかありません。表 I の実行可能性の確認が、元のノイズ入りシーングラフに対して行われたのか、修復後のシーングラフに対して行われたのかは、読んだ本文には書かれていません。データ生成では「解けるようにシーンを変える」ことが目的です。しかしこの結果を「運用時の知覚誤りに強い」と読むには別の証拠が必要です。実際のシーンで属性が欠けているのは、知覚の見落としかもしれず、物体が本当にその機能を持たないのかもしれません。属性を補っても、計画が記号のレベルで実行可能になるだけです。
- 12.33 はポイント差で、指示約 37 件分です。63.00% と 50.67% はいずれも指示 300 件を分母とし、成功はそれぞれ 189 件と 152 件に当たります(本サイトの換算)。読んだ本文には信頼区間、反復回数、乱数シードは報告されていません。
- 2 つの構成要素のアブレーション。通常のシーンで誤り訂正だけを加えると全体成功率は 58.00%、complex は 41.00%(DELTA のデータでは 28.00%)です。多様性だけを加え誤り訂正なしでは 59.67%、complex は 40.00% です。両方を使うと 63.00%、complex は 50.00% です。ただし完全な構成がすべての列で最高というわけではありません。実行可能率 85.33% は多様性のみの 87.00% より低く、vague の成功率 51.00% も 52.00% をわずかに下回ります。simple では SCOPE の各構成が 86.00%–88.00% の範囲にあり、差は小さいです。
- 表 II のラベルの食い違い。本文には「DELTA の成功率が 50.67% から 59.67% に上がる」とありますが、表で 59.67% の行は「SCOPE、多様性 ✓、誤り訂正 ✗」となっています。本文の書き方からすると、この行は多様化したシーンで DELTA 式の計画により生成したデータのようですが、読んだ本文には明記されておらず、読者はこの行のデータがどう生成されたか確定できません。
- 失敗の分析。著者らはファインチューニング後のモデルの失敗 111 件を 2 種類に分けています。認知的な誤りが約 6 割で、指示の取りこぼし 33 件と論理・意味の誤り 34 件です。グラウンディングの誤りは、物理的な制約 23 件(例:環境の物理への違反)と知覚の幻覚 21 件(例:存在しない物体との相互作用)です。4 種類の合計は 111 件で、300 件のうち 63.00% が成功した残りの件数にちょうど一致します(本サイトの確認)。つまり、論理的な欠陥のないテスト用シーングラフでも、ファインチューニング後のモデルには知覚の幻覚による失敗が 21 件あり、論文はこの種類の例として存在しない物体との相互作用を挙げています。
本サイトのほかの記事との関係
SCOPE は フィジカルAIラボ 0.3:見る・考える・動く でいう「考える」のうち遅い層にあり、出力は高レベルの行動列で、関節への指令ではありません。直近 2 本のレーダー記事も行動の前提条件を扱っていますが、使う場所が異なります。フロンティア・レーダー|SLoSa は形式検証器の段階的な結果を報酬にしてプランナーを直接学習します。フロンティア・レーダー|CausGround は相互作用の軌跡から前提条件と効果を導き、パラメータを凍結したプランナーに渡します。SCOPE は推論時にプランナーを助けるのではなく、プランナーの失敗を使ってデータを修復し、そのデータでモデルをファインチューニングします。3 つはタスク、環境、指標がそれぞれ異なるため、数値を互いに比べることはできません。ロボットデータの入手ルートの 1 つとしての合成データについては フィジカルAIラボ 1.5:データはどこから来る? を、EX と SR の差、反復回数の報告がない指示 300 件での評価のばらつき、1 つの失敗ラベルが複数の失敗の種類を覆い隠す問題については フィジカルAIラボ 1.8:評価 の方法を参照してください。
制約と注意点
- arXiv のプレプリントであり、数値はすべて著者の報告 [R] です。本サイトでは再現していません。読んだ本文には信頼区間、反復回数、乱数シードがありません。
- 2 つの評価セットはどちらも著者らが自作したもので、それぞれ指示 300 件です。SR と AQS は LLM の採点役の評価に依存しますが、読んだ本文には採点役のモデル名も、人手の判断との一致度も示されていません。
- 実験はすべて記号的な計画と AI2-THOR シミュレータの中で行われています。図 3 はシミュレータ内での実行を示す定性的なスナップショットです。実機実験はなく、ハードウェアの安全性を検証したものではありません。
- 修復ループの反復上限、発生頻度、修復が失敗した場合の扱い、補った属性の妥当性の確認は、読んだ本文にはいずれも示されていません。シーングラフと指示の生成に使った LLM も明記されていません。
- 表 II の 59.67% の行のラベルは、上で述べたとおり本文の説明と一致しません。
- 論文はプロジェクトページのアドレスとして scope-page.github.io を挙げ、さらに多くのデモと情報があるとしています。読んだ本文には、コードやデータセットが公開されているかは書かれていません。本サイトは執筆時にこのページを開いて内容を確認していません。
- 「約 37 件」「189 件と 152 件」「4 種類の合計 111 件」は、指示 300 件を分母として本サイトが行った換算と確認です。
リンク
- SCOPE: Scene-graph Construction Optimized by Plan Error-correction for Robot Long-term Planning Datasets(arXiv 2610.31518)
- 論文の HTML 全文
- フィジカルAIラボ 0.3:見る・考える・動く――3 つの周波数をそれぞれのシステムに戻す
- フィジカルAIラボ 1.5:データはどこから来る?――SO-101 のメタデータからお手本の長さを求め、三つの入手ルートの単位と動作空間を見分ける
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フロンティア・レーダー|SLoSa:形式検証器が決まった順序で計画を 5 つの結果に分けて報酬区間を定め、4B–14B のタスクプランナーを Jetson Orin 上で INT4 によりローカル実行する
- フロンティア・レーダー|CausGround:相互作用の軌跡から各行動の前提条件と効果を導き、パラメータを更新せずに、凍結したマルチモーダル・プランナーに「扉を開けてから入れる」の一手を補う
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)