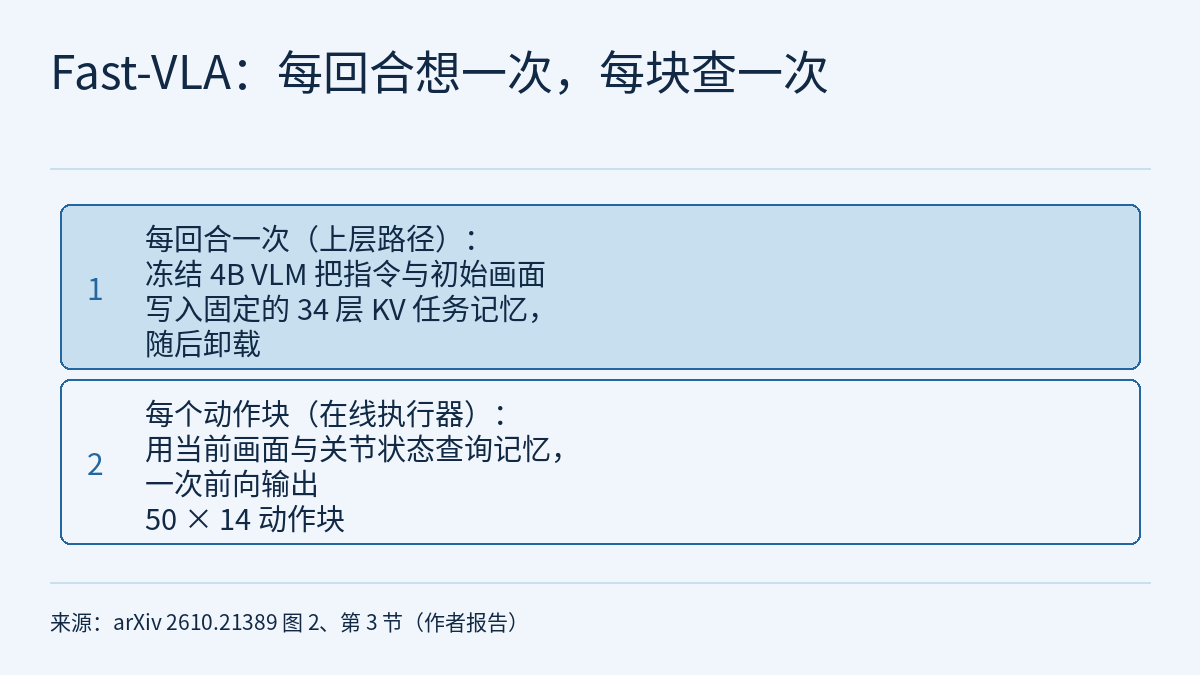
多数 VLA 每预测一个动作块,都要把当前画面和语言指令重新送进数十亿参数的主干,可一个回合里任务本身几乎不变。华为团队的预印本 Fast-VLA(arXiv 2610.21389,2026-10-15)把这两件事拆开:回合开始时,冻结的 4B VLM 只运行一次,把指令和初始多视角画面编码成 34 层的键值(KV)任务记忆,随后离开控制回路;之后每个动作块,由一个轻量的在线执行器结合当前画面和关节状态查询这份固定记忆,一次前向输出整块动作。作者报告,RoboTwin 2.0 Clean / Randomized 成功率为 92.46% / 92.40%,LIBERO 与 LIBERO-Plus 为 95.95% / 79.11%;在同一硬件上,RoboTwin 的摊销推理时间比三个持续调用主干的基线快 10.9–17.1 倍,VLM 卸载后的在线常驻显存为 1.22 GiB。下文看这些倍数各自和谁比、执行器是否真的依赖那份记忆,以及“只想一次”放弃了什么。以下数字均为作者报告 [R],本站未复现;论文的全部实验都在仿真基准上完成。
做法:慢的那部分每回合只跑一次
回合开始时,冻结的 VLM 读入指令 L 和初始多相机画面 I_0,得到任务记忆 M_0。作者用的是 DM0.5(Dexmal 团队)的 4B VLM,保留全部 34 个 Transformer 层的键和值张量;预填充(prefill)结束后 VLM 被卸载,记忆在整个回合中不再更新。附录写明,RoboTwin 配置下这份可复用记忆占 1.22 GiB 在线常驻显存中的 174.6 MiB。
在线执行器由视觉编码器、查询融合、动作解码器和动作头组成,按 RoboTwin 配置:
- 实时输入:当前的头部相机和两路腕部相机画面、头部相机的短历史(偏移 −17、−8、0 帧)以及机器人状态;每路相机各有一个可训练的 DINOv2 ViT-B/14 编码器。
- 查询融合:为未来每一步 τ(0–49)和每只手臂各设一个可学习查询,等于时间嵌入加手臂嵌入。每只手臂的 7 维本体状态和该侧腕部画面的 CLS token 经 MLP 融合成反馈,以门控残差加到查询上,并在之后每个解码层前再次注入。
- 动作解码:4 层解码器,每层依次做自注意力(协调不同时间步与两只手臂)、Cross-Visual 注意力(读取当前和历史画面 token)、Cross-Memory 注意力(从固定记忆中检索任务上下文)和前馈网络。Cross-Memory 中有一个 KV 记忆适配器,为每个解码层学习 34 个记忆层上的 softmax 权重,初始化时偏向深度对齐的那一层。
- 输出:线性动作头一次前向输出 50 × 14 的双臂动作块(50 步绝对关节指令),不做迭代去噪。单臂的 LIBERO 配置输出 10 × 7,不用画面历史。
训练只更新执行器(含视觉编码器),用归一化动作上的 ℓ1 损失;VLM 冻结,其 KV 缓存离线预先算好,训练中反复使用。动作解码器和动作头从零训练,没有用外部动作数据预训练。可训练参数 RoboTwin 为 272.0M、LIBERO 为 184.7M,训练计算约 150 和约 5 个加速器小时。
推理时,每回合一次 VLM 预填充,之后每个动作块一次执行器调用。作者报告的摊销延迟是每个环境步的平均:(T_prefill + ⌈H / K⌉ · T_actor) / H,H 为实际执行步数,K 为动作块长度,按观测到的回合长度计算。
10.9–17.1 倍是和谁比
下表是论文表 2(RoboTwin 2.0)的节选,省略了 X-VLA、LingBot-VLA、Qwen-VLA、Motus 和 Flash-WAM 五行(平均成功率都低于 90%)。“预测/执行”指每次调用预测多少步、执行多少步后重新规划;ms/块是一次动作生成调用的耗时;ms/步是按执行节奏摊销、并计入每回合一次性开销的值。
| 方法 | 预测/执行 | ms/块 | ms/步 | GiB | 平均成功率(%) |
|---|---|---|---|---|---|
| π0 | 50/50 | 72.38 | 1.580 | 6.26 | 62.16(汇编) |
| π0.5 | 50/50 | 80.51 | 1.758 | 6.47 | 79.75(汇编) |
| LingBot-VLA 2.0 | 50/25 | 931.29 | 38.892 | 11.98 | 93.16 |
| DM0.5 | 50/50 | 736.10 | 16.069 | 11.68 | 93.45 |
| LingBot-VA | 32/32 | 9553.12 | 317.765 | 29.59 | 92.20(汇编) |
| Fast-WAM | 32/24 | 564.80 | 24.624 | 23.13 | 91.83 |
| AHA-WAM(ms/块不含每两块一次、111.40 ms 的视频预填充,ms/步已计入) | 16/16 | 553.27 | 39.291 | 28.21 | 92.80 |
| Faster-WAM(Noah,作者自行实现以测成本) | 32/24 | 119.94 | 5.229 | 21.34 | 89.17 |
| Faster-WAM(HUST) | 32/28 | 416.12 | 15.704 | 22.27 | 92.52 |
| Fast-VLA | 50/50 | 44.87 | 1.437 | 1.22 | 92.43 |
Fast-VLA 的第一块耗时 153.74 ms(108.87 ms VLM 预填充 + 44.87 ms 执行器),之后每块 44.87 ms;RoboTwin 平均回合长度 237.3 步,摊销为 1.437 ms/步。论文正文的表述是:在表中平均成功率不低于 90% 且有实测成本的基线里,Fast-VLA 的摊销推理至少快 10.9 倍。这样的基线共六个:LingBot-VLA 2.0、DM0.5、LingBot-VA、Fast-WAM、AHA-WAM 和 Faster-WAM(HUST)。摘要和结论中的 10.9–17.1 倍只取了其中三个(摘要称为“三个持续调用主干的基线”):对 Faster-WAM(HUST)快 10.9 倍,成功率低 0.09 个百分点;对 DM0.5 快 11.2 倍,低 1.02 个百分点,两者重新规划间隔同为 50 步;对 Fast-WAM 快 17.1 倍,高 0.60 个百分点。另外三个基线的倍数更大:按表中的 ms/步,LingBot-VLA 2.0(38.892)、AHA-WAM(39.291)和 LingBot-VA(317.765)分别约为 Fast-VLA 的 27 倍、27 倍和 221 倍(本站换算),所以 17.1 倍不是这六个基线里的上限。论文另称,相对 Faster-WAM(Noah)快 3.6 倍,成功率高 3.26 个百分点。
这个倍数的范围值得注意。表里的 π0、π0.5 同样每次执行 50 步,摊销延迟 1.580 和 1.758 ms/步,只比 Fast-VLA 慢约 1.1 倍和 1.2 倍(本站换算),但平均成功率低得多(62.16% 和 79.75%)。所以“至少 10.9 倍”只适用于平均成功率不低于 90% 的这一组基线,不是对所有 VLA 的提速。
测量条件见附录表 11:VLM 用 BF16,执行器用 BF16 autocast 并关闭梯度;批量 1;3 次预热后计时 10 次取平均,每次计时前后同步设备;计时从原始 uint8 图像开始,包括缩放、归一化和主机到设备的传输;PyTorch 2.7.1+cu128,不用 torch.compile 或 TensorRT;不含 HTTP 通信。本站所读的文本只写“同一硬件”,没有写明设备型号。
另有两点要分开看。一是显存:Fast-VLA 一栏的 1.22 GiB 是 VLM 卸载后的在线常驻值,预填充期间的峰值是 12.11 GiB,注释中另列;所读文本没有写明基线一栏是峰值还是常驻值。二是成功率与成本的来源:基线成功率取自已发表的报告、基准汇编(表中标“汇编”)或作者对已发布检查点的评测,延迟和显存则由作者在统一协议下另行测得,所以同一行的成功率和成本不一定出自同一组运行。
LIBERO 上,Fast-VLA 为 95.95%(标准)和 79.11%(LIBERO-Plus),摊销 3.975 ms/步,常驻 0.86 GiB。与 Faster-WAM(Noah)和 Faster-WAM(HUST)相比,它的 LIBERO-Plus 高 4.11 和 5.54 个百分点,摊销推理快 3.1 和 21.2 倍,但标准 LIBERO 更低(两者为 98.50% 和 99.00%);三者都每 10 步重新规划。LIBERO-Plus 上它比 π0.5 和 DM0.5 低 6.59 和 6.79 个百分点。作者指出这两个基线使用了预训练的动作生成权重,而 Fast-VLA 的动作解码器从零训练;这是作者的说明,论文没有用实验单独检验这一原因。
执行器真的在用这份记忆吗
固定记忆只有在执行器确实读它时才算数。作者在测试时替换记忆内容,执行器权重不变、不重新训练(表 4,RoboTwin 2.0):
| 记忆条件 | Clean(%) | Randomized(%) |
|---|---|---|
| 原始记忆 | 92.46 | 92.40 |
| 替换语言片段 | 35.18 | 29.66 |
| 同一任务、另一回合的记忆 | 6.26 | 8.36 |
| 替换初始画面片段 | 2.64 | 2.62 |
| 另一任务的记忆 | 0.62 | 0.52 |
替换初始画面片段比替换语言片段跌得更多;用同一任务另一回合的记忆,成功率也只剩个位数。作者据此认为执行器依赖与当前回合匹配的记忆。本站的读法是:这份记忆承载的不只是“做什么任务”,还有这一回合初始场景的信息。替换是对冻结执行器的测试时干预,说明执行器的输出依赖记忆内容,但不说明它从记忆里读到了哪些具体信息。
记忆怎样构建也有影响(表 5,LIBERO,每个变体单独重新训练执行器):没有任务记忆(常数零 KV)时为 69.90% / 53.69%(标准 / LIBERO-Plus);只保留图像条件下的文本 token KV 为 93.20% / 73.84%;只用最后一层为 94.70% / 73.70%;完整的 34 层指令加画面 KV 为 95.95% / 79.11%。
在线输入同样关键(LIBERO,各变体单独重新训练):去掉腕部画面降到 65.60% / 33.49%,只用头部相机为 70.80% / 30.80%,只用腕部相机为 87.10% / 68.72%,去掉本体状态为 94.30% / 72.41%,去掉头部相机为 92.70% / 74.54%。在标准 LIBERO 上,去掉腕部画面(65.60%)和去掉任务记忆(69.90%)的损失相近。作者把腕部画面称为闭环反馈的关键来源。这组数据在论文表 6 中,正文写作“Table 7”。
只想一次放弃了什么
作者用“最后一层记忆”变体比较了记忆刷新频率(表 8,LIBERO,每种方案各自匹配训练;摊销成本计入每块 34.25 ms 的执行器调用和每次构建记忆的一次 VLM 预填充):
| 刷新方案 | 每回合 VLM 调用 | 摊销 ms/步 | 标准(%) | LIBERO-Plus(%) |
|---|---|---|---|---|
| 每个动作块 | 17.37 | 12.391 | 96.50 | 72.47 |
| 每 2 块 | 8.93 | 8.052 | 95.95 | 70.63 |
| 每 4 块 | 4.74 | 5.898 | 95.95 | 68.24 |
| 每回合一次 | 1.00 | 3.975 | 94.70 | 73.70 |
每块刷新让标准 LIBERO 高 1.80 个百分点,LIBERO-Plus 低 1.23 个百分点,VLM 调用多 17.37 倍,摊销时间多 3.12 倍。作者据此认为每回合构建一次是成功率与 VLM 计算之间的高效折中。这组比较只在 LIBERO、只用最后一层记忆变体完成;论文没有解释刷新为什么让 LIBERO-Plus 下降。
记忆编码器也可以换(表 9,LIBERO,执行器结构不变,记忆为每回合存储的 bf16 KV 缓存):PaliGemma v1 为 9.8 MB、95.35% / 73.15%;π0.5 为 9.8 MB、94.90% / 71.48%;Qwen2.5-VL-7B 为 31.8 MB、95.35% / 75.55%;默认的 DM0.5 为 79.7 MB、95.95% / 79.11%。标准 LIBERO 上四者相差不到 1.1 个百分点,差别主要在 LIBERO-Plus。
任务长度方面(表 7,RoboTwin 2.0 按官方步数预算分组),Fast-VLA 在短、中、长三组上为 94.00%、90.27%、90.25%,三组分别有 29、15、6 个任务。put_bottles_dustbin 的步数预算为 1,700 步,最多允许 34 次执行器调用共用同一份记忆,成功率 87.00%。
还有一个时间粒度问题。RoboTwin 配置每次预测 50 步并全部执行后才重新规划,也就是说执行器每 50 个环境步才读一次新观测;LIBERO 为每 10 步。所读文本没有给出环境步对应的控制频率,所以无法换算成秒。作者写明的局限是:记忆在回合开始时构建并保持固定,回合中途任务目标改变或出现新指令的情形尚未研究;他们提出可以结合事件触发的记忆更新和高层重规划。
和站内已有内容的关系
物理AI实验室 0.3:看-想-动讲过“慢慢想清楚”和“飞快出动作”两套系统,以及 π0 论文中的机器人每执行 25 步、约 0.5 秒重新推理一次。Fast-VLA 把慢的那套推到每回合一次,执行器仍按动作块重新规划:RoboTwin 每 50 步,LIBERO 每 10 步。0.3 的规则在这里同样适用:一个频率或间隔只属于给出它的那个系统和配置。
前沿雷达|Fast Plans, Faithful Actions报道的预印本发现,在 π0.5 派生的分层 VLA 中擦除计划终点并不影响成功率,即执行器没有真正使用上层计划。Fast-VLA 的记忆替换回答的是同类问题:下游模块到底读不读上游给的上下文。两篇论文的系统和基准不同,数字不能直接比较,但这类干预测试值得在任何“上层只算一次或少算”的设计中检查。
前沿雷达专题|边缘与实时性梳理过延迟预算的花处。读 Fast-VLA 的 ms/步时要注意,它是摊销值,取决于预测/执行步数和回合长度;关心单次反应时,应看 ms/块和 153.74 ms 的第一块。基线成功率和成本来源不同这一点,可以对照物理AI实验室 1.8:评测的问法逐项核对。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],作者来自华为技术有限公司和华为中央研究院。本站没有复现任何结果。
- 所读文本中的实验全部在仿真基准(RoboTwin 2.0、LIBERO、LIBERO-Plus)上完成,没有真机实验;仿真结果不是硬件安全验证。
- Fast-VLA 用 DM0.5 的 4B VLM 构建记忆,DM0.5 本身也是对照基线之一。
- 基线成功率来自已发表报告、基准汇编或作者对已发布检查点的评测,延迟和显存由作者另行测量;Faster-WAM(Noah)的成本来自作者自己的实现。所读文本没有写明测量设备的型号,也没有给出置信区间。
- 摊销延迟依赖回合长度和执行步数;1.22 GiB 是卸载 VLM 后的常驻值,预填充峰值为 12.11 GiB。
- 记忆来自初始观测并在回合内固定;记忆构建、在线输入和刷新频率的消融都只在 LIBERO 上进行,刷新比较用的是最后一层记忆变体。
- 论文正文把在线输入消融引为“Table 7”,数据实际在表 6;本文按表中数据引用。