多数 VLA 只看当前这一帧,就预测接下来的一段动作。来自 Kyutai、Inria 与法国国立路桥学校(École nationale des ponts et chaussées)的作者在预印本 REKI(arXiv 2610.22178,2026-10-15)里加了一种代价很小的记忆:流匹配动作专家里每帧放 32 个寄存器 token,概括这一帧 VLM 的输出,它们的键值留在专家缓存里,供后面两帧读取。作者报告,这个只用公开数据预训练的 2.4B 模型在 LIBERO-Plus 和 RoboTwin Clean2Rand 上领先所比较的公开数据 VLA;记忆在推理时增加的耗时不到 1%,手臂在两个位姿之间来回振荡的回合约少到四分之一。本文重点看这个振荡现象怎么定义、怎么测、作者怎么解释,再看基准、延迟和真机数字各自的条件。以下数字均为作者报告 [R],本站未复现。
做法:记忆放在动作专家里,VLM 每帧只编码一次
REKI 由 VLM 和动作专家两部分组成。VLM 是 Qwen3.5-2B,把提示和各路相机画面打包成一个序列,取最后一层隐状态作为编码上下文;提示里除了语言指令,还写明本体、控制模式、控制频率和分箱后的回合长度。动作专家有 10 个块、宽度 768,用交叉注意力读取编码上下文;机器人状态经池化后通过自适应归一化调制专家。推理时从噪声出发做 10 步欧拉积分,生成一个动作块。
记忆的做法是:每帧在专家的输入流里放 n_r = 32 个可学习的寄存器 token,排在带噪动作 token 前面。论文写明的注意力规则有三条:
- 寄存器交叉注意这一帧的编码上下文,并自注意之前各帧的寄存器;
- 动作 token 读取当前帧和过去帧的寄存器以及动作 token 自身;寄存器从不读取动作 token;
- 寄存器的键值保存在专家缓存中,缓存是覆盖前 K − 1 帧的滚动窗口,K = 3;新一帧进入时,最旧一帧的寄存器被丢弃。
寄存器不读动作 token,也跳过自适应归一化,所以只取决于观测,与流时间和机器人状态无关。论文由此得出成本上的两点。推理时,当前帧的寄存器在第一步欧拉积分中算出,其余九步复用;VLM 仍然每帧只处理当前画面,编码器成本与无记忆策略相同。训练时,一个样本是同一回合中按 1 秒间隔取出的 K 帧,打包成一个批次一次前向,没有需要逐步展开的循环;每一帧都有自己的动作块损失,一个 K 帧窗口给出 K 个训练信号。论文还指出,训练时每个窗口独立处理,而推理时缓存的寄存器本身是用更早帧的寄存器算出的,信息可以留存到窗口之外。
论文图 2 把这种做法和三类已有方案并列:把过去帧和当前帧一起送进 VLM,成本随窗口增长(至少在视觉编码器上);在主干或头部维护逐步读写的循环状态,训练时要逐步展开;额外加一个记忆模块。作者称,推理时记忆带来的额外耗时不到无记忆模型(K = 1)预测时间的 1%。
预训练数据全部公开:遥操作机器人数据(RoboSet、Galaxea、AgiBot World 2026、RoboCOIN、RoboMIND、RDT-1B、DROID、BridgeData V2 以及 Open X-Embodiment 中的 12 个数据集等)、运动规划生成的仿真数据,约 35 万个回合、1.7 亿帧的第一视角人类操作视频,以及视觉-语言数据(占训练样本的 10%)。各数据集保留自己的控制约定,不映射到统一的动作空间。模型在 32 块 H100 上预训练 20 万步,全局批量 2,880,然后在每个基准上分别微调。
振荡:同一套权重,去掉记忆后比例从 4.1% 升到 14.8%
论文第 6.2 节把振荡定义得很具体:对每只手臂,比较它在这一动作块里的运动方向和上一块的方向,忽略小幅移动;如果一只手臂连续三个或更多动作块都朝大致相反的方向运动,也就是至少来回两次,这个回合记为振荡。统计在 RoboTwin Clean 上进行,50 个任务、每个任务 20 个配对种子。作者在其中 16 个任务上确定这一判据,再在其余 34 个任务上确认了记忆的作用。振荡回合中成功的不到 5%。
| 条件(训练窗口 → 评测窗口) | 振荡回合占比 |
|---|---|
| K = 3 训练,K = 3 评测(3 → 3) | 4.1% |
| 同一权重,评测时只给 1 帧过去画面(3 → 2) | 4.6% |
| 同一权重,评测时去掉过去帧(3 → 1) | 14.8% |
| 不带记忆训练与评测(1 → 1) | 18.6%(失败回合中有一半振荡) |
“约少四倍”取决于和哪个无记忆条件比:14.8 / 4.1 ≈ 3.6,18.6 / 4.1 ≈ 4.5(本站换算)。差别在双臂任务上最大。双臂任务中最常见的循环是“换臂”:一只手臂伸出时另一只收回,1000 个回合里不带记忆时出现 65 次,带记忆时 1 次;它通常在一次松开物体后几秒开始。作者也写明,记忆没有救回所有这些回合:在无记忆策略会振荡的种子上,带记忆的策略成功率为 45%。
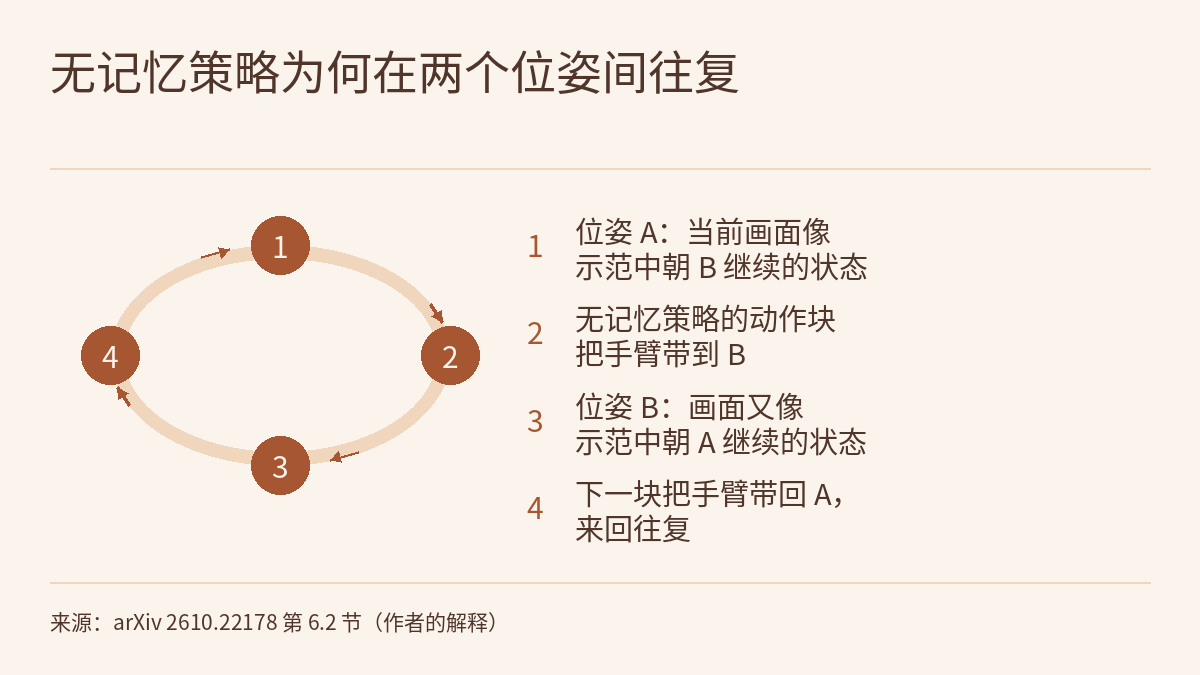
作者的解释是感知混叠(perceptual aliasing)。无记忆策略只把当前观测映射到下一段动作;如果位姿 A 和 B 都像示范中朝对方继续运动的状态,在 A 预测的动作块会把手臂带到 B,在 B 预测的又会把它带回 A。一小段历史就能消除歧义,因为刚从 B 过来的窗口不再匹配朝 B 移动的示范。这是作者的归因,依据的是强化学习文献中关于感知混叠的经典工作;所读文本给出的是振荡比例的变化,没有直接检验这一机制的实验。论文还提到,时间集成和双向解码也能缓解动作块之间的切换,但需要额外的策略查询,而 REKI 的记忆不需要。
同一组消融也比较了成功率(论文图 5;LIBERO-Plus 为在 LIBERO 上微调后的评测):
| 条件 | LIBERO-Plus | RoboTwin Clean | RoboCasa365 |
|---|---|---|---|
| 3 → 3 | 90.4 | 73.4 | 38.4 |
| 3 → 2 | 90.1 | 73.6 | 39.3 |
| 3 → 1 | 88.9 | 67.2 | 34.9 |
| 1 → 1 | 88.9 | 67.9 | 33.0 |
大部分收益来自第一帧过去画面。由于窗口中每一帧都有损失,带记忆微调的模型也学会了在没有记忆时行动:去掉记忆评测(3 → 1)时,成绩接近直接按 K = 1 微调的模型。作者据此认为,收益主要来自推理时读取过去帧,而不是在窗口上训练本身。
基准:领先的范围是“公开数据预训练的 VLA”
论文的主结论是在性能与模型大小之间设定了新的帕累托前沿:LIBERO-Plus 上得分最高,RoboTwin Clean2Rand 和 RoboCasa365 上只被大约两倍大的模型超过。读这些数字时要注意比较范围:
- 分布外:LIBERO-Plus 90.4,比次优的公开数据 VLA InternVLA-A1.5(84.8)高 5.6 个百分点;Clean2Rand 比 ABot-M0(55.7)高 10.1 个百分点,即 65.8(本站换算)。Clean2Rand 只在干净场景上微调,在六种条件下评测(干净场景、四种随机化各自单独、四种同时),取平均。RoboCasa365 训练中未见过的组合任务上,REKI 为 14.1,与 Qwen-RobotManip(14.9)相当,低于 Xiaomi-Robotics-1(32.1)。
- 分布内:RoboCasa365 38.4,高于 RLDX-1(36.0)和 Qwen-RobotManip(35.9);RoboCasa-GR1 58.6,与 RLDX-1(58.7)、ABot-M0(58.3)相当;LIBERO 97.5,多数模型在 97.6–99.4 之间;RoboTwin 85.9 / 84.6,低于同等大小的 InternVLA-A1.5(93.3 / 93.0)。作者指出后者在训练中另有视频生成模型监督,并采用更复杂的多阶段预训练。
- 比较对象:基线数字取自已发表的结果。在内部数据上预训练的更大模型(Qwen-RobotManip、RLDX-1、Xiaomi-Robotics-1)和基于视频生成模型的 ABot-M0.5,作者明确说只作为当前上限的参考,不是同条件比较。
预训练的作用:从零训练时 Clean2Rand 为 52.0、LIBERO-Plus 为 86.1;预训练在分布外加 13.8 和 4.3 个百分点,在分布内对 RoboTwin 加 2.9 和 0.8、对 LIBERO 加 1.0。训练设置对鲁棒性影响也很大:在 LIBERO-Plus 上关闭相机随机丢弃或图像增强,相机视角变化下的成功率下降超过 20 个百分点;关闭状态丢弃,初始机器人状态变化下下降 8.1 个百分点。
延迟与真机:21.8 ms 和 7–37.5 个百分点各自的条件
延迟测的是一次调用,从原始观测到反归一化后的一个动作块,包括预处理和主机-设备传输;输入为两张 256 × 256 图像、机器人状态和固定提示,批量 1,使用各模型发布的检查点与推理代码,每个值是 320 个动作块、三次重复的中位数。REKI 的 VLM 预填充和专家各编译成一个 CUDA 图,K = 3 时预测一块(10 个动作)耗时 21.8 ms,在所比较的模型中最低:X-VLA 25.5 ms、openpi 版 π0.5 33.8 ms、ABot-M0 46.1 ms、InternVLA-A1.5 51.3 ms。X-VLA、ABot-M0、InternVLA-A1.5 和 ABot-M0.5 的编译路径由作者自行构建,作者称没有改变它们的计算。不编译时,REKI、π0.5 和 ABot-M0 为 118–139 ms,InternVLA-A1.5 为 352 ms,X-VLA(0.9B)为 51 ms。
GPU 时间方面,REKI 每块 16.5 ms,与 X-VLA(16.1 ms)相当。在图 5 那次测量中,VLM 预填充 9.5 ms、欧拉步 8.1 ms,读取缓存的寄存器增加 0.1 ms。附录表 10 的另一次测量里,REKI 的欧拉步为 8.2 ms,InternVLA-A1.5 为 34.9 ms,作者把差别归于后者更大的动作专家(24 层 0.5B 对 10 层 0.2B)。21.8 ms 是单块 H100、这组输入下的值,不是控制频率;论文指出,它约束策略对新观测的反应速度和重新规划的频率。
真机实验用一台 6 自由度 UR5 机械臂,配 Weiss WSG50 夹爪和 UMI 式平行夹指,动作回路 15 Hz;一台固定的 Orbbec Femto Mega RGB 相机,观测为一张 RGB 图像和 7 维绝对关节状态。五个任务涵盖拾取、放置、堆叠和清扫,每个任务用 Meta Quest 控制器采集 50 段训练示范,评测 10 个回合,每回合随机摆放物体并加入干扰物。REKI 和 π0.5 都从预训练检查点微调 3,000 步,全局批量 360,学习率 5 × 10⁻⁵,只训练最后四个视觉编码器块。结果:REKI 在五个任务上比 π0.5 高 7 到 37.5 个百分点;去掉记忆后,两个较短任务不变(65 对 65,57.5 对 57.5),三个较长任务下降 12 到 17.5 个百分点。
这里有两点要分开看。一是两者的动作块长度不同:π0.5 为 50 步(3.3 s),由其预训练固定;REKI 为 30 步(2 s)。所以 REKI 与 π0.5 的差距不能全部归因于模型本身。二是每个任务只有 10 个评测回合,得分包含部分完成的分数,所读文本没有给出置信区间。作者称,微调 REKI 在真机任务上用 8 个 H100 GPU 小时,在各基准上用 40 到 400 个。
和站内已有内容的关系
物理AI实验室 1.6:模仿学习讲过行为克隆只看当前观测、误差会把机器人带出示范覆盖范围,也讲过 ACT 的动作分块与时间集成。REKI 的振荡分析补上了另一种失败:误差不一定越滚越远,也可能在两个看起来相似的状态之间来回打转。按论文的说法,时间集成这类方法要多次查询策略,REKI 用的是几帧记忆。
前沿雷达|Fast-VLA同样把 KV 缓存当作记忆,但方向相反:Fast-VLA 每回合只调用一次 VLM,存成回合内固定的 KV 任务记忆;REKI 每帧都运行 VLM,记忆是动作专家里覆盖最近几帧的滚动寄存器。两篇论文的基准和硬件不同,数字不能直接比较。
物理AI实验室 2.3:微调 SmolVLA用的是另一个开放 VLA;REKI 论文把 SmolVLA 列为在公开数据上发布完整流程的前作之一。2.3 里“一个数字只描述测出它的模型、平台和设置”的规则,同样适用于 REKI 的 21.8 ms 和真机分数。REKI 的预训练混合了机器人遥操作、第一视角人类视频和视觉-语言数据,这几条来路在单位与动作空间上的差别,可以对照物理AI实验室 1.5:数据从哪来。振荡判据先在 16 个任务上确定、再在另外 34 个任务上确认,每个任务 20 个配对种子,这种做法可以用物理AI实验室 1.8:评测里配对与留出的问法来读。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R]。本站没有复现任何结果。
- 论文称发布了从数据整理到部署的全部代码以及预训练和微调权重,给出的地址是
github.com/kyutai-labs/reki;本站没有核对该仓库的内容和许可证。 - 基线成绩取自已发表的结果,延迟由作者在统一协议下测量,部分基线的编译路径由作者自行构建。与内部数据模型的对比只是参考。
- 振荡判据由作者定义(连续三块以上反向),只在 RoboTwin Clean 上统计;感知混叠是作者的归因,不是单独验证过的机制。
- 记忆窗口只有 3 帧、间隔 1 秒。作者认为几秒的记忆对标准基准上的多数任务已经足够,但寄存器能否承载依赖很久以前事件的长上下文,仍有待检验。
- 真机部分只有一个 UR5 平台、五个任务、每个任务 10 个回合,得分含部分完成;与 π0.5 的动作块长度不同。仿真结果和这组真机评测都不是硬件安全验证。
- 本文依据论文 HTML 正文(到参考文献前段),没有读附录中的完整表格。
链接
- REKI: Registering Knowledge in VLAs(arXiv 2610.22178)
- 论文 HTML 全文
- 物理AI实验室 1.6:模仿学习,手算误差怎样滚出示范覆盖范围,再把 ACT、扩散策略与数据规模律的数字放回各自条件
- 物理AI实验室 2.3:微调 SmolVLA,为一句指令配好示范数据,核对每个数字的口径,再给异步动作队列算时间账
- 物理AI实验室 1.5:数据从哪来,从 SO-101 元数据算出示范时长,再分清三条来路的单位与动作空间
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 前沿雷达|Fast-VLA:每个回合只让 4B VLM 想一次,执行器每块动作都去查固定的 KV 任务记忆
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)