动作分块让 VLA 一次生成一段未来动作,从而少调用几次大模型;可这一段执行多长再重新看一眼世界,是另一个独立的决定:执行得短,查询次数多;执行得长,环境变了也不知道,执行误差还会累积。署名首尔国立大学、KAIST 与 Dnotitia 的预印本(arXiv 2610.21434,2026-10-15)提出 policy-aligned predictive verifier(PAV):执行之前,先在 VLA 自己的任务条件表征空间里预测每个候选前缀会把机器人带到什么状态,再估计从那里还能否完成任务,据此选择执行长度。作者报告,LIBERO 上用 π0.5(动作块长 H = 50)时,平均成功率比固定执行 5 步高 7.50 个百分点,查询次数少 63.3%;三项真机任务平均成功率 74.4%,最好的固定执行长度为 41.1%。下文看它怎样从只有“成功 / 失败”的回合结果里学出逐段判断、和谁比,以及在哪些对照下收益变小。以下数字均为作者报告 [R],本站未复现。
问题:一个动作块该执行多长
设策略 π 在时刻 t 根据观测和指令生成长度为 H 的动作块。选择执行长度 h,就是只执行前 h 个动作,h 步之后拿到新观测、再查询策略。论文把它概括为推理成本、时间一致性与响应性之间的权衡。固定执行长度对所有动作块和状态用同一个 h;自适应执行则每次重新决定。
论文把已有的自适应方法按所用信号分成两类:
- 生成稳定性:用策略内部信息判断。AutoHorizon 从动作自注意力估计执行上限;A3 用动作共识和重解码稳定性选择执行长度,即把块内其他动作固定为上下文后重新生成某个动作,看它是否保持一致;DVAC 也归入这一类,按其标题是用去噪方差决定何时重新规划。
- 预测一致性:执行过程中比较动作条件下的预测与实际观测。VLA-Corrector 在预测与观测的视觉动态持续偏离时截断并重新规划;CheckVLA 把预测与观测的差异和失败风险联系起来。
论文的论点是:这两类信号本身都不能说明执行某个前缀之后任务还能否完成。图 1 的例子中,一次抓空、任务失败时,生成稳定性和预测一致性仍然很高;作者提出的“提议有效性”(proposal validity)更早触发重新规划,这个例子最终成功。这是作者挑选的单个示例,说明信号可能失效,不说明这种情况出现得有多频繁。
做法:先预测后果,再验证能否继续
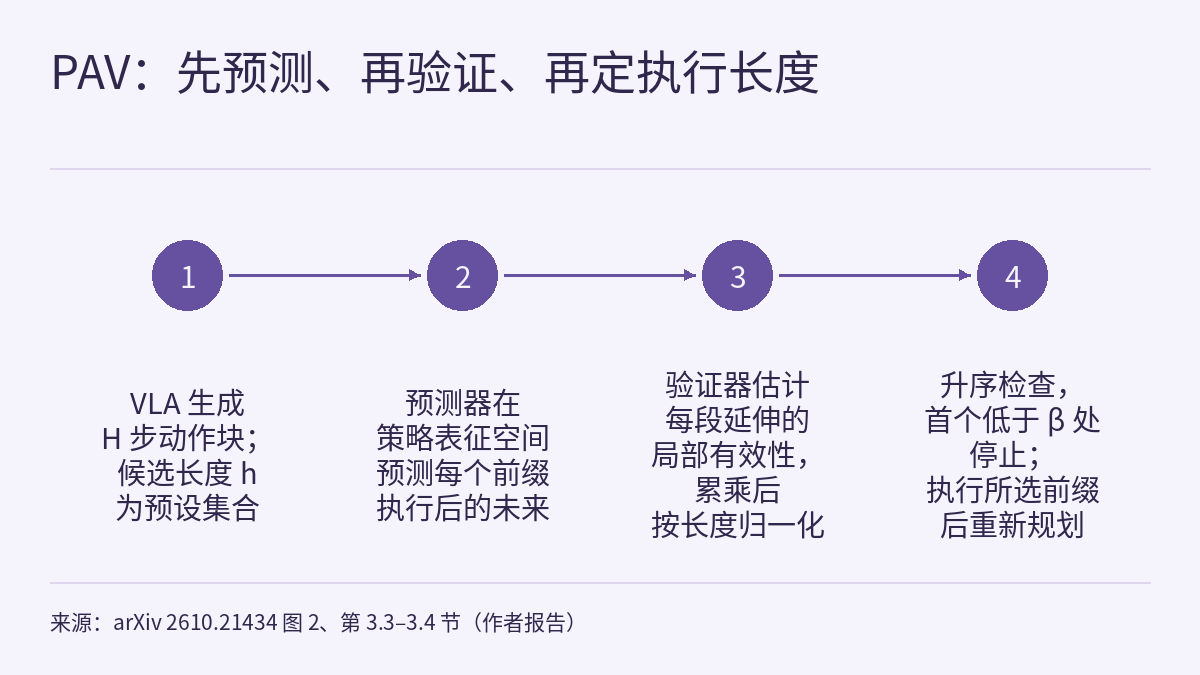
决策目标。提议有效性 V_t(h) 定义为:执行一个固定提议的前 h 个动作后,策略 π 仍能成功完成任务的概率,并要求每一次延伸之后都保持“可完成”。这样定义的集合是前缀封闭的:一条可完成的轨迹,它更短的前缀也可完成。所以 V_t(h) 可以写成 V_t(h−1) 乘以“第 h 步延伸仍可完成”的条件概率。论文再把这个条件概率拆成两步:预测执行后的未来表征,再验证这个表征是否支持成功继续。
预测器。表征 z_t 由策略自己的编码器从观测和指令中提取。预测器 f_θ 输入 z_t 和前 h 个动作,输出 h 步后的预测表征,训练目标是实际执行之后观测的编码。损失有两项:与真实未来表征的余弦距离;以及动作替换排序,即同一任务另一段动作前缀的预测必须比实际执行的那段离目标远出一个间隔 m,被替换的动作不标为失败。
验证器。验证器 q_φ 只读预测出的未来表征,输出 0 到 1 之间的局部有效性 q;各段的 q 连乘得到前缀得分,用来近似 V_t(h)。
从回合结果学逐段判断。训练回合只有最终的成功或失败,没有逐段标签,而失败回合里也可能有有效的前缀。论文把逐段有效性当作隐变量:成功回合把每个因子都往上推,并按段数平均,避免长回合权重过大;失败回合只把整个乘积往下压,不给每一段都标失败。但模型也可以把失败回合里每一段都压低一点来拟合,连有效段也一起压低。为此论文加了一个定位先验:在失败回合上惩罚 Σ(1 − q_i)。乘积固定时,最小化这个和会把下降集中到少数几段。
用一个本站构造的假想例子说明:一个失败回合有 10 段,要把乘积压到 0.5。方案一平均分摊,每段 q = 0.5^(1/10) ≈ 0.933,Σ(1 − q) ≈ 0.67;方案二只压一段,那段 q = 0.5、其余 q = 1,Σ(1 − q) = 0.5。两者的轨迹级失败损失相同,定位项偏向方案二,其余 9 段保留高分。这只是说明机制的算术,不是论文的数据。
选执行长度。部署时按块数的平方根对累积得分做长度归一化,避免得分只因连乘次数多而偏向短前缀。然后按长度从短到长检查候选,遇到第一个低于阈值 β 的得分就停下,执行此前最长的那个前缀,执行完再从新观测查询策略。归一化后的得分不一定单调,这条规则防止越过前面的不合格点。假想例子:β = 0.9,h = 5、10、15、20、25 的得分依次为 0.97、0.94、0.91、0.88、0.92,结果选 h = 15;h = 25 虽然高于 0.9,也不会被接受。
实现(π0.5、LIBERO、H = 50 的配置)。从策略的 PaliGemma 语言模型取动作去噪之前的最终前缀隐藏状态,分别做掩码均值池化、掩码最大池化并取最后一个非填充 token,各 2,048 维,再拼接 32 维状态,共 6,176 维,投影到 128 维;VLA 参数保持不变。50 × 7 的动作序列切成 10 块、每块 5 步,由 GRU 递推,一次展开即可评估 10 个候选长度。验证器不读动作嵌入,也不读 GRU 隐状态,动作信息只经由预测的后果进入得分。整个模块 2,011,208 个参数,其中包括一个只在训练时使用的完成度预测头。训练数据为 4 个 LIBERO 套件共 40 个任务、每个任务 150 个回合,共 6,000 个,每次查询时执行长度从 {5, 10, …, 50} 中均匀随机抽取;按初始状态划分为 4,200 / 840 / 960 个训练、验证、测试回合。阈值 β = 0.9,定位项权重 0.01,替换排序间隔 0.1。作者称“据我们所知”,这是首个把前缀条件的未来预测与提议有效性估计结合起来、用于自适应动作块执行的方法。
结果:和谁比、用了多少次查询
每生成一次动作块计一次查询,表中的查询数为每回合平均值。LIBERO 每个仿真任务 50 次试验。下表节选论文表 1(Spatial、Object、Goal、Long 四个套件的平均成功率),标 † 的是引用的已发表结果,协议可能不同。
| 设置 | 方法 | 平均成功率(%) | 查询 / 回合 |
|---|---|---|---|
| π0,H = 50 | 固定 h = 5 | 92.10 | 34.6 |
| π0,H = 50 | 固定 h = 10 | 93.05 | 17.2 |
| π0,H = 50 | 固定 h = 50 | 76.05 | 4.4 |
| π0,H = 50 | AutoHorizon | 94.05 | 10.6 |
| π0,H = 50 | PAV | 94.30 | 12.3 |
| π0.5,H = 10 | 固定 h = 10 | 97.50 | 16.1 |
| π0.5,H = 10 | AutoHorizon | 97.8 | 27.8 |
| π0.5,H = 10 | A3 | 97.55 | 16.4 |
| π0.5,H = 10 | DVAC † | 98.00 | 18.6 |
| π0.5,H = 10 | VLA-Corrector † | 97.80 | 未报告 |
| π0.5,H = 10 | PAV | 98.10 | 16.8 |
| π0.5,H = 50 | 固定 h = 5 | 87.15 | 38.1 |
| π0.5,H = 50 | 固定 h = 10 | 87.45 | 19.2 |
| π0.5,H = 50 | 固定 h = 50 | 56.80 | 5.4 |
| π0.5,H = 50 | AutoHorizon | 94.45 | 12.7 |
| π0.5,H = 50 | PAV | 94.65 | 14.0 |
三组设置中 PAV 的平均成功率都最高。相对固定长度,差距在 π0.5、H = 50 时最明显:比 h = 5 高 7.50 个百分点(94.65% 对 87.15%),查询从 38.1 降到 14.0,少 63.3%;一次执行完整 50 步只有 56.80%。H = 10 时只有 5 和 10 两个候选,PAV 从 97.50% 升到 98.10%,查询 16.8 对 16.1。
相对最强的自适应基线 AutoHorizon,差距小得多:π0、H = 50 时高 0.25 个百分点,但查询更多(12.3 对 10.6);π0.5、H = 50 时高 0.20 个百分点,查询 14.0 对 12.7。表中没有置信区间,本站不把这么小的差距读成优劣。附录另做了查询量相近的比较:β = 0.91 时 PAV 为 89.45%、19.7 次查询,固定 h = 10 为 87.45%、19.2 次,高 2.00 个百分点。π0.5 的 H = 50 用的是另行以 H = 50 微调的检查点,作者写明检查点差异使动作块长度的影响无法单独分离。
RoboTwin 2.0 上用 π0.5、默认 H = 32,固定长度 h ∈ {4, 8, 20, 32},每个任务 50 个评测回合(表 2):
| 方法 | 16 任务子集成功率(%) | 16 任务子集查询 | 全部 50 任务成功率(%) | 全部 50 任务查询 |
|---|---|---|---|---|
| 固定 h = 4 | 17.38 | 181.3 | 27.40 | 136.5 |
| 固定 h = 8 | 46.75 | 75.0 | 55.76 | 54.5 |
| 固定 h = 20 | 47.88 | 28.2 | 55.16 | 20.8 |
| 固定 h = 32 | 35.38 | 19.7 | 43.64 | 14.6 |
| DVAC † | 41.6 | 未报告 | 未报告 | 未报告 |
| PAV | 54.13 | 59.8 | 58.64 | 58.5 |
在 DVAC 使用的 16 个任务子集上,PAV 为 54.13%,最好的固定长度 h = 20 为 47.88%,DVAC 引用值为 41.6%;全部 50 个任务上,PAV 为 58.64%,最好的固定长度 h = 8 为 55.76%。查询次数要一起看:16 任务子集上 PAV 每回合 59.8 次,约为 h = 20(28.2 次)的 2.1 倍(本站换算);全部 50 个任务上与 h = 8 相近(58.5 对 54.5)。附录写明:RoboTwin 验证器用 β = 0.91 并带任务嵌入,与 LIBERO 配置不同;h = 32 基线来自单独一次评测,回合初始条件不保证与其他方法配对;DVAC 是在其已发表的 H = 50 策略与评测协议下的外部参考值。RoboTwin 表中没有 AutoHorizon 或 A3。
真机实验用 7 自由度 Franka Panda,配前方、腕部、右侧三路 RGB 相机。每个任务都从 π0.5 基础检查点出发、用遥操作示范微调(H = 50),再采集机器人回合训练验证器。三项任务是把橙色方块放进托盘(Place Cube in Tray)、把它叠到绿色方块上(Stack Cubes)、按下红色急停按钮(Press Button),物体位置在 50 cm × 50 cm 的工作区内随机,每个任务 30 次试验(表 6):
| 方法 | Place Cube in Tray(%) | Stack Cubes(%) | Press Button(%) | 平均成功率(%) | 平均重新规划次数 | 平均执行长度 |
|---|---|---|---|---|---|---|
| 固定 h = 5 | 16.7 | 10.0 | 23.3 | 16.7 | 69.58 | 5.00 |
| 固定 h = 10 | 66.7 | 16.7 | 40.0 | 41.1 | 36.54 | 10.00 |
| 固定 h = 30 | 23.3 | 43.3 | 53.3 | 40.0 | 11.97 | 30.00 |
| 固定 h = 50 | 26.7 | 33.3 | 50.0 | 36.7 | 6.91 | 50.00 |
| PAV | 80.0 | 66.7 | 76.7 | 74.4 | 12.87 | 30.22 |
PAV 三项都最高,平均 74.4%;最好的固定长度 h = 10 为 41.1%,平均重新规划 36.54 次,PAV 为 12.87 次。与重新规划次数相近的 h = 30(11.97 次)相比,平均成功率从 40.0% 升到 74.4%,而 PAV 的平均执行长度为 30.22 步。作者据此认为,收益来自随情况改变执行长度,而不是换一个固定长度。需要注意:真机表只有固定长度基线,没有自适应方法;每个任务 30 次,表中没有置信区间;所读正文没有给出真机验证器的训练回合数(相关细节在附录 E,本站所读文本不含)。表中固定 h = 5 平均只有 16.7%,远低于 h = 10,所读文本没有解释原因。
消融:哪些部件在起作用,阈值有多敏感
以下分析都在 LIBERO、π0.5、H = 50 上进行,使用同一策略检查点和同一批回合数据(表 3、表 12):
| 变体 | 平均成功率(%) | 查询 / 回合 |
|---|---|---|
| Direct:不预测未来,直接用当前表征与动作打分 | 84.55 | 22.3 |
| 在 DINOv2 特征空间里预测 | 87.00 | 22.2 |
| 去掉未来对齐损失 | 85.30 | 23.99 |
| 去掉动作替换排序 | 85.70 | 24.26 |
| 去掉定位先验 | 83.65 | 25.60 |
| 完整 PAV | 94.65 | 14.0 |
完整方法比每个变体高 7.65 到 11.00 个百分点,查询也更少。和 DINOv2 的对比保留了同样的预测-验证流程,只换表征空间,作者据此认为保留任务条件信息有助于评估提议。预测器是否真的看动作:在留出回合上固定当前输入和观测目标,用实际执行的动作时,预测与真实未来的余弦相似度为 0.9401,换成同任务另一段动作为 0.5304,倒序为 0.4816,全零为 0.4103;按预测长度分别统计,实际动作给出更近预测的样本对占 89.3%–95.2%。
阈值则相当敏感。表 11 固定训练好的验证器、只改 β。表注写明,扫描中的查询数按总选择次数除以 2,000 个回合计算,而默认行沿用正文主结果中的 PAV 数据(“the default row uses the PAV results from the main paper”),所以 β = 0.90 的 94.65% 不是与其余四行同一轮扫描得到的:
| β | 平均成功率(%) | 查询 / 回合 | 平均执行长度 |
|---|---|---|---|
| 0.88 | 82.75 | 13.8 | 15.200 |
| 0.89 | 85.65 | 15.1 | 13.443 |
| 0.90(默认) | 94.65 | 14.0 | 12.783 |
| 0.91 | 89.45 | 19.7 | 9.685 |
| 0.92 | 88.30 | 25.1 | 7.614 |
与默认行相比,β 只差 0.01 的各行平均成功率低 5.20 到 9.00 个百分点,看上去默认值处是一个窄峰;但这个降幅和“窄峰”都是扫描各行与另一轮运行所得默认行之间的比较,不是同一轮扫描内部的对照。所读文本没有说明 β = 0.90 是怎样选定的,也没有说明选定时是否使用了独立于评测回合的数据;把方法搬到新任务或新策略时,这个阈值值得单独核对。
开销方面,四种策略与动作块配置下,验证器的 GPU 计算时间为 0.90–2.49 ms,是动作生成时间(180.34–216.95 ms)的 0.45%–1.24%。作者写明这是 GPU 计算时间,不是端到端控制回路延迟。
和站内已有内容的关系
物理AI实验室 0.3:看-想-动介绍过 π0 论文中以 50 Hz 运行的机器人每执行 25 个动作、约 0.5 秒重新推理一次,这正是一种固定执行长度。PAV 让这个间隔随每次提议变化;0.3 的规则同样适用:一个间隔只属于给出它的那个系统和配置。
物理AI实验室 1.6:模仿学习讲过动作分块和误差滚雪球。PAV 论文同样指出,不看新观测执行整块会让执行误差累积;表 1 中一次执行完整 50 步的成功率最低(76.05% 和 56.80%),可以作为这一点在 LIBERO 上的例子。
站内报道的 VeriVLA 用两次采样的动作变化触发验证,再由潜世界模型按预测进度从 10 个候选动作块中选一;RESETTLE 在两次采样持续分歧时才介入。它们回答的是“选哪一块”和“何时介入”,PAV 回答的是“这一块执行多长”。PAV 论文讨论的生成稳定性信号包括 A3 的动作共识与重解码稳定性,和这两篇用采样差异的思路相近;但 PAV 论文没有评测这两种方法,三者的基准与设置不同,数字不能直接比较。
读 RoboTwin 表时,h = 32 基线与其他方法未配对、DVAC 来自不同协议,这些都可以按物理AI实验室 1.8:评测的问法逐项核对:条件、次数、是否配对。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。作者写明实现将作为补充材料提交,所读文本没有给出公开代码地址。
- 仿真结果来自 LIBERO 和 RoboTwin 2.0;真机只有一个平台(Franka Panda)、三项任务、每项 30 次,而且只有固定长度基线。仿真和这组真机结果都不是硬件安全验证。
- 相对 AutoHorizon,PAV 在 LIBERO 的两组 H = 50 设置中只高 0.20–0.25 个百分点,查询更多;表中没有置信区间。
- 标 † 的基线是引用的已发表结果,协议可能不同;RoboTwin 的 h = 32 基线未与其他方法配对,DVAC 用的是 H = 50 策略。
- 验证器要针对每个策略配置和基准单独训练(仿真中同一配置、同一基准的任务共用一个),需要以随机执行长度采集的回合数据,LIBERO 配置用了 6,000 个回合;LIBERO 与 RoboTwin 的配置不同(β、任务嵌入)。
- 阈值 β 在默认值附近很敏感,所读文本没有说明它的选定方法。表 11 的默认行沿用正文主结果,不来自与其余各行相同的扫描运行,因此 5.20–9.00 个百分点的降幅是跨运行比较。0.90–2.49 ms 的开销只是 GPU 计算时间。
- 所读 HTML 文本在附录 C.4 的表 13 处截断,附录 E(真机硬件与训练细节)不在其中。论文正文有几处表号与表格标题不一致,例如把 RoboTwin 结果引为表 3(实际为表 2)、把余弦相似度引为表 5(实际为表 4);本文按表格标题引用。
链接
- Policy-Aligned Predictive Verification for Adaptive VLA Action-Chunk Execution(arXiv 2610.21434)
- 论文 HTML 全文
- 物理AI实验室 0.3:看-想-动,把三个频率放回各自的系统
- 物理AI实验室 1.6:模仿学习,手算误差怎样滚出示范覆盖范围,再把 ACT、扩散策略与数据规模律的数字放回各自条件
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 前沿雷达|VeriVLA:两次采样判断何时值得多算,再用潜世界模型按预测进度从 10 个候选动作块中选一
- 前沿雷达|RESETTLE:冻结策略的两次采样持续分歧才介入,按示范参考只执行一个纠正动作
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)