多くの VLA は、現在の 1 フレームだけを見て次の一連の動作を予測します。Kyutai、Inria、フランス国立土木学校(École nationale des ponts et chaussées)の著者によるプレプリント REKI(arXiv 2610.22178、2026-10-15)は、ほとんどコストのかからない記憶を加えました。フローマッチングの動作エキスパートにフレームごとに 32 個のレジスタトークンを置いて、そのフレームの VLM 出力を要約させ、そのキーとバリューをエキスパートのキャッシュに残して、続く 2 フレームから参照できるようにします。著者の報告では、公開データだけで事前学習したこの 2.4B モデルは、LIBERO-Plus と RoboTwin Clean2Rand で比較対象の公開データ VLA を上回ります。記憶による推論時間の増加は 1% 未満で、アームが 2 つの姿勢の間を行き来する振動エピソードは約 4 分の 1 に減ります。本記事では、この振動をどう定義し、どう測り、著者がどう説明しているかを中心に見たうえで、ベンチマーク、レイテンシ、実機の数字それぞれの条件を確認します。以下の数字はすべて著者報告 [R] で、本サイトでは再現していません。
設計:記憶は動作エキスパートに置き、VLM は各フレームを 1 回だけ符号化する
REKI は VLM と動作エキスパートの 2 つで構成されます。VLM は Qwen3.5-2B で、プロンプトと各カメラの画像を 1 本の系列にまとめ、最終層の隠れ状態を符号化コンテキストとして使います。プロンプトには言語指示のほか、エンボディメント、制御モード、制御周波数、ビン分けしたエピソード長が書かれます。動作エキスパートは幅 768 のブロック 10 個からなり、クロスアテンションで符号化コンテキストを読みます。ロボットの状態はプーリングされ、適応的正規化を通じてエキスパートを変調します。推論時はノイズから 10 回のオイラーステップで 1 つの動作チャンクを生成します。
記憶の仕組みは次のとおりです。フレームごとに n_r = 32 個の学習可能なレジスタトークンを、エキスパートの入力系列でノイズ付き動作トークンの前に置きます。論文が示すアテンションの規則は 3 つです。
- レジスタはそのフレームの符号化コンテキストにクロスアテンションし、それ以前のフレームのレジスタにセルフアテンションします。
- 動作トークンは現在と過去のフレームのレジスタ、および動作トークン自身を読みます。レジスタが動作トークンを読むことはありません。
- レジスタのキーとバリューはエキスパートのキャッシュに保持されます。キャッシュは直前 K − 1 フレームを覆うローリングウィンドウで、K = 3 です。新しいフレームが入ると、最も古いフレームのレジスタが捨てられます。
レジスタは動作トークンを読まず、適応的正規化も通らないため、観測だけに依存し、フロー時間やロボットの状態には依存しません。論文はここからコスト面の 2 点を導いています。推論時には、現在フレームのレジスタを最初のオイラーステップで計算し、残り 9 ステップで再利用します。VLM は各フレームで現在の画像だけを処理するので、エンコーダのコストは記憶なしの方策と同じです。学習時には、1 サンプルは同じエピソードから 1 秒間隔で取り出した K フレームで、1 つのバッチにまとめて 1 回の順伝播で処理し、逐次展開する再帰はありません。各フレームが自分の動作チャンクの損失を持つので、K フレームのウィンドウから K 個の学習信号が得られます。さらに論文は、学習時には各ウィンドウを独立に処理する一方、推論時にキャッシュされたレジスタ自体がより古いフレームのレジスタから計算されているため、情報がウィンドウを越えて残りうると述べています。
論文の図 2 は、この方式を既存の 3 系統と並べています。過去フレームを現在フレームと一緒に VLM に入れる方式(コストがウィンドウとともに増え、少なくとも視覚エンコーダで増加)、バックボーンやヘッドで 1 ステップずつ読み書きする再帰状態(学習時に逐次展開が必要)、そして記憶モジュールを追加する方式です。著者によれば、推論時に記憶が加える時間は記憶なしモデル(K = 1)の予測時間の 1% 未満です。
事前学習データはすべて公開データです。遠隔操作のロボットデータ(RoboSet、Galaxea、AgiBot World 2026、RoboCOIN、RoboMIND、RDT-1B、DROID、BridgeData V2、Open X-Embodiment のうち 12 データセットなど)、モーションプランニングで生成したシミュレーションデータ、約 35 万エピソード・1 億 7,000 万フレームの一人称視点の人間の操作動画、そして視覚言語データ(学習サンプルの 10%)です。各データセットは独自の制御規約をそのまま保ち、共通の動作空間には変換しません。モデルは 32 基の H100 で 20 万ステップ、グローバルバッチ 2,880 で事前学習し、その後ベンチマークごとに個別にファインチューニングします。
振動:同じ重みで記憶を外すと、割合は 4.1% から 14.8% に上がる
論文の第 6.2 節は振動を具体的に定義しています。アームごとに、ある動作チャンク中の動きの方向を直前のチャンクと比べ、小さな動きは無視します。あるアームが 3 チャンク以上連続してほぼ逆方向に動いた場合、つまり少なくとも 2 回往復した場合に、そのエピソードを振動とみなします。集計は RoboTwin Clean で、50 タスク、各タスク 20 の対応シードで行いました。著者はこの判定基準を 16 タスクで定め、残り 34 タスクで記憶の効果を確認しています。振動したエピソードのうち成功したものは 5% 未満です。
| 条件(学習時ウィンドウ → 評価時ウィンドウ) | 振動エピソードの割合 |
|---|---|
| K = 3 で学習、K = 3 で評価(3 → 3) | 4.1% |
| 同じ重みで、評価時に過去フレームを 1 枚だけ与える(3 → 2) | 4.6% |
| 同じ重みで、評価時に過去フレームを外す(3 → 1) | 14.8% |
| 記憶なしで学習・評価(1 → 1) | 18.6%(失敗エピソードの半数で振動) |
「約 4 分の 1」は、どの記憶なし条件と比べるかによって変わります。14.8 / 4.1 ≈ 3.6、18.6 / 4.1 ≈ 4.5 です(本サイトによる計算)。差が最も大きいのは双腕タスクです。双腕タスクで最も多い循環は「腕の入れ替わり」で、一方のアームが伸びるともう一方が戻ります。1000 エピソード中、記憶なしでは 65 回、記憶ありでは 1 回でした。たいていは物体を放した数秒後に始まります。著者は、記憶がこうしたエピソードをすべて救うわけではないことも明記しています。記憶なしの方策が振動するシードでは、記憶ありの方策の成功率は 45% です。
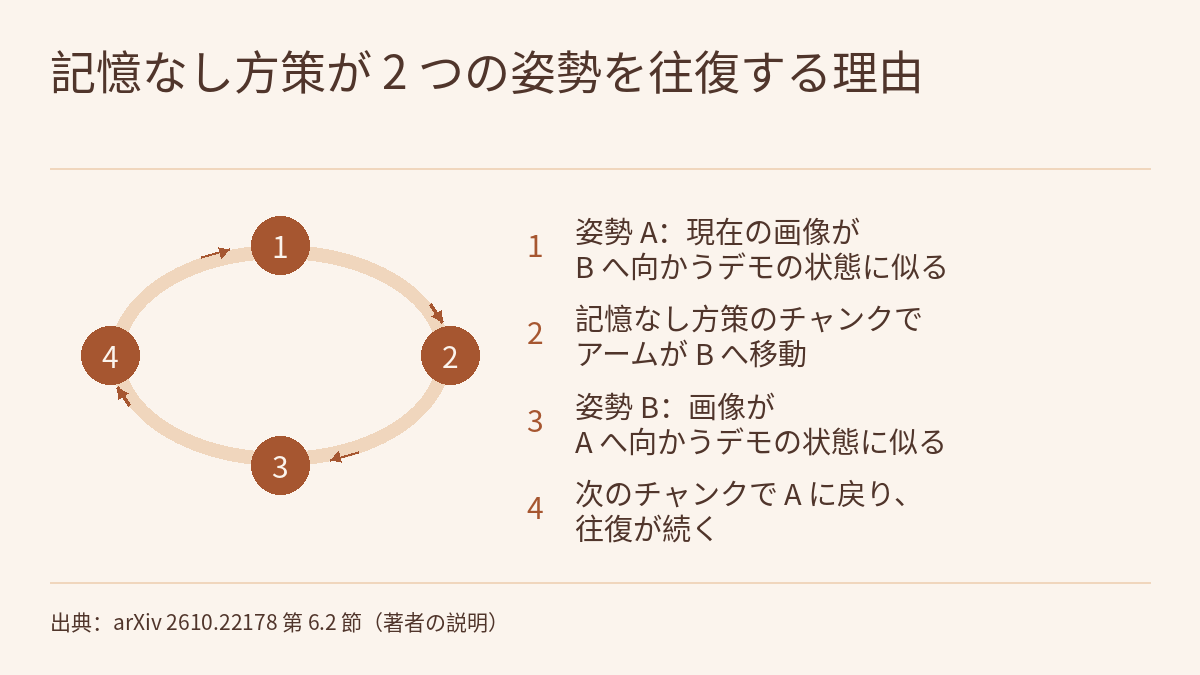
著者の説明は知覚的エイリアシング(perceptual aliasing)です。記憶なしの方策は現在の観測を次のチャンクに写像するだけです。姿勢 A と B がどちらも、デモの中で互いの方向へ動き続ける状態に見えると、A で予測したチャンクはアームを B へ運び、B で予測したチャンクは A へ戻します。短い履歴があれば曖昧さは解消されます。B から来たばかりのウィンドウは、B へ向かうデモとは一致しないからです。これは著者による原因の帰属で、強化学習の文献にある知覚的エイリアシングの古典的研究に基づいています。本記事で読んだ本文が示すのは振動の割合の変化であり、この仕組みを直接検証する実験ではありません。論文は、時間方向のアンサンブル(temporal ensembling)や双方向デコーディングでもチャンク間の切り替えを抑えられるものの、追加の方策呼び出しが必要であり、REKI の記憶にはそれが不要だとも述べています。
同じアブレーションでは成功率も比較しています(論文の図 5。LIBERO-Plus は LIBERO でファインチューニングした後の評価)。
| 条件 | LIBERO-Plus | RoboTwin Clean | RoboCasa365 |
|---|---|---|---|
| 3 → 3 | 90.4 | 73.4 | 38.4 |
| 3 → 2 | 90.1 | 73.6 | 39.3 |
| 3 → 1 | 88.9 | 67.2 | 34.9 |
| 1 → 1 | 88.9 | 67.9 | 33.0 |
向上分の大半は、最初の 1 枚の過去フレームで得られます。ウィンドウ内のすべてのフレームに損失がかかるため、記憶ありでファインチューニングしたモデルは記憶なしでも動けるようになります。記憶を外して評価すると(3 → 1)、K = 1 でファインチューニングしたモデルに近い成績になります。著者はここから、向上は主に推論時に過去フレームを読むことによるもので、ウィンドウで学習すること自体によるものではないと結論づけています。
ベンチマーク:首位の範囲は「公開データで事前学習した VLA」
論文の主な主張は、性能とモデルサイズの間に新しいパレートフロンティアを設定したというものです。LIBERO-Plus で最高スコア、RoboTwin Clean2Rand と RoboCasa365 では約 2 倍の大きさのモデルにしか上回られていません。これらの数字を読むときは、比較の範囲に注意が必要です。
- 分布外:LIBERO-Plus は 90.4 で、次点の公開データ VLA である InternVLA-A1.5(84.8)より 5.6 ポイント高くなっています。Clean2Rand では ABot-M0(55.7)より 10.1 ポイント高く、65.8 です(本サイトによる計算)。Clean2Rand はきれいなシーンだけでファインチューニングし、6 つの条件(きれいなシーン、4 種類のランダム化をそれぞれ単独で、4 種類すべて同時)で評価した平均です。RoboCasa365 の学習時に見ていない複合タスクでは、REKI は 14.1 で、Qwen-RobotManip(14.9)と同程度、Xiaomi-Robotics-1(32.1)を下回ります。
- 分布内:RoboCasa365 は 38.4 で、RLDX-1(36.0)と Qwen-RobotManip(35.9)を上回ります。RoboCasa-GR1 は 58.6 で、RLDX-1(58.7)、ABot-M0(58.3)と同程度です。LIBERO は 97.5 で、多くのモデルは 97.6〜99.4 の範囲にあります。RoboTwin は 85.9 / 84.6 で、同程度の大きさの InternVLA-A1.5(93.3 / 93.0)を下回ります。著者は、後者が学習時に追加の動画生成モデルで監督され、より複雑な多段階の事前学習を使っていると指摘しています。
- 比較対象:ベースラインの数字は公表済みの結果から取っています。社内データで事前学習したより大きなモデル(Qwen-RobotManip、RLDX-1、Xiaomi-Robotics-1)と、動画生成モデルを基にした ABot-M0.5 について、著者は現時点の上限の目安にすぎず、同条件の比較ではないと明記しています。
事前学習の効果:ゼロから学習すると Clean2Rand は 52.0、LIBERO-Plus は 86.1 です。事前学習によって分布外で 13.8 ポイントと 4.3 ポイント、分布内では RoboTwin で 2.9 ポイントと 0.8 ポイント、LIBERO で 1.0 ポイント上がります。学習設定もロバスト性に大きく影響します。LIBERO-Plus では、カメラのランダムな欠落や画像拡張を無効にすると、カメラ視点の変化に対する成功率が 20 ポイント以上下がり、状態の欠落を無効にすると、ロボットの初期状態の変化に対する成功率が 8.1 ポイント下がります。
レイテンシと実機:21.8 ms と 7〜37.5 ポイントの条件
レイテンシは 1 回の呼び出しについて、生の観測から正規化を戻した 1 チャンク分の動作までを測り、前処理とホスト・デバイス間の転送を含みます。入力は 256 × 256 の画像 2 枚、ロボットの状態、固定のプロンプトで、バッチサイズ 1、各モデルが公開しているチェックポイントと推論コードを使います。各値は 320 チャンク、3 回の繰り返しの中央値です。REKI は VLM のプレフィルとエキスパートをそれぞれ 1 つの CUDA グラフにコンパイルしており、K = 3 で 1 チャンク(10 動作)を 21.8 ms で予測します。これは比較したモデルの中で最も短く、X-VLA は 25.5 ms、openpi 版 π0.5 は 33.8 ms、ABot-M0 は 46.1 ms、InternVLA-A1.5 は 51.3 ms です。X-VLA、ABot-M0、InternVLA-A1.5、ABot-M0.5 のコンパイル済み経路は著者が自ら構築したもので、計算内容は変えていないと著者は述べています。コンパイルしない場合、REKI、π0.5、ABot-M0 は 118〜139 ms、InternVLA-A1.5 は 352 ms、X-VLA(0.9B)は 51 ms です。
GPU 時間では、REKI は 1 チャンクあたり 16.5 ms で、X-VLA(16.1 ms)と同程度です。図 5 の測定では、VLM のプレフィルが 9.5 ms、オイラーステップが 8.1 ms で、キャッシュされたレジスタの読み出しで 0.1 ms 増えます。付録の表 10 の別の測定では、REKI のオイラーステップは 8.2 ms、InternVLA-A1.5 は 34.9 ms で、著者はこの差を後者の大きな動作エキスパート(24 層 0.5B 対 10 層 0.2B)によるものとしています。21.8 ms は H100 1 基とこの入力での値であり、制御周波数ではありません。論文は、この値が新しい観測にどれだけ速く反応でき、どれだけの頻度で再計画できるかの上限を決めると述べています。
実機実験では、6 自由度の UR5 アームに Weiss WSG50 グリッパーと UMI 方式の平行ジョーを付け、動作ループは 15 Hz、固定の Orbbec Femto Mega RGB カメラを 1 台使います。観測は RGB 画像 1 枚と 7 次元の絶対関節状態です。5 つのタスクはピック、プレース、積み上げ、掃き寄せを含みます。各タスクで Meta Quest コントローラーにより 50 エピソードの学習デモを収集し、10 エピソードで評価しました。各エピソードで物体の配置をランダムにし、妨害物を置いています。REKI と π0.5 はどちらも事前学習済みチェックポイントから 3,000 ステップ、グローバルバッチ 360、学習率 5 × 10⁻⁵ でファインチューニングし、視覚エンコーダの最後の 4 ブロックだけを学習させました。結果として、REKI は 5 つのタスクで π0.5 を 7〜37.5 ポイント上回りました。記憶を外すと、短めの 2 タスクは変わらず(65 対 65、57.5 対 57.5)、長めの 3 タスクでは 12〜17.5 ポイント下がりました。
ここでは 2 点を分けて考える必要があります。1 つ目は動作チャンクの長さが異なることです。π0.5 は事前学習で固定された 50 ステップ(3.3 s)、REKI は 30 ステップ(2 s)なので、REKI と π0.5 の差はモデルだけに由来するとは言えません。2 つ目は、各タスクの評価が 10 エピソードしかなく、スコアに部分点が含まれ、本記事で読んだ本文には信頼区間が示されていないことです。著者によれば、REKI のファインチューニングには実機タスクで H100 8 GPU 時間、各ベンチマークで 40〜400 GPU 時間かかります。
本サイトの既存ページとの関係
フィジカルAIラボ 1.6:模倣学習では、行動クローニングが現在の観測だけを見ること、誤差がロボットをお手本のカバー範囲の外へ運びうることを説明し、ACT の動作チャンク化と時間方向のアンサンブルも扱いました。REKI の振動の分析は、別の種類の失敗を補います。誤差は遠くへ転がり続けるとは限らず、よく似た 2 つの状態の間を行き来することもあります。論文によれば、時間方向のアンサンブルのような方法は方策を追加で呼び出す必要があり、REKI は数フレームの記憶を使います。
フロンティア・レーダー|Fast-VLAも KV キャッシュを記憶として使いますが、方向は逆です。Fast-VLA は VLM をエピソードに 1 回だけ呼び出し、その結果をエピソード中は固定の KV タスクメモリとして保持します。REKI は VLM を毎フレーム実行し、記憶は動作エキスパート内で直近数フレームを覆うローリングなレジスタです。2 つの論文はベンチマークもハードウェアも異なるため、数字を直接比べることはできません。
フィジカルAIラボ 2.3:SmolVLA をファインチューニングするは別のオープンな VLA を扱っています。REKI の論文は、SmolVLA を公開データで完全なパイプラインを公開した先行モデルの 1 つに挙げています。2.3 の「数字はそれを測ったモデル、プラットフォーム、設定だけを表す」という規則は、REKI の 21.8 ms と実機スコアにもそのまま当てはまります。REKI の事前学習はロボットの遠隔操作データ、一人称視点の人間の動画、視覚言語データを混ぜています。これらの入手ルートで単位や動作空間がどう違うかは、フィジカルAIラボ 1.5:データはどこから来る?と照らし合わせてください。振動の判定基準は 16 タスクで定めて別の 34 タスクで確認し、各タスク 20 の対応シードを使っています。この手順は、フィジカルAIラボ 1.8:評価の対応づけとホールドアウトの問い方で読むことができます。
制約と注意点
- これは arXiv のプレプリントで、数字はすべて著者報告 [R] です。本サイトはいずれの結果も再現していません。
- 論文は、データ整備からデプロイまでのコード全体と、事前学習済みおよびファインチューニング済みの全重みを公開したとし、所在を
github.com/kyutai-labs/rekiとしています。本サイトはこのリポジトリの内容とライセンスを確認していません。 - ベースラインのスコアは公表済みの結果から取り、レイテンシは著者が統一した手順で測定しています。一部のベースラインのコンパイル済み経路は著者が構築したものです。社内データで学習したモデルとの比較は参考にとどまります。
- 振動の判定基準(3 チャンク以上連続の逆方向の動き)は著者独自のもので、RoboTwin Clean だけで集計されています。知覚的エイリアシングは著者による原因の帰属で、個別に検証された仕組みではありません。
- 記憶のウィンドウは 1 秒間隔の 3 フレームだけです。著者は数秒の記憶で標準的なベンチマークの多くのタスクには十分だと見ていますが、ずっと前の出来事に依存するタスクの長い文脈をレジスタが運べるかは、まだ検証されていません。
- 実機の部分は UR5 1 台、5 タスク、各タスク 10 エピソードで、部分点を含み、π0.5 とは動作チャンクの長さが異なります。シミュレーションの結果もこの実機評価も、ハードウェアの安全性検証ではありません。
- 本記事は論文の HTML 本文(参考文献の前半まで)に基づいており、付録の完全な表は参照していません。
リンク
- REKI: Registering Knowledge in VLAs(arXiv 2610.22178)
- 論文 HTML 全文
- フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読む
- フィジカルAIラボ 2.3:SmolVLA をファインチューニングする――指示に合わせてお手本を計画し、各数字が何を測ったかを確かめ、非同期の動作キューの時間を計算する
- フィジカルAIラボ 1.5:データはどこから来る?――SO-101 のメタデータからお手本の長さを求め、三つの入手ルートの単位と動作空間を見分ける
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フロンティア・レーダー|Fast-VLA:4B VLM はエピソードごとに 1 回だけ考え、実行器は動作チャンクごとに固定の KV タスクメモリを参照する
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)