端到端自动驾驶通常先模仿车队日志里的人类驾驶,可碰撞、险情和脱困这类安全关键事件在日志里极少。来自 Applied Intuition、UCLA 和 UC Berkeley 的作者在预印本 TerraTransfer++(arXiv 2610.30319,2026-10-21)里换了顺序:先在矢量化仿真器里用多智能体自博弈学会开车,再把这个读矢量状态的“教师”蒸馏成能输出规划轨迹的第二个教师,最后只用(图像, 场景状态)配对帧,把任一教师对齐到一个读相机图像的学生。整个流程不拿记录下来的人类轨迹当监督目标。作者报告,规划学生在 NAVSIM navhard 上达到 59.4 EPDMS、navtest 上 95.5 PDMS,闭环学生在 HUGSim 436 个场景上的闭环 HD-Score 为 0.548。以下数字均为作者报告 [R],本站未复现。
为什么不直接模仿车队日志
论文的出发点是一笔账。按 NHTSA 的碰撞率,自然驾驶中大约每 1.6 万驾驶小时才发生一次碰撞;论文引用的估计是,单是车队运营,记录一次这样的罕见事件就可能花掉 100 万美元以上。模仿学习只能复制驾驶员实际做过的动作;对日志轨迹做开环强化学习,又看不到其他车辆会怎样回应它尝试的新动作。在照片级渲染的仿真器里做闭环 RL 能看到后果,但每一步都要渲染并跑一次大型视觉骨干,多个智能体一起训练时代价成倍增加。
矢量化仿真器里的自博弈改变了这笔账:一个共享策略控制所有车辆,每次策略改进都会改变其他车辆面对的交通,交互行为随策略一起演化;论文引用的相关工作称,这类仿真在普通硬件上每秒可以跑数百万步。问题是自博弈策略读的是矢量化的场景状态,不是原始传感器,部署时要先用一套感知栈从图像恢复类似高精地图的输入。TerraTransfer++ 要解决的就是这一步。
物理AI实验室 1.6:模仿学习讲过机器人一旦走到示范没覆盖的状态,错误会越滚越大;物理AI实验室 1.7:强化学习讲过不给示范、只给奖励的试错。这篇论文把两者的分工放到了自动驾驶上:行为从奖励和自博弈里学,图像只用来学“看”。
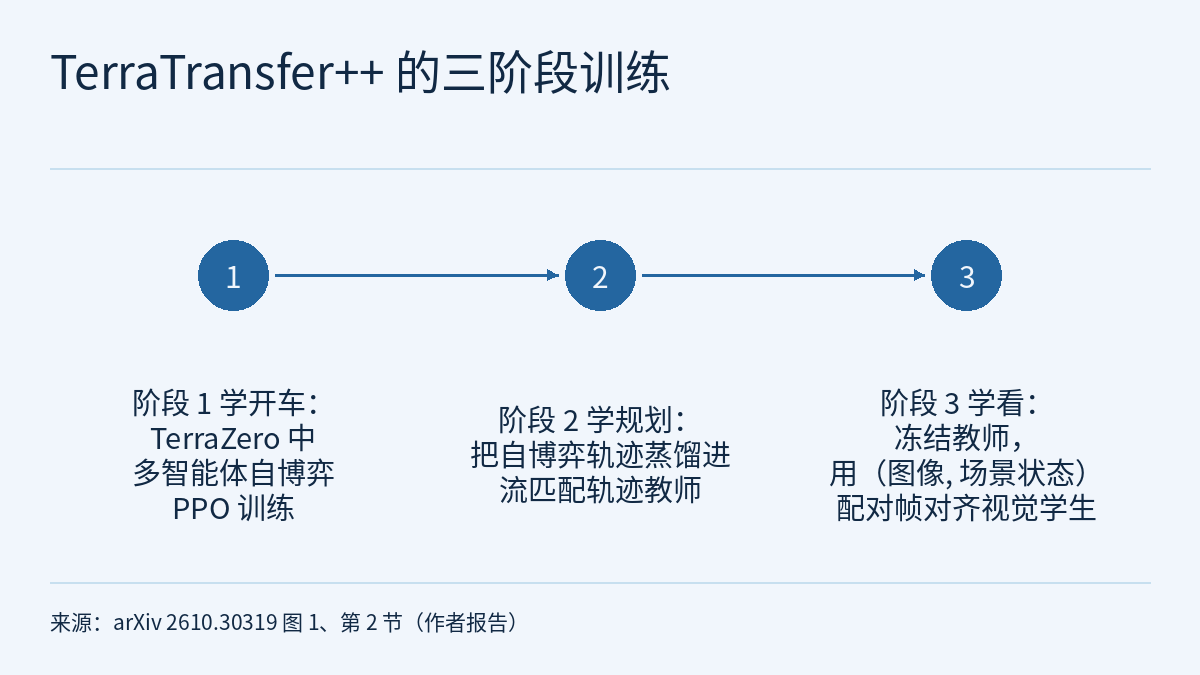
三个阶段:学开车、学规划、学看
阶段 1,自博弈教师。仿真器是作者团队自己的 TerraZero,它把 nuPlan 的高精地图编译成车道拓扑、车道边界和可行驶区域。训练不用任何 nuPlan 记录的轨迹、初始状态、目标、人类动作或回放交通:车辆沿车道中心线程序化生成,每辆车的目标在可达车道图上前方 20 到 100 m。每 0.1 s 一步,车辆观测自身运动学与目标、附近道路折线与交通控制、周围实体,分别进入 ego、road、partner 三路编码器。同一套参数控制所有场景里的所有车辆,动作是 12 个离散的 jerk(加加速度)动作,用 PPO 优化。奖励是目标到达、碰撞、舒适、车道对齐与居中、速度、交规遵守等项的加权和;沿用 GigaFlow 的做法,每个智能体每个回合重新采样权重,并把权重放进它自己的观测里。作者称这个策略在 16 块 A100 上训练 96 小时,累计模拟行驶超过 24 亿公里。在对齐视觉之前,作者报告它在 nuPlan val14 上得 94.19(此前最好的模仿规划器为 92.28),在交互式长尾 InterPlan 上得 70.87(对 63.66),导出的轨迹在 WOSAC 2023 拟人度基准上得 0.632(记录数据参照为 0.722)。
阶段 2,轨迹教师。闭环策略每步只输出一个动作,规划接口和 NAVSIM 这类伪闭环评测却要一段多秒的轨迹。作者把冻结后的自博弈教师的实际行驶结果当目标:每一帧记录接下来 80 个位姿(10 Hz、8 s),而不是日志里的人类轨迹。轨迹教师是一个 1120 万参数的 Transformer,读同样的矢量观测,用流匹配头生成轨迹,推理时 10 步 Euler 积分;用 64 块 GPU 跑一小时自博弈,就得到 6 亿条这样的 8 s 轨迹。评 NAVSIM 时,它从 16 次不同噪声里采样 16 条候选,再按对其他车辆的匀速外推预测、以碰撞、TTC(碰撞时间)和进度选最好的一条。这个选择读的是真值车辆状态,所以论文把轨迹教师列为特权参照。
阶段 3,视觉对齐。论文先按闭环学生描述这一步。闭环学生直接对齐阶段 1 的教师,不经过阶段 2。它保留教师冻结的策略头和 ego 编码器,只把 road、partner 两路编码器换成读图像的版本:一个冻结的 DINOv3 骨干,加两个各自独立的线性适配器,只训练适配器。监督有两项:一是教师与学生动作分布之间的前向 KL 散度,匹配整个分布而不只是采样到的动作;二是结构损失,在每个批次里取教师特征的主子空间(partner 取前 13 维、road 取前 9 维,即 80% 累积能量的截断点),只要求学生复现批次内各场景两两之间的余弦相似度,权重 λ = 0.5。
规划学生把同一套做法换到轨迹教师上,有几处不同:冻结的 DINOv3 骨干加轻量适配器,从图像预测轨迹教师的 20 个分类型潜在 token(road、partner 和交通控制三类);动作损失是对轨迹教师动作头的 KL 散度,结构损失按类型分别作用于展平后的潜在 token,权重同样为 λ = 0.5;ego 编码器、融合层和动作、轨迹两个头都保持冻结,直接读预测出的潜在 token。另加一项 L2 损失,在全部 80 个航点上匹配轨迹教师从 16 条里选出的那条计划,权重为 1;推理时学生只采样一条,不再做选择,也就不读真值状态。
作者说明了为什么不用“先感知、再喂给冻结教师”的级联:感知模块按检测类代理目标训练,误差得不到驾驶质量的梯度;教师是在干净的仿真状态上训练的,对输入噪声敏感,感知恢复得不完美就会拖累它。
“不用示范”不用的是什么
这里的“无示范”指不拿记录的轨迹当监督目标,不是不用真实数据。闭环学生主实验的对齐数据是约 183 万帧 nuPlan 配对帧(7,129 个分片、每片 256 帧,10 Hz 下约 51 小时),每帧的目标是教师在重建场景上的动作分布;图像是记录的真实相机画面,场景状态需要感知标签,作者称这类标签与策略无关,可以离线自动标注。在论文 2.4 节描述的闭环学生设置里,日志中自车轨迹的终点仍作为目标信号进入学生的 ego 向量。此外还有 30 万帧 HUGSim 域适应帧,渲染自评测场景本身,但只覆盖这些场景总路线长度的 10%。闭环学生的这次对齐在 8 块 A100 上用 10 小时完成。规划学生则如论文 3.1 节所写,只在 NAVSIM navtrain 上对齐。作者估计,若在训练回路里实时渲染,会比矢量推演慢约 6,000 倍(17.5 万 fps 对 30 fps,按全部相机计)。
作者自己的概括是:仍然用车队日志“看到”的东西,但不再用它“做了”什么。他们也写明,刹车灯、手势这类边界框状态里没有的视觉线索,模仿学习仍然有用。
结果:两个学生各自对照什么
HUGSim 闭环。HUGSim 是基于 3D Gaussian splatting 的照片级闭环基准,436 个场景分属 nuScenes(88)、PandaSet(127)、KITTI-360(113)、Waymo(108)四个分割,各分 Easy、Medium、Hard、Extreme 四档。按场景数加权汇总,读矢量状态的教师闭环 HD-Score 为 0.562,相机学生为 0.548(约为教师的 97.5%),HUGSim 原生评分下为 0.528。表中最强基线 ECO 比学生低 0.120(闭环)和 0.184(原生);模仿训练的 LTF、UniAD、VAD 闭环为 0.266、0.244、0.187。所有基线都是作者用公开检查点重跑的结果,其中 UniAD、VAD、LTF 在当前场景和地图上重跑。学生不输出轨迹,原生评分时作者给它的是“减速替身计划”:实际执行的第一步加一段满足舒适约束的停车,按构造就满足舒适度上限。论文还提醒,各分割的绝对分数不可直接比较。
弱项在 Extreme 档:学生闭环 0.162、原生 0.137,教师也只有 0.158 和 0.136,ECO 和模仿基线在部分分割上更好。作者称这一档有些场景本身不合理,其他车辆无论自车怎么做都会撞上来,一个只会加速直行、不做反应的策略闭环就能拿 0.227,高于所有会反应的策略;学生像教师一样停下让行,牺牲了路线完成度。这是作者对该档评分的解释。
与同期自博弈到像素的系统。GigaPixel 和 DriveZero 报告的是旧版 345 场景协议上的原生 HD-Score(0.385 和 0.466),检查点未公开。作者在同样 345 个场景上重评自己的系统,教师 0.527、学生 0.518。但这组对比的评分对象不同:作者的数字用的是减速替身计划,另两个系统是按各自策略输出的计划打分。
NAVSIM 伪闭环规划。NAVSIM 给一条 4 s 规划打分。规划学生在 NAVSIMv2 navhard 上为 59.4 EPDMS,比 DriveZero-Scale 的 57.1 高 2.3 分,比特权、靠 16 选 1 的轨迹教师(62.1)低 2.7 分;在 NAVSIMv1 navtest 上为 95.5 PDMS,DriveZero-Scale 为 95.3。表中基线是 He 等(2026,即 DriveZero 论文)汇编的已发表结果。作者也列出了学生的短板在安全余量和扰动后的恢复,并称与教师一致:navtest 的 TTC 子分 92.2(教师 93.2,DriveZero-Scale 97.3),navhard 第二阶段 DAC 子分 90.2(教师 90.4,DriveZero-Scale 95.6)。也就是说,总分领先的同时,这两项子分都低于 DriveZero-Scale。
消融:同样数据下换监督来源
论文表 4 在 nuScenes 分割上固定 183 万帧 nuPlan 配对帧(不含 HUGSim 域适应帧)、感知标签和算力预算,只改监督来源:模仿 nuPlan 记录动作为 0.206,用 SparseDrive 恢复矢量输入再喂给冻结策略头的模块化级联为 0.361,自博弈教师加对齐为 0.574。去掉一项损失,只用动作项为 0.434,只用结构项为 0.373。秩消融则在全部 436 个场景上、用含域适应帧的主实验数据做(表 3):partner/road 取 7/5 维为 0.517,取截断点 13/9 维为 0.548,取 26/18 维为 0.533,匹配全部坐标为 0.456。
作者还做了一个特权探针:把视觉编码器换成重新初始化、读矢量观测的教师同构编码器,用同样的损失和数据训练。它在 nuScenes 上为 0.645,教师为 0.647,作者据此认为对齐目标本身几乎不损失能力;同样数据下的相机学生为 0.574,作者称这 0.071 的差距合并了感知代价和 nuPlan 到 HUGSim 的域差距;加上域适应帧后为 0.636,与探针只差 0.009,作者把这部分剩余差距对应到观测不对称问题:教师读的矢量状态可能包含相机看不到的车辆。结论部分又写明,他们尚未把遮挡因素与其他感知误差分开。
读这些数字时,物理AI实验室 1.8:评测里的几问同样适用:消融只在一个分割或一组场景上做,所读正文没有报告重复种子或置信区间,差距很小的几处(例如 0.002 和 0.009)不宜读成确定的结论。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。本站读到的文本止于参考文献开头,没有读附录(环境配置、奖励项、分档细分和骨干消融都在附录里),所读文本也没有说明代码、权重或 TerraZero 是否公开。
- 作者主要来自 Applied Intuition,TerraZero 是他们自己的仿真器;HUGSim 基线由作者重跑,NAVSIM 基线取自 DriveZero 论文的汇编。
- “无示范”只指不用记录轨迹作监督:闭环学生的对齐仍需真实相机图像、场景状态标签,以及(按 2.4 节的设置)日志中自车轨迹的终点作为目标。HUGSim 域适应帧渲染自评测场景本身(覆盖其路线长度的 10%)。规划学生只在 NAVSIM navtrain 上对齐。
- HUGSim 原生评分和 345 场景对比中,学生用的是满足舒适约束的减速替身计划,而不是自己输出的轨迹;轨迹教师的 16 选 1 读真值状态,是特权参照,不是可部署的方法。
- 所有评测都在仿真或基于日志的伪闭环基准上完成,所读正文没有实车道路测试;这些分数不是安全验证。作者在结论中列出的后续方向是:教师可能依据相机看不到的被遮挡车辆做决策;对齐数据来自 nuPlan 日志和重建场景,很少遇到恶劣天气、少见时段或罕见的场景几何。