多模态大模型做高层规划时,论文用一个例子说明一类错误:知道该做什么,却不知道一个动作什么时候才能做——它知道要把东西放进冰箱,却在冰箱门还关着时就执行“放入”;作者指出,这类违反前置条件的错误会在长程执行中累积。来自华东师范大学、北京智源人工智能研究院(BAAI)、西北工业大学、中国科学院大学人工智能学院和中国科学院自动化研究所的作者,在预印本 CausGround(arXiv 2610.29702,2026-10-21)里不微调模型,而是从交互轨迹中归纳每个动作的前置条件和效果,存成可复用的知识,规划时按当前观测挑出与任务有关的部分交给参数冻结的规划器。作者报告,在三个 Qwen3.5 骨干上,改编版 VirtualHome 的平均任务成功率从 24.9% 提高到 53.3%,RoboCasa 闭环重规划成功率从 43.0% 提高到 57.0%,SWITCH 交互推理平均准确率从 25.8% 提高到 31.9%。本文重点读两件事:这些知识是怎样分层组织的,以及三个基准各自是怎样改编、怎样计分的,因为后者决定了这些数字能说明到哪一步。以下数字均为作者报告 [R],本站未复现。
问题:已有的两种适应办法各缺一块
论文把环境适应的已有做法分成两类。参数化适应用微调或强化学习把环境经验写进模型,需要大量特定环境的交互数据和反复优化,换一个环境就要再来一遍,在真实场景里尤其昂贵。非参数化适应在推理时加入执行反馈或情景记忆,但经验往往以整段轨迹或任务级记忆保存,很难分辨一段经验里哪些因素与成败有因果关系、哪些只是碰巧出现,也很难跨任务复用、落到当前画面上。作者还指出,已有的状态表示不一定同时刻画细粒度的物体属性和物体之间的关系,而判断一个动作的前置条件是否满足,两者都要用到。
CausGround 想回答的问题是:能不能把交互经验蒸馏成一种可复用的知识,同时告诉智能体“一个动作执行前什么必须成立”和“执行后世界会怎样变”。论文的案例图里,基线规划器认出了要坐的椅子,却在不满足 NEAR(靠近)这一前置条件时反复执行 SIT;CausGround 通过因果知识找出缺失的前置步骤后完成了任务。
方法:同一套分解式状态,连接观测、知识与规划
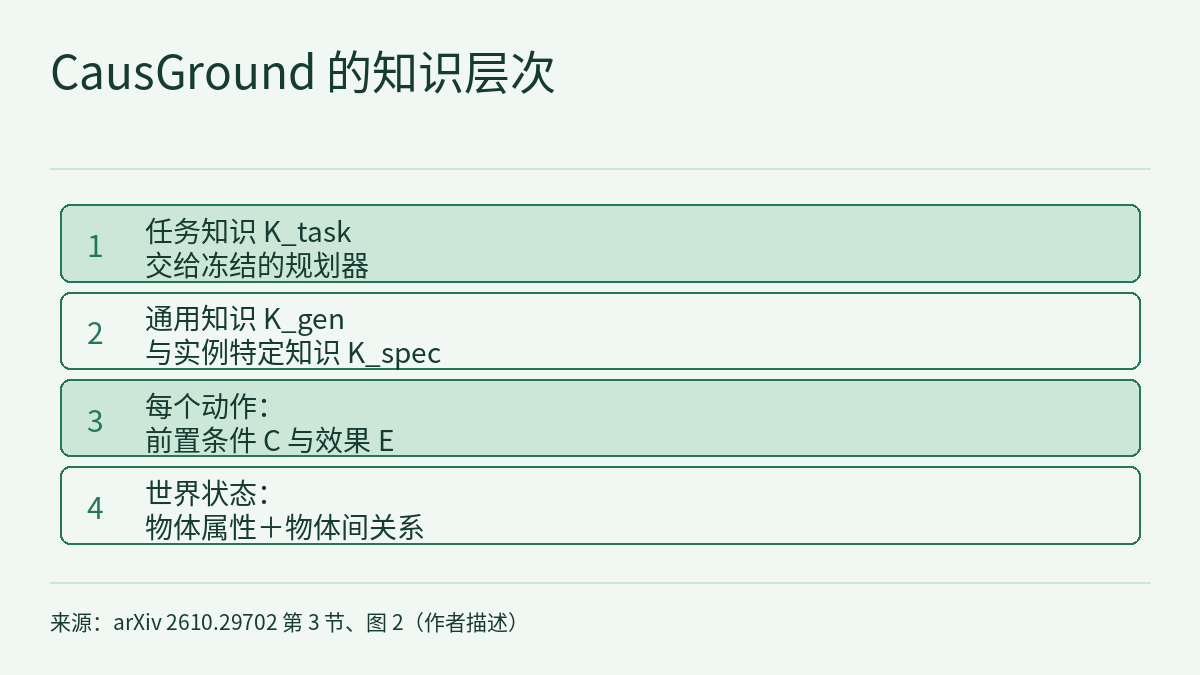
分解式世界状态。给定一帧 RGB 观测,由一个冻结的多模态模型提取世界状态 S_t = (O_t, R_t):O_t 是场景中的物体,每个物体由语义类别和一组属性–值对表示(附录的例子是杯子的 graspable=true、color=blue);R_t 是物体之间带类型的关系,如 ON(cup, table)、INSIDE(cup, fridge)、NEAR(robot, cup)。每个属性–值对和每条关系都是一个可单独识别的状态因子,可以充当某个动作的前置条件或效果。观测和知识用同一套格式,所以前置条件可以直接与当前状态逐项比对。
以动作为单位归纳前置条件与效果。对一个动作族(如 GRAB、OPEN),在“控制候选执行前因子变化”的条件下收集交互轨迹,每条记录执行前状态、落地的动作及其参数、执行后状态和执行结果。对每个落地动作 a(x),保留那些满足与否能稳定区分成功和失败的执行前因子,作为前置条件集合 C(a(x));比较成功执行前后的状态,保留稳定随动作出现的变化,作为效果集合 E(a(x));偶然出现的因子和变化被丢弃。一个动作的效果若满足另一个动作的前置条件,两者之间就连上一条因果依赖,多步交互由这些依赖组合而成。
通用知识与实例特定知识。同一动作族的不同实例之间再做一次比较:多个实例共有的前置条件和效果归为通用知识 K_gen(a),只对特定物体成立的保留为实例特定知识 K_spec(a(x))。论文的例子是 OPEN(fridge) 与 OPEN(microwave) 可能共有“openness 变为 open”这一效果,而各自的成功执行需要不同的物体特定前置条件。
任务落地与规划。每个任务开始时,CausGround 先把任务描述 g 解释为同一格式下的目标状态,从目标出发沿效果和前置条件反向推理,得到面向目标的因果依赖 K_causal;同时从知识库中按语义检索相关的通用和实例特定知识 K_sem。两者合并为 K_task = K_causal ∪ K_sem,每个任务只构建一次。此后每一步,冻结的规划器根据当前图像 I_t、结构化状态 S_t、任务描述 g 和 K_task 选下一个动作:a_t = π_θ(I_t, S_t, g, K_task)。反向推理用前置条件找出当前能执行的动作,正向推理用效果预期状态怎样变化。论文把它与世界模型方法区分开:后者能预测动作后果,但动作条件不一定显式表示,多个动作之间的依赖通常要靠反复推演才能得到;CausGround 把条件、效果和跨动作依赖直接作为知识交给规划器。
三个基准各自怎样改编、怎样计分
所有方法在同一次比较中使用相同的规划器骨干、视觉观测、任务描述和高层动作空间,规划器参数始终冻结。主实验用 Qwen3.5-9B、Qwen3.5-27B 和 Qwen3.5-35B-A3B;对照是不加任何辅助的 Vanilla 规划器,以及按同一接口改编的 SelfReVision(反复批评、修改和验证计划)和 LookPlanGraph(从视觉观测维护一张动态场景记忆图)。
| 基准 | 作者的改编 | 计分 | 读数时要注意 |
|---|---|---|---|
| VirtualHome | 改成基于图像的闭环高层规划:75 个任务,按参考动作数分为 Short(3–6)、Medium(7–10)、Long(11–22)各 25 个;6 个场景、33 种动作类型;每步三路 RGB 视图,只返回 SUCCESS/FAILURE,不给失败原因 | 成功率(SR)与最终进度(P),三档宏平均;动作尝试预算 20、40、60 次,失败的尝试也消耗预算;不要求复现参考动作序列 | 原生渲染与模拟器状态不一致的画面,用 Qwen-Image-Edit-2511 修复,并经确定性规则与人工检查后才保留,所有方法看到的都是修复后的画面;每档 25 题,一题等于 4 个百分点 |
| RoboCasa | 取 Target Composite 任务,把官方标注的技能阶段当原子动作,抽象为 8 个高层 API(NAVIGATE、PICK、PLACE、OPEN、CLOSE、PRESS、ROTATE、TILT),以模拟器观测作中间状态 | 一次性规划(最多 40 个动作)与闭环重规划(最多 25 次尝试)的任务成功率 | 预测的计划对着官方记录的转移回放:与记录转移一致才算 SUCCESS;官方轨迹没有对应分支的动作标为 UNKNOWN。从 100 个留出测试用例出发,只在没有任何方法遇到 UNKNOWN 的共同子集上比较,所读正文没有给出子集大小 |
| SWITCH | 不改原任务和协议,取四个子任务:Action(442 例)、Recovery(38 例)、Verification Action(63 例)、Verification State(225 例),共 768 例 | 各子任务准确率,总分为四项的宏平均 | 宏平均让 38 例的 Recovery 与 442 例的 Action 权重相同;Recovery 里 1 例约等于 2.6 个百分点 |
RoboCasa 的回放计分有一个直接后果:一个合理但不在官方记录里的另类计划无法被判定,含这类情况的用例会被整体排除。所以 RoboCasa 的数字衡量的是在官方轨迹覆盖的分支内选对动作的能力,不是在模拟器里真正执行底层操作的结果。
结果:均值之下的几处细节
下表按骨干列出 Vanilla 与 CausGround 的对比(取自论文表 1、表 2;最后一行是三个骨干的平均,作者在正文给出,本站按表核算一致)。
| 骨干 | VirtualHome 平均 SR | RoboCasa 一次性 | RoboCasa 重规划 | SWITCH 平均 |
|---|---|---|---|---|
| Qwen3.5-9B | 10.7 → 44.0 | 31.0 → 45.1 | 36.7 → 46.9 | 27.7 → 32.9 |
| Qwen3.5-27B | 33.3 → 62.7 | 27.9 → 27.9 | 57.8 → 75.0 | 27.9 → 35.2 |
| Qwen3.5-35B-A3B | 30.7 → 53.3 | 21.9 → 43.8 | 34.4 → 49.2 | 21.7 → 27.7 |
| 平均 | 24.9 → 53.3 | 26.9 → 38.9 | 43.0 → 57.0 | 25.8 → 31.9 |
- VirtualHome 的提升最集中。平均最终进度从 38.4% 提高到 71.3%。Qwen3.5-9B 在 Long 档的成功率从 0.0% 到 20.0%,按每档 25 题算是从 0 题到 5 题(本站换算)。最强的对照 LookPlanGraph 在 Qwen3.5-27B 上平均 SR 为 56.0%,与 CausGround 的 62.7% 相差 6.7 个百分点;该骨干 Short 档两者同为 84.0%。
- RoboCasa 不是处处领先。作者的措辞是“在多数骨干和协议设置下”最强。Qwen3.5-27B 的一次性规划,CausGround 与 Vanilla 同为 27.9%,没有提升。
- 额外的推理或结构不一定有帮助。两个对照方法在 RoboCasa 上有时低于 Vanilla,例如 Qwen3.5-35B-A3B 重规划时 SelfReVision 为 4.9%,Vanilla 为 34.4%。作者的分析是:自由形式的自我反思会编出不存在的前提(误以为物体在柜子里,插入多余的 OPEN),离散场景图会把识别错误传下去(把关着的微波炉看成开着,跳过必要动作)。
- SWITCH 宏平均的提升主要来自两个小子任务。Verification State 只提高 0.9–2.6 个百分点,Qwen3.5-35B-A3B 的 Action 只从 27.1% 到 27.4%。按样本数换算(本站计算),Qwen3.5-27B 的 Verification Action 从 36.5% 到 52.4% 约为 63 例中多答对 10 例,Qwen3.5-9B 的 Recovery 从 36.8% 到 44.7% 约为 38 例中多答对 3 例。但按答对的例数算,大子任务 Action 的增量并不小(本站换算):Qwen3.5-9B 从 24.2% 到 28.1%(+3.9 个百分点)约为 442 例中多答对 17 例,Qwen3.5-27B 的 +1.8 个百分点约为多答对 8 例,与它在 Verification Action 上的约 10 例接近。SWITCH 上只与 Vanilla 比较,绝对准确率也仍在三成左右。
- 两个组件的分工。组件消融中,Vanilla 为 SR 33.3%、进度 46.9%,只加分解式状态为 36.0%、55.1%,只加因果知识为 53.3%、70.8%,完整 CausGround 为 62.7%、79.8%。所读正文没有写明消融用的环境和骨干;这组数字的首尾两行与表 1 中 Qwen3.5-27B 在 VirtualHome 的平均值一致(本站比对)。按这组数字,主要增益来自因果知识,单独的结构化状态主要提高的是进度。
- 跨模型族。作者另在 Qwen3.5、InternVL3.5、Gemma4 三个家族的六个模型(规模从 E4B 到 38B)上测试,平均 SR 从 23.3% 提高到 50.7%,最终进度从 38.4% 提高到 67.3%;所读正文以图给出,没有逐模型的数字表。
真机部分只有一个展示案例:给定任务和初始观测,多模态模型解释出目标状态,CausGround 反向推理得到 Open(Microwave)、Pick(Bread)、Place(Bread, Plate) 三个可执行动作。所读正文没有给出真机试验次数或成功率,也没有说明这些高层动作由什么底层技能执行;作者称更多细节在附录 E,本文所据的文本不含这部分。
和本站其他内容的关系
CausGround 处在 物理AI实验室 0.3:看-想-动 所说“想”里较慢的那一层:它输出的是高层动作序列,不是关节指令。前一天的 前沿雷达|SLoSa 也处理动作前置条件,但路线相反:那里的前置条件写在 PDDL 领域里,由形式化验证器检查,验证结果作为奖励去更新模型参数;CausGround 不更新参数,前置条件和效果是从交互轨迹中归纳出来的。两篇都用到 VirtualHome 的改编版,任务、观测和指标都不同,数字不能互比。同日的 前沿雷达|GPT-GEAR 讨论的是让通用多模态模型通过工具直接控制机械臂,属于另一层的问题。读 VirtualHome 每档 25 题、SWITCH 子任务 38 例这类小样本上的差距,可以对照 物理AI实验室 1.8:评测 的方法。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。所读文本没有给出置信区间、重复次数或随机种子。论文摘要后列出了项目页地址 causground.github.io,但所读文本没有说明代码或知识库是否发布、在哪里发布;本站撰写时未能打开该项目页核实其内容,因此无法确认它是否提供代码或知识库。
- 知识库怎样构建,所读正文只给了原理:轨迹在“控制候选因子变化”的条件下收集,但在哪些环境里收集、收集了多少条、知识库与评测环境是否同源、构建成本多大,作者称在附录 C,本文所据的文本不含这部分。这些信息决定了“无需参数更新”省下的代价有多大。
- 分解式世界状态由冻结的多模态模型从图像中提取。作者指出 LookPlanGraph 会传播场景识别错误;CausGround 同样依赖提取出的状态,所读正文没有报告状态提取的准确率。
- VirtualHome 的画面经过图像编辑模型修复,再由规则和人工检查;这对所有方法相同,但改编后的结果不能与原版 VirtualHome 的文本或符号规划结果直接比较。RoboCasa 按官方记录回放计分,含 UNKNOWN 的用例被排除,衡量的是高层动作选择,不是底层操作执行。
- SWITCH 总分是宏平均,Recovery(38 例)和 Verification Action(63 例)对总分的权重与 Action(442 例)相同;“约 10 例”“约 3 例”“约 17 例”“约 8 例”“0 题到 5 题”是本站按样本数做的换算。
- 真机部分只有一个展示案例,没有成功率;它不是硬件安全验证,也不说明模拟中得到的知识在真实环境中能可靠迁移。
- 论文的 AI 使用声明写明,AI 工具用于润色文稿和协助构建改编版 VirtualHome(即上述画面修复),结果由作者审核。
链接
- CausGround: Causal Interaction Grounding for Adaptive Embodied Planning(arXiv 2610.29702)
- 论文 HTML 全文
- 物理AI实验室 0.3:看-想-动,把三个频率放回各自的系统
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 前沿雷达|SLoSa:形式化验证器按固定顺序给计划分五类并定奖励区间,4B–14B 任务规划器在 Jetson Orin 上以 INT4 本地运行
- 前沿雷达|GPT-GEAR:不训练动作策略,让 GPT-6 Astra 用五个工具直接控机械臂,深度、触觉和示范怎样给比给不给更关键
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)