動作方策を一切学習させず、汎用マルチモーダルモデルにいくつかのツールを渡すだけで、ロボットアームを直接制御して操作を完了できるのでしょうか。南京大学、南洋理工大学、北京大学、中国科学院自動化研究所などの著者は、プレプリント Large Multimodal Models for Direct Robot Control: GPT-6 as a Beginning(arXiv 2610.28259、2026-10-20)で、独自のツールフレームワーク GPT-GEAR を使って GPT-6 Astra に閉ループ操作を行わせ、シミュレーションと実環境で合計 2,000 回以上の試行を実施しました。著者報告によると、成功率は RoboTwin 2.0 で 76.0%、RoboDojo で 26.92% ですが、新たに提案した幾何制約ベンチマーク LIBERO-GeoMotion では 11.1% にとどまり、実機のゼロショット全体成功率は 40% です。エンジニアにとってより役立つのは 3 つのアブレーションで、深度・触覚・デモという身体性情報をどの形でモデルに渡すかによって、結果が大きく変わります。以下の数値はすべて著者報告 [R] で、本サイトでは再現していません。
GPT-GEAR:5 つのツールと、相対姿勢だけの動作インターフェース
論文は操作を部分観測の意思決定問題として定式化しています。各ターンでモデルは RGB 画像と自己受容状態、さらに実験条件に応じてカメラパラメータ、深度マップ、触覚信号を読み取り、ツールを 1 つ選んで引数を与えます。5 つのツールは次のとおりです。
- Observe:現在または過去の観測記録を読み出します。履歴の読み出しは読み取り専用で、画像の再撮影、シミュレータの進行、制御ステップの消費は起きません。
- Reference:最初の動作の前に、事前検証済みのデモパッケージを渡します。動画のキーフレーム、テキストの手順、動作軌跡、またはその組み合わせです。
- Act:物理状態を変える唯一のツールです。各アームについて、相対並進 Δp(メートル)、単位四元数による回転増分 Δq、グリッパ目標 g ∈ [0, 1]、ソルバーのステップ数上限を指定します。
- Status:環境のタスク完了判定を問い合わせます。
- Finish:対話を終了します。
実装の詳細も具体的です。GPT-6 Astra が唯一の計画コンポーネントで、ほかのロボット専用モデルは使いません。すべての実験は Codex 経由で実行され、推論強度は high に設定されています。1 ステップあたりの並進・回転増分はそれぞれ 0.01 m、0.05 rad に制限され、1 回の Act 要求は変位 0.20 m、回転 π/2 rad 以内、既定では 1 回の Act で最大 10 ネイティブ制御ステップを実行します。0.01 m の上限が各ステップの並進ベクトルの長さに適用されると仮定すると(論文が「ノルム」と明記しているのは 0.20 m の要求上限だけで、ステップごとの上限は軸ごとに適用される可能性もあります)、これらの数値から推算して(本サイトの計算)、既定設定では 1 回の Act で動けるのは最大 0.10 m です。論文によれば、動作の完了状況と残差姿勢誤差はフィードバックとしてモデルに返され、次の修正はモデルが判断します。コントローラは運動学と関節の制約を確認し、どちらかのアームの指令が無効なら両アームのステップを拒否します。論文は、これらの確認が衝突のない動作も把持の成功も保証せず、タスクに応じた動作計画はモデルの責任であると明記しています。
評価には注意すべき点が 1 つあります。シミュレーションでの成功は、モデル自身が完了を主張したかどうかとは無関係に、終了時に環境の公式判定で決まります。そして Status が問い合わせるのも同じ判定です。モデルは完了したと判断すると Status を呼び、通らなければ実行予算が尽きるまで実行を続けます。本サイトが読んだ本文には予算の具体的な値がなく、実機実験で何が完了を判断するのかも書かれていません。
3 つのアブレーション:渡すかどうかより、どう渡すか
3 つのアブレーションはそれぞれ少数のタスクで行われ、サンプル数も異なります。下表には主要な行だけを載せています。総トークンは 1 エピソードあたりの入力と出力の合計の平均です。
| アブレーション(タスク数 × タスクあたり試行数) | 条件 | 成功率 | 平均動作ラウンド | 平均総トークン |
|---|---|---|---|---|
| 深度(LIBERO-Plus、4 × 10) | RGB のみ | 47.5% | 34.61 | 1,046,755 |
| RGB + カメラパラメータ | 60.0% | 26.32 | 986,066 | |
| RGB + 真値からレンダリングした密な深度マップ | 67.5% | 24.23 | 1,101,271 | |
| RGB + 逆投影による点クエリツール | 60.0% | 27.00 | 1,377,672 | |
| デモ(LIBERO-Plus、5 × 10) | デモなし | 64.0% | 23.00 | 1,187,814 |
| 最初と最後のフレームのみ | 46.0% | 21.18 | 1,448,025 | |
| 動画のシーケンスフレーム | 64.0% | 20.72 | 1,442,084 | |
| テキストの手順 | 78.0% | 21.30 | 1,052,921 | |
| 動作軌跡 + 動画のシーケンスフレーム | 82.0% | 19.92 | 1,222,021 | |
| 動作軌跡 + テキストの手順 | 82.0% | 21.00 | 1,191,807 | |
| 動作軌跡 + 動画フレーム + テキストの手順 | 86.0% | 20.58 | 1,372,547 | |
| 触覚(UniVTAC、5 × 20) | RGB のみ | 14.0% | 10.57 | 423.90k |
| RGB + 触覚画像 | 30.0% | 10.53 | 646.06k | |
| RGB + テキスト形式の 3 軸の力の値 | 50.0% | 9.44 | 451.19k | |
| RGB + 触覚画像 + 力のテキスト | 48.0% | 9.75 | 553.36k |
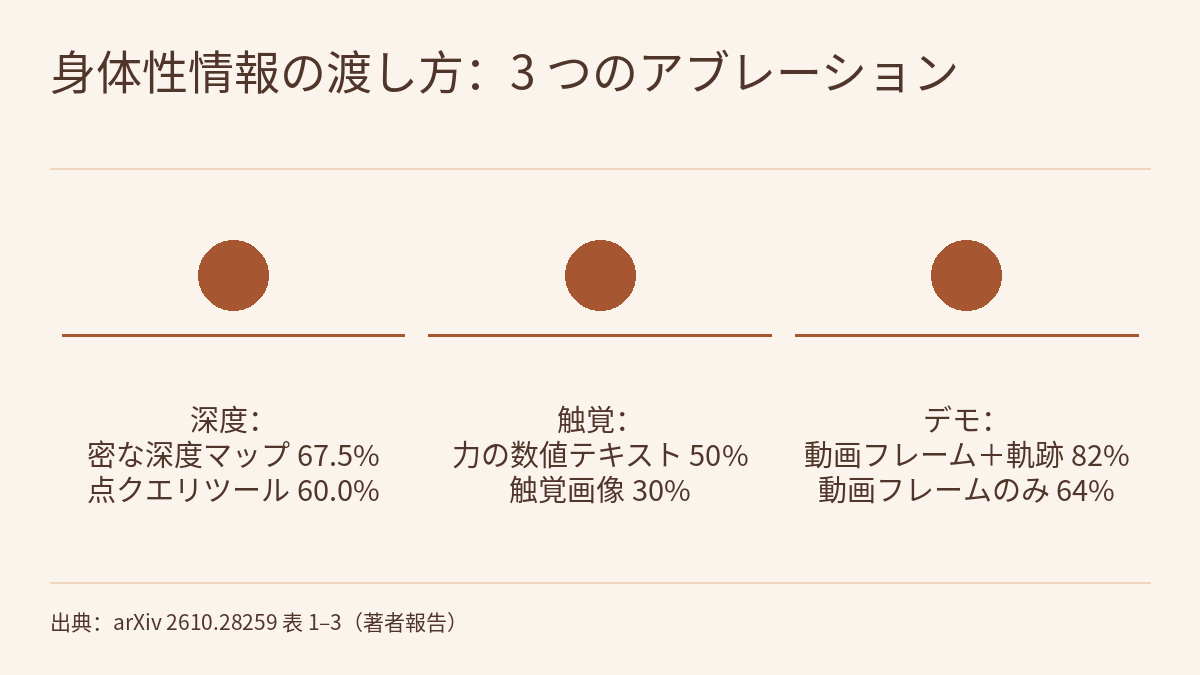
深度。カメラの内部・外部パラメータを加えるだけで、成功率は 47.5% から 60.0% に上がります。著者は、カメラパラメータが画像上の位置をロボットの作業空間に対応づける助けになったと考えています。動作前に対象物体の中心の深度を推定させると 62.5% で、3 つの例での真値との平均絶対誤差は 1.91、3.81、3.40 cm でした。正確な点座標は、かえって密な深度マップに及びません。逆投影ツールは 1 回の問い合わせで 1 点の 3 次元座標しか返さないため、モデルは自分で点を選び、座標を物体や空間と結びつける必要があり、トークンは RGB のみより 31.6%、深度マップ条件より 25.1% 多くなります。著者は、真値の深度を与えても失敗するタスクがあり、深度だけがボトルネックではないとも指摘しています。
デモ。最初と最後のフレームだけを与えると成功率は 46.0% に下がり、デモなしより低くなります。著者は、デモの場面が現在の場面と異なる場合、疎な画像が曖昧さを生むと見ています。テキストの手順は主にタスク理解を助け、動作軌跡は動作レベルの情報を加えます。視覚・テキストのどの文脈に軌跡を加えても、成功率は上がりました。著者は、デモの動作がそのまま再生されるのではなく現在の場面に合わせて調整されることを強調しています。全モダリティの組み合わせの 86.0% は、軌跡とテキストの 82.0% より約 18 万トークン多く消費します。このアブレーションのデモは、すべて同じタスクを異なる場面の摂動の下で実行したエキスパート軌跡です。
触覚。同じセンサーの読み取り値でも、触覚画像より力の値のテキスト(x・y・z の 3 軸成分)として渡すほうが良い結果になりました。成功率は 50.0% 対 30.0% で、トークンも少なくなります。著者の説明では、触覚画像が表すのは場面の見た目ではなく触点(タクセル)の応答であり、モデルには読み取りにくい可能性があります。両方を同時に与えても(48.0%)上乗せの効果はありませんでした。最良の条件でも半数のエピソードは失敗しています。
これらの差を読むときは、試行回数に戻して考える必要があります。深度は各条件 40 回なので 1 回が 2.5 ポイントにあたり、60.0% と 62.5% の差は 1 回だけです。デモは各条件 50 回で 1 回が 2 ポイント、触覚は各条件 100 回です。本サイトが読んだ本文には信頼区間も有意性検定もありません。試行回数が限られるときに差が信頼できるかを判断する方法は フィジカルAIラボ 1.8:評価 で練習しました。深度カメラや触覚センサーが実際にどんなデータを出すかは フィジカルAIラボ 1.3:センサー を参照してください。
5 つのベンチマーク:いくつかで上回り、1 つで明確に劣る
主実験では能力を組み合わせています。与えるのは RGB とカメラパラメータのみで、動作前に対象の深度推定を求めます。デモは動画のサンプリングフレーム、テキストの手順、動作軌跡を組み合わせ、UniVTAC では触覚フィードバックと真値の深度マップも追加で与えます。5 つのベンチマークは合計 164 タスクです。閉ループ評価のコストが高いため、著者は公式プロトコルを完全には実施せず、RoboCasa GR1 と UniVTAC はタスクあたり 20 回、ほかの 3 つは 10 回としました。比較手法の一部は著者がこのプロトコルで再評価し、残りは公式の報告値を使っています。
- LIBERO-Plus:83.50%。π0.5 の公式報告値 83.90% に近く、著者が再評価した starVLA-OFT と starVLA-π は 84.75% と 85.50% です。
- RoboTwin 2.0:76.00%。再評価した 2 位の OpenWAM-α を 9.20 ポイント上回ります。
- UniVTAC:72.50%。報告値の FTP-1(62.90%)と starVLA(56.10%)を上回ります。ただし、ここではモデルに触覚と真値の深度も追加で与えられています。
- RoboDojo:成功率 26.92%、プロセススコア 35.17 で、いずれも比較の中で最高であり、報告値の DM0.5(19.34%、24.90)を上回ります。著者も、どちらの絶対値もまだ低いと述べています。
- RoboCasa GR1:18.96%。報告値の π0(13.60%)は上回るものの、報告値の π0.5(37.00%)を下回り、再評価した starVLA-OFT(57.29%)と報告値の OpenWAM-α(60.50%)には大きく及びません。器用な多指ハンドを使う唯一のベンチマークで、著者は自由度の高さと複数の接触関係が一因だと推測しつつ、集計結果だけでは原因を確定できないとしています。
論文はこれらをゼロショットの結果と呼んでいますが、それはベンチマーク専用の方策学習もパラメータ更新もしないという意味で、モデルは文脈の中でデモを受け取っています。比較手法はいずれもそれぞれのロボットデータで学習済みです。いくつかのベンチマークで上回ったことは、汎用モデルが一部ですでに学習済み方策と肩を並べられることを示しますが、同じ条件でより強いことを示すものではありません。
能力ごとに分けると:理解はできるが、精密には実行できない
著者は 164 タスクに、実行結果ではなくタスクの要求に基づいて 6 種類の能力ラベルを付けており、1 つのタスクに複数のラベルが付くこともあります。集計成功率は、タスク理解 73.45%(426/580)、汎化 59.20%(817/1380)、記憶 56.67%(34/60)、長期実行 33.03%(218/660)、高次操作(向きの変更、回転、注ぐ動作、関節まわりの動作)34.62%(135/390)、精度 36.19%(380/1050)です。記憶は 6 タスクのみで、すべて RoboDojo のものです。著者自身、この比較はモデル単独の能力ではなくタスクの要求と難しさの違いを反映していると説明しています。結論は、「何をすべきか分かる」ことと「物理的にやり遂げる」ことの間に繰り返し差が現れる、というものです。
この差を直接調べるために、著者は LIBERO-GeoMotion を提案しました。LIBERO のアセットをもとに意味的な複雑さを抑え、精密な姿勢合わせ、並進と回転の協調、動作の物理的な結果の予測を要求するベンチマークです。GPT-6 Astra のゼロショット成功率は 11.1% でした。実機では、基本的なピック・アンド・プレースは確実にこなせる一方、ゼロショット全体の成功率は 40% にとどまり、一部の制約付きタスクは完全に失敗したと著者は報告しています。繰り返し見られた失敗は、安全でない把持構成、動作の実行可能性、精密な位置合わせに関わるもので、推論の遅延も実用的な展開を大きく妨げています。
本サイトがこれまで紹介した VLA の研究と比べると、本論文の出発点は異なります。方策を学習させるのではなく、汎用モデルが推論とフィードバックだけでどこまでできるかを測っています。Is Success All You Need? は同じ LIBERO-Plus の摂動スイートで、成功率が同程度の方策でも実行の質が大きく違いうることを示しました。本論文の動作ラウンド数とトークン数は、成功率以外のもう 1 つの記録です。デモが方策にどう効くかは、学習の観点から フィジカルAIラボ 1.6:模倣学習 で扱いました。本論文ではデモは文脈に入れるだけで、パラメータは変わりません。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者報告 [R] です。本サイトでは再現していません。本サイトが読んだ本文は第 5.2.3 節(記憶)までで、LIBERO-GeoMotion のタスク設計、実機実験、遅延データの本文は読めていません。これらは要旨と序論の記述だけに基づいているため、本記事では LIBERO-GeoMotion のタスク数、実機のタスク数、遅延の数値を示していません。
- ベンチマーク評価は公式プロトコルではなく、試行回数を減らしたものです。比較図には著者の再評価値と公式報告値が混在し、手法ごとに入力条件も異なります(たとえば UniVTAC では本モデルに触覚と真値の深度が追加されています)。
- 「ゼロショット」は学習もパラメータ更新もしないという意味で、主実験でもデモの文脈は与えられています。アブレーションのデモは同じタスクのエキスパート軌跡です。シミュレーションでは Status が環境の公式判定を問い合わせ、モデルは予算内で試行を続けられます。
- 上表の各条件の 1 エピソードあたり平均トークン数は約 42 万から 145 万です。これは API 使用量の記録であり、遅延や費用の測定ではありません。
- 論文にはプロジェクトページとコードリポジトリのアドレスが記載されていますが、本サイトでは開いておらず、コードが利用できるかは確認していません。
- コントローラの制約確認は衝突のない動作を保証しません。シミュレーションの成功率も小規模な実機結果もハードウェアの安全検証ではなく、著者自身も物理的な安全性を未解決の課題に挙げています。
リンク
- Large Multimodal Models for Direct Robot Control: GPT-6 as a Beginning(arXiv 2610.28259)
- 論文 HTML 全文
- フロンティア・レーダー|Is Success All You Need?:成功率が同程度の 2 つの VLA でも、成功軌道は大きく違いうる
- フィジカルAIラボ 1.3:センサー――1 つのコップで画素数、深度の測定範囲、握る力を手計算する
- フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読む
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)