この回の動画
ナレーションは AI 合成音声です。 動画の章・文字起こし・出典
文字起こし
文字起こし
知行の問い
目をつぶったまま、ロボットはコップの水を、こぼさずに持ち上げられるかな?これまでの二回で、ロボットは角度を計算し、モーターも安定させました。でも、まずは世界をはっきり見なければなりません。今回は、センサーの話です。
カメラ:色と形を見る
いちばんよくあるセンサーは、カメラです。色と形を写して、どれがコップかを見分けます。カメラは安くて、技術も成熟していて、多くのロボットに付いています。ロボットのいちばん大事な目です。ある深度カメラに付いたカラーカメラは、一千二百万画素。細かいところまで写り、色もはっきりしています。でも、色だけでは大きな問題があります。写真は平らです。コップが手からどれだけ離れているのか、分からないのです。見分けられても、届かない。色だけじゃ、距離が足りないんだ!
深度:画素ごとに距離を
そこで登場するのが、深度カメラです。一つひとつの画素に、距離をつけます。写真に、三つ目の数を足すようなものです。同じ装置では、深度の画像は百万画素です。一つひとつの点が、どれだけ遠いかを教えてくれます。おもしろいことに、深度の画像は、カラー画像より粗いことが多いのです。輪郭が分かれば十分で、そこまで細かくなくていいのです。距離はどう測るのでしょう?一つは、私たちの両目と同じやり方です。二つのレンズで同じ場所を見て、どれだけずれるかを比べ、距離を割り出します。もう一つは、光を出して、行って帰ってくるまでの時間を測るやり方です。遠ければ遅く、近ければ早く戻ってきます。距離が分かって、ロボットはようやく計算できます。手をどこへ伸ばし、どれだけ開き、いつ閉じるのか。でも、深度の測定にも弱点があります。近すぎても、遠すぎても、光を反射する物でも、うまく測れず、データが欠けてしまいます。深度カメラって、平らな写真に距離を足してくれるんだ!
力と触覚:触れたあと
見えることと、うまく触れることは別です。手がコップに触れたら、別の種類のセンサー、力が必要になります。六軸の力センサーは、どの向きに押されたか、ひねられたかを測れます。前後、左右、上下。それに、三つの向きのひねりです。ある力制御のロボットアームは、関節一つひとつに、トルクセンサーが埋め込まれています。軽く触れただけで、気づきます。力が分かって、ロボットはしっかりつかめているかが分かります。強すぎれば握りつぶし、弱すぎれば落とす。力こそが、ちょうどいい加減なのです。さらに細かいのが、触覚です。ある触覚センサーは、やわらかいゲルのパッドの裏に、小さなカメラを隠しています。パッドに押しつけられた模様を、カメラがくっきりとらえます。物がすべっているか、表面が粗いか、ぜんぶ触って分かるのです。たとえば、つかんだ物が下へすべりはじめると、触覚なら、早めに気づけます。手はすぐに、もう少し強く握ります。
固有感覚:自分の位置を知る
もう一つ、いちばん忘れられがちなのが、固有感覚です。ロボットが自分自身を感じる力。関節がそれぞれ、どこまで回ったかです。角度の計算も、角度の修正も、この二回はこれに頼っていました。関節のエンコーダーは、外を見なくても、姿勢が分かるのです。ロボットは目だけじゃなくて、触ったり、重さを感じたり、自分がどこにいるかも分かるんだ!実際の作業では、これらの感覚をいっしょに使います。目がコップを見つけ、深度が距離を教え、力が強さを加減する。固有感覚は、自分がどこにいるかを、いつも伝えます。これだけは覚えておいてください。一つのセンサーは、世界の一つの面しか見ていません。合わせて初めて、全体の場面になるのです。今回のページを開いてみましょう。同じコップをつかむ場面で、いくつかのセンサーの見え方を切り替えられます。深度に切り替えると、コップが浮き上がって見えます。力に切り替えると、触れた瞬間、力のバーが跳ね上がります。さらに触覚に切り替えて、コップの表面の模様が、パッドにどう写るかを見てみましょう。同じ瞬間でも、センサーごとに見えるものはちがいます。センサーはどれも完璧ではありません。カメラは暗さに弱く、深度は反射に弱く、力センサーにはノイズがあります。だから、校正も、互いの確かめ合いも必要です。ふりかえりです。ポイントは三つ。一つ、カメラは色と形を見るけれど、距離は分からない。二つ、深度は画素ごとに距離を与え、力と触覚は、接触と強さを受け持つ。三つ、固有感覚もあって、ロボットは自分がどこにいるかが分かる。だから目を閉じて水を運ぶのは、難しすぎる。ロボットは見て、測って、触らなきゃ!こんなにたくさんのセンサーで、こんなに何度も試すのは、実機じゃ遅すぎる。どこで練習する?また次回!
根拠と出典
関節ごとに · トルクセンサーを内蔵した力制御ロボットアーム。外からの接触力を推定し、衝突を感知する [O] · Franka Robotics · Franka Research 3 製品ページ
練習とセルフチェック
小テストは公開で、回答するとすぐ解説が出ます。読み物の練習問題の答えはログイン会員向けです。
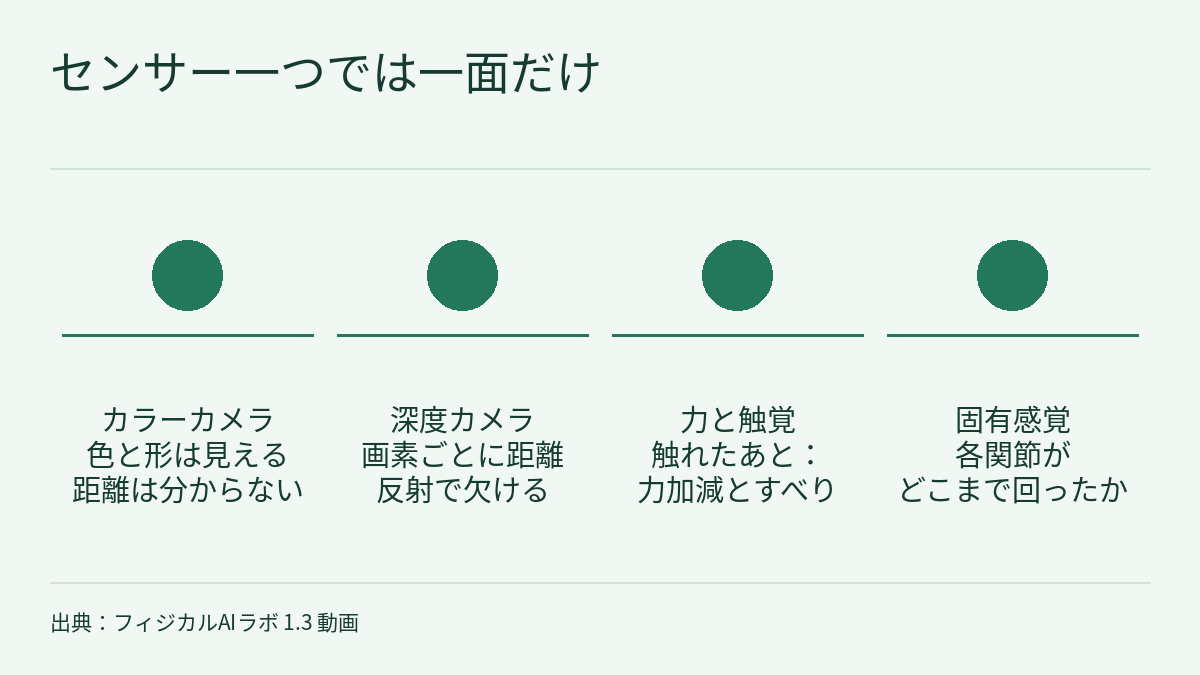
第 1.3 回の動画は「目をつぶったまま、ロボットはコップの水を持ち上げられるか」という問いから、4 種類のセンサーを説明しました。カラーカメラはコップを見分けられても距離は分かりません。深度カメラは画素ごとに距離を与えます。力と触覚は、触れたあとの力加減とすべりを受け持ちます。固有感覚によって、ロボットは自分の各関節がどこまで回ったかを知ります。動画は三つの証拠を引用しています。ある深度カメラ(Microsoft Azure Kinect DK)のカラーカメラは 1200 万画素、深度カメラは約 100 万画素であること。そして、ある力制御ロボットアーム(Franka Research 3)は関節ごとにトルクセンサーを内蔵していることです。このページはこの回の解説と練習です。文字起こしをくり返すのではなく、二つのメーカー資料に戻ります。まず「1200 万」と「100 万」を動作モードごとの実際の画像サイズに直します。次に架空のコップを使って、画像の中で何画素を占めるか、深度の測定範囲に入るか、誤差の上限はどれくらいかを手で計算します。さらに「関節トルクで接触力を推定する」という記述がどこまでを言っているかを整理し、最後にコップをつかむのに必要な力を一度手計算します。全体を通すルールは一つです。数字は、それを示した装置、モード、条件のもとでだけ成り立ちます。
このレッスンの動画、文字起こし、出典はこのページの上部にあります。シーズン全体の構成は講座の概要をご覧ください。前回のフィジカルAIラボ 1.2:PIDと制御周波数――3 つの項を手で計算し、周波数を周期に直すは、「誤差を直すには、まず正確に測らなければならない」という話で終わりました。このレッスンはその続きで、ロボットが何で測るのかを扱います。フィジカルAIラボ 1.1:座標系と運動学――2 リンクのアームがコップに届く計算を手で追うではカメラの読み値を土台の座標系に直す方法を、フィジカルAIラボ 0.3:見る・考える・動く――3 つの周波数をそれぞれのシステムに戻すでは「見る」が外の世界と自分自身の両方を含むことを扱いました。1.1 で使った 7 自由度と 1.2 で使った 1 kHz も Franka Research 3 の製品ページに由来します。このレッスンでは、同じページのトルクセンサーに関する文だけを使います。
公開小テストの 5 問には詳しい解説が付いています。ログインすると、三つの練習に取り組めます。架空の条件のもとで三つの距離それぞれに深度モードを選び、「画素は多いほどよい」に数字で答える課題、架空のつかみ動作ログからすべりの始まりを予測し、深度・エンコーダー・触覚の三つの読み値がそれぞれ何を示せるかを判断して、新しい握る力を決める課題、2 社のメーカーの仕様をつなぎ合わせた架空のセンサー計画を審査する課題です。どれにも段階的な解答例、よくある誤り、20 点満点の採点基準が付いています。
1. 三つの証拠と、それぞれが言っていること
二つは Microsoft のハードウェア仕様ページからです。Azure Kinect DK hardware specifications のページ(最終更新 2021-03-18 と表示)には次のようにあります。
Azure Kinect DK includes an OV12A10 12MP CMOS sensor rolling shutter sensor.
Azure Kinect DK integrates a Microsoft designed 1-Megapixel Time-of-Flight (ToF) depth camera using the image sensor presented at ISSCC 2018 .
一つは Franka Robotics の製品ページからです。Franka Research 3 のページには次のようにあります。
The torque sensors integrated at each joint finely estimate external contact forces, and the fast control loop enables prompt reaction to collisions.
この三つの文を読むときの注意点は三つあります。
- どれもメーカー自身の記述です。講座の分類ではいずれも O 級で、Microsoft と Franka Robotics が自社製品について述べたものです。本サイトは独自に測定していません。
- 言っているのはセンサーのことで、1 枚 1 枚の画像のことではありません。「12MP」はカラーのイメージセンサーを、「1-Megapixel」は深度カメラを説明しています。同じページには動作モードごとの解像度も載っていて、実際に得られる画像の大きさはどのモードを選ぶかで決まります。第 2 節で一つずつ換算します。
- 2 社の、2 台の装置です。動画は「ある深度カメラ」「ある力制御ロボットアーム」と言っていますが、これらは同じロボットの部品ではありません。二つの資料にある解像度、フレームレート、制御周波数は、それぞれの装置のものです。一台のロボットの仕様としてまとめることも、どちらが速いかを比べることもできません。
ログインすると、このレッスンの続きと確認問題、解答を読めます。
制約と注意点
- Azure Kinect DK のセンサー画素数、動作モード、測定範囲、誤差、工場での校正はいずれも Microsoft の仕様ページから、Franka Research 3 の関節トルクセンサー、FCI の測定項目、現場での校正はいずれも Franka Robotics の製品ページから取っています。どれも O 級のメーカー記述で、本サイトは独自に測定していません。Microsoft のページは最終更新 2021-03-18 と表示されています。このレッスンのために取得した時点で、このアドレスは Microsoft Learn の previous-versions(旧バージョン)にある同名のページへ転送されていました。
- 第 2 節の画素数は、記載の解像度をこのレッスンで掛け算したものです。「コップが占める画素」は視野角を画素に均等に割り振った概算で、等角の写像を仮定したときの 1 度あたりの平均画素数を表しています。仕様ページはレンズのモデルを示しておらず、ピンホールモデルでは数字が変わります(第 2 節)。二つのカメラの位置関係も無視しており、実測ではありません。
- 第 3 節の 0.40 m、1.20 m、3.00 m と 10 mm という課題の要求、第 4 節の 0.35 kg、0.45 kg、μ = 0.5、3.6 N は、いずれも練習用の仮定です。動画の実験ページや実在のシステムのパラメーターではありません。第 4 節の摩擦モデルは、2 本指の静止摩擦で重さを支えることだけを考え、コップの形、加速度、指のやわらかさを無視しています。
- 67 ピコ秒は、動画の「光の往復」という簡単な説明にもとづく計算で、Azure Kinect DK の測距原理や時間分解能ではありません。
- 動画に出てくるゲルパッドの触覚センサーと六軸力センサーについて、このレッスンは一次資料を引用しておらず、動画の説明に従っているだけです。「反射でデータが欠ける」についても、仕様ページに対応する数字はありません。
- 実験ページの読み値はシミュレーションの値です。第 5 節の記録表は講座からの提案で、本記事は実験ページの実装を確認していません。
- 第 6 節の三つの距離、30 FPS と 15 画素の条件、チームメイトの発言、つかみ動作ログのすべての読み値、指 1 本あたり 4.0 N、0.50 kg、1.5 倍の余裕、指 1 本あたり 10 N の耐えられる上限、μ = 0.3、チーム V とその計画書の文は、すべて練習用の架空のものです。求めた約 65、26、12 画素、約 2.6 m、約 0.408 kg、約 3.6 s、約 7.36 N、約 12.26 N などは、これらの仮定と本講座の等角の約束のもとでだけ成り立ちます。ログの触覚の表示がモデルの予測と一致するのは問題を作るときの設定で、どのセンサーのふるまいでもありません。三段階の判定と書き直しの案は講座からの提案で、Microsoft や Franka Robotics の結論ではありません。紙の上の計算はハードウェアの安全性の検証ではありません。
リンク
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)
- フィジカルAIラボ 1.4:シミュレータの地図――刻み幅のコストを数え、接触で軌道が分かれる点を読み、3 つの高速化の比較対象を確かめる(次のレッスン)
- フィジカルAIラボ 1.2:PIDと制御周波数――3 つの項を手で計算し、周波数を周期に直す
- フィジカルAIラボ 1.1:座標系と運動学――2 リンクのアームがコップに届く計算を手で追う
- フィジカルAIラボ 0.3:見る・考える・動く――3 つの周波数をそれぞれのシステムに戻す
- Microsoft Learn:Azure Kinect DK hardware specifications
- Franka Robotics:Franka Research 3 製品ページ