把人类第一视角视频转成机器人数据,现有流程大多搬运手和手臂的运动轨迹。预印本 Ego2X(arXiv 2611.24138,2026-11-18)的作者指出,单目估计的手沿相机视线会漂移几厘米,而稳定的操作要求物体表面上毫米级的精度,于是重定向后的手指悬在物体旁边,平行夹爪在空处合拢。Ego2X 改为把每一次接触记在物体坐标系里,再用这些接触去驱动灵巧手或平行夹爪,最后在 RoboTwin 2.0 仿真中闭环回放,只保留真正完成任务的片段。以下数字均为作者报告 [R],本站未复现;论文写明真机部署尚未完成。
本站课程 物理AI实验室 1.5 讲过人类视频量大,但“人手不是机器手”,要先翻译成机器手才能用。此前介绍的 EgoJEPA 绕开重定向、直接学潜动作;DexStitch 用接触引导的修补把人类视频转成灵巧手数据。Ego2X 仍走重定向路线,区别在于被迁移的对象换成了物体上的接触,并把仿真里的物理验证当作数据能否进入训练集的条件。
CORE 为每个接触记录什么
Ego2X 的核心是 CORE(Contact-centric Object-interaction REpresentation)。每一帧、每一个接触都有一条四元记录:
- 位置:接触的 MANO 手部区域、物体坐标系下的表面锚点和外法向。
- 力先验:各区域的相对载荷份额、推压方向,以及一个法向支撑力的下界。
- 抓取模式:按手掌和各指节哪些区域接触物体,分为掌托、力量抓握、中间抓握、指尖持握、精确捏取、钩握和未知七种,每种对应机器人上要用的接触垫。
- 交互状态:Approach、Acquire、Hold、Transport、Release 五种,用来同步夹爪开合、视频中物体像素的保护和仿真路径点。
接触位置的求法依据一个观察:单目手部深度沿视线漂移,2D 投影却定位得准。Ego2X 先用 EgoTac 从画面的触觉外观判断接触时刻,再从相机中心沿手部顶点的像素射线,求它与物体有符号距离场(由 SAM 3D 重建的网格得到)的第一个交点。每个锚点再按掌面朝向、相邻指节是否穿透、是否随物体刚性运动和 2D 遮挡顺序分成 Certified、Trusted、Hypothesis、Uncertain 四级,只有前两级参与下游的深度修正和逆运动学,后两级只用来维持时间上的连续。
论文明确说,没有触觉传感器时,单目 RGB 无法唯一确定以牛顿计的抓握内力。CORE 的力只是先验:相对份额来自 EgoTac 的预测强度归一化;支撑力下界用网格体积乘 0.5、1.0、1.5 g/mL 三档参考密度估出物体质量,乘以质心加速度减去重力加速度的模,再按手所承担的份额和各区域份额分配。
从一段视频到一个 LeRobot episode
输入是一段单目第一视角视频和目标机器人的 URDF,输出是一个经过验证的 LeRobot episode,含机器人动作、训练掩码和保留了被持物体的视频。中间有四步:
- 解耦的深度修正:如果用手去定物体的尺度,再用物体去修正手的深度,两者的误差会循环耦合。Ego2X 把物体和手分成两条路径;手只沿根部相机射线在 −150 到 +50 mm 内平移,用 Certified 和 Trusted 的顶点–锚点对构成的 Cauchy 目标选出平移量。
- 跨形态重定向:一个 URDF 编译器把机器人连杆的碰撞网格采样成与抓取模式匹配的接触垫。灵巧手的逆运动学把接触垫拉向 CORE 锚点;平行夹爪则在物体距离场上搜索与夹爪开口匹配的对跖接触对,每个接触区间锁定一个物体坐标系下的抓取位姿。
- 按接触状态合成视频:在 Acquire、Hold、Transport 状态下,擦除人手臂时扣除物体保护区,避免把被拿着的物体一起修补掉;接触边缘再按 Lab 颜色剔除残留的肤色像素,然后叠加渲染的机器人。
- 仿真闭环验证:在 RoboTwin 2.0 中回放,只保留物理上通过检查的 rollout,用于 VLA 后训练。
几何与接触指标,各有各的条件
摘要里的“接触中手部深度误差降低 33.7%”来自 HOT3D 上一个较窄的设置:手部估计用 HaWoR、共 6 个片段、使用数据集提供的物体位姿,沿射线的误差从 14.35 mm 降到 9.51 mm。换成 EgoHand 估计(10 个片段),同一误差从 51.71 mm 降到 44.41 mm,降幅 14.1%。物体位姿改用估计值时,接触中物体平移误差的中位数在 8 个片段的确认集上从 104.6 mm 降到 67.3 mm,在 11 个片段的留出集上从 141.9 mm 降到 99.1 mm,平均分别减少 30.4 mm 和 47.3 mm。
物体位姿的来源对接触恢复影响很大。用数据集位姿时,CORE 在 31 个片段上的帧级 F1 为 0.924;改用 FoundationPose 估计的位姿(19 个片段),原始帧级 F1 只有 0.191,加入物体深度融合后为 0.386。
EgoDex 上的重定向比较(论文表 4 和表 5):
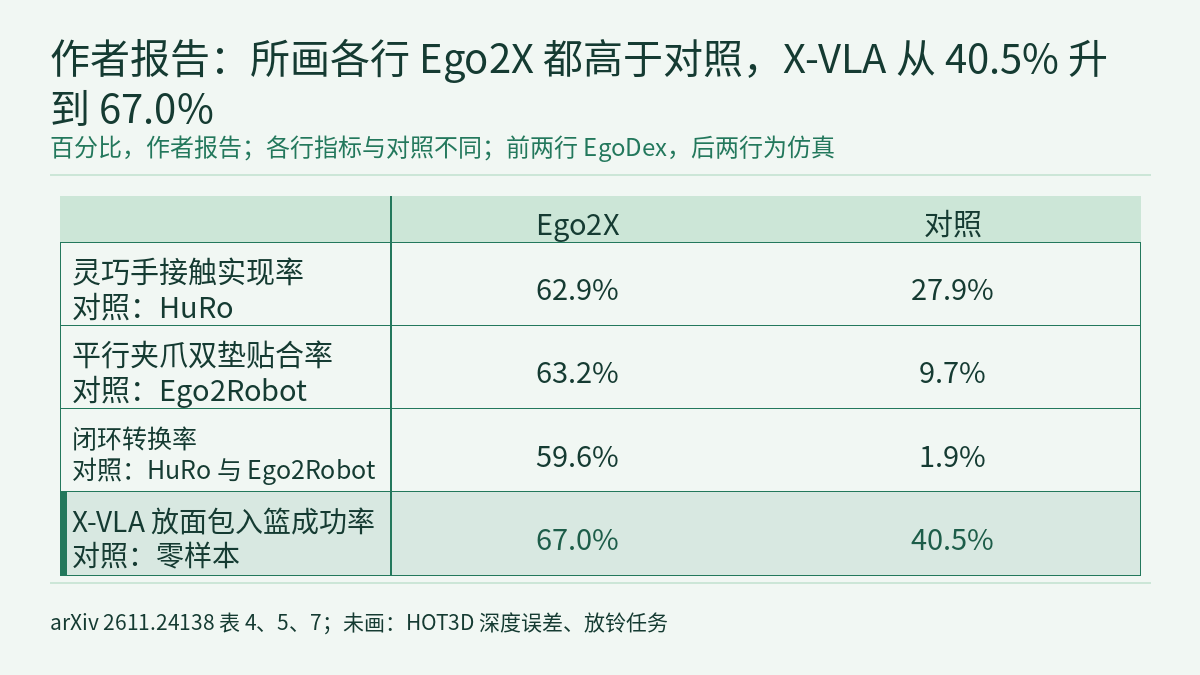
- 灵巧手:79 个 take、25,549 个接触槽位,以接触垫的有符号距离落在 −5 到 +10 mm 内为“实现”。Ego2X 的实现率为 62.9%,官方 HuRo stage-8 为 27.9%,配对检验 p = 2.6 × 10⁻¹⁴。只跟随手腕的消融为 29.6%,与 HuRo 接近;这个消融与 Ego2X 共用前端、手腕目标和求解器,只去掉接触项,所以差距可归到接触项上(本站据对照设计推断)。估计出的人手 MANO 本身在全部槽位上也只有 35.8%。关节速度保持在 7.5 rad/s 以内(HuRo 为 63.9 rad/s),整手穿透比例 4.4% 对 4.1%,p = 0.393。
- 平行夹爪:28 个手侧、1,272 个持握帧上,双垫贴合率 63.2%,Ego2Robot 为 9.7%。对照条件不同:Ego2X 和 HuRo 用单目 RGB 重建的手,官方 Ego2Robot 用设备追踪的 3D 手部数据。
- 五种夹爪:从同一份 CORE 记录编译到 Panda + 2F-85、ARX5、Franka Hand、UR5 + WSG50 和 Piper,末端实现率 0.796–0.820;固定桌边安装下的整臂逆运动学一项从 0.032(Piper)到 0.695(UR5 + WSG50)。
视频合成方面,3 个经过像素审核的 take 上,不做物体保护时擦除手臂会抹掉 19.4%–55.0% 的可见被持物体像素,按 CORE 区间保护后降到 3.0%–11.2%;14 个未见过的 EgoDex take(663 帧)上,接触边缘的肤色渗出从 12.55% 降到 0.00%。
仿真验证与 X-VLA 后训练
在 RoboTwin 2.0 中,同样的仿真检查下,Place bread in basket 的 52 段配对视频里 Ego2X 转换成功 31 段(59.6%),HuRo 和 Ego2Robot 各 1 段(1.9%)。Place bell on scale 的 53 个规格中 Ego2X 得到 45 个(84.9%),两个基线都是 0/53。论文正文把这些视频称为 matched videos,没有在这一节展开其来源。
随后作者不用任何仿真示范,只用 Ego2X 转换的片段后训练 X-VLA,在 200 个配对场景上评测 Place bread in basket(论文表 7,p 值为相对零样本、经 Holm 校正的精确 McNemar 检验):
| 训练数据 | 片段数 | 成功率 | 与零样本比较 |
|---|---|---|---|
| 零样本 X-VLA | 0 | 40.5% | 基线 |
| Ego2X,两组未筛选数据池 | 55 / 73 | 41.0% / 44.5% | 不显著 |
| Ego2X,仿真验证通过(P70) | 70 | 63.5% | p = 7.4 × 10⁻⁶ |
| Ego2X,仿真验证通过、按布局加权(55 lw) | 55 | 67.0% | p = 5.0 × 10⁻⁷ |
| 仿真专家示范(参考) | 20 | 72.0% | 参考 |
从这张表能读到两点。第一,同一来源的转换数据,未经验证时成功率停在零样本附近,过了仿真检查才升到 63.5% 和 67.0%。第二,67.0% 仍低于 20 条仿真专家示范的 72.0%,论文没有给出这两者之间的检验。结论部分所说的“提升 26.5%”是 67.0% 与 40.5% 之差,单位是百分点。
其他结果:在最初的 50 个场景上(零样本 44.0%),验证后的 Ego2X 为 70.0%,用 HuRo 和 Ego2Robot 各自仅有的 1 段验证数据训练分别为 2.0% 和 4.0%。3 个种子的联合训练(20 条仿真示范加 24 条未筛选片段)中,加入 HuRo 数据让仅用仿真示范时的成功率下降 7.5 个百分点,Ego2X 比 HuRo 高 5.5 个百分点,95% 区间 [+0.7, +10.3]。Place bell on scale 上(200 个场景,零样本 17.0%),40 条未筛选片段为 27.0%,40 条 zero-retry 片段配任务对应的提示词为 55.0%,配固定占位提示词为 48.0%(195 个场景)。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。作者写的是“将会公开”转换流程和带 CORE 标注的数据集,本站没有核对是否已经发布。
- 没有真机结果。论文的 Future Work 写明,受硬件和时间限制,真机部署仍在进行。所有策略成功率都来自 RoboTwin 2.0 仿真中的两个任务;仿真成功率不是硬件安全验证。
- CORE 的力是视觉与运动学先验,不是经过传感器标定的牛顿力,作者计划通过触觉集成来解决。
- 作者承认,严重遮挡下的接触定位受物体位姿估计误差限制;上文估计位姿下帧级 F1 为 0.386,与数据集位姿下的 0.924 相差很大。
- 33.7% 只对应 HaWoR、6 个片段、数据集物体位姿这一设置。各项几何指标的样本较小(6–31 个片段,合成审核 3 个 take),各对照的输入条件也不同,尤其是 Ego2Robot 用了设备追踪的手部数据。
- 本文依据论文的 arXiv HTML 正文,没有核对补充材料。