多视角 VLA 通常只在机器人基座坐标系下接受动作监督,每个相机画面和基座坐标系下的位移怎样对应,要靠模型自己学,相机换个位置或机器人换个初始姿态就容易失效。预印本 OVOA-VLA(arXiv 2611.26161,2026-11-19,中山大学与 X-Era AI Lab)用已知的相机外参把同一段示范的状态和动作换算到每个相机坐标系,为每个视角加一个动作专家去预测,训练后还可以去掉这些专家,只用基座专家推理。以下数字均为作者报告 [R],本站没有复现。
本站 物理AI实验室 1.1 讲过:同一只杯子在相机眼里和底座眼里坐标不同,机器人要把相机看到的位置换算到底座坐标系,手才知道往哪伸。OVOA-VLA 做的是反方向的换算:把底座坐标系下的示范动作换到每个相机坐标系,当作额外的训练目标。VLA 主干与动作输出的基本结构见 物理AI实验室 3.1。
一段示范怎样变成多份动作标签
论文的机器人状态是基座坐标系下末端的绝对位置、朝向和夹爪状态,动作是末端的平移增量、相对旋转和夹爪指令。对第 i 个相机,已知从基座到该相机的刚体变换 T_bc(旋转部分 R_bc):
- 状态:末端位姿左乘
T_bc,得到相机坐标系下的位置和朝向;夹爪状态不变。 - 动作:
Δp_c = R_bc · Δp_b,ΔR_c = R_bc · ΔR_b · R_bcᵀ,再把旋转矩阵转回旋转向量;夹爪指令不变。 - 腕部相机的外参随时间变化。LIBERO 和 MimicGen 上,动作块里每一步用该时刻的腕部外参;VLABench 和真机 Franka 上,整个动作块用观测时刻的外参,重新规划时更新。
这样不需要额外标注,同一个物理动作在每个视角下都有一份与画面对齐的标签。代价是训练数据必须带准确的相机外参,真机实验里作者为此做了相机标定(细节在附录 D.2)。
两张注意力图和 Cross Graph Consistency
模型以 π0.5 为起点,用 Mixture of Transformers 结构:一个基座专家看全部视角的视觉词元和基座坐标系状态,每个视角另有一个专家,只看自己那一路画面、输入该相机坐标系下的状态、预测该坐标系下的动作。所有动作专家共享视觉-语言主干,并用 π0.5 原有动作专家的权重初始化。
专家之间的信息流由两张有向注意力图控制,两者共享参数,只是注意力掩码不同:
- B→R:视角专家的动作词元可以看基座专家的动作词元,反方向被屏蔽。视角专家的损失通过这些注意力连接回传到基座专家,而基座的预测不依赖视角专家的特征。
- R→B:方向相反,基座专家可以利用视角专家的动作特征。
两张图里,不同视角专家之间都不能直接互看。训练时每个样本在两张图下各前向一次,输入、flow 时间步和噪声都相同。两次得到的基座动作对应同一个目标,Cross Graph Consistency(CGC)用均方误差拉近它们,每次随机选一边做 stop-gradient(各 0.5 概率)。损失权重:基座 1,每个视角专家 0.1,CGC 0.02。
推理有两种模式,执行的都是基座坐标系动作。Full 模式用 R→B 图,需要所有专家;Base-only 模式用 B→R 图,基座不看视角专家,所以可以把它们删掉,但仍输入全部视角的画面。
LIBERO-Plus:两种模式各有长处
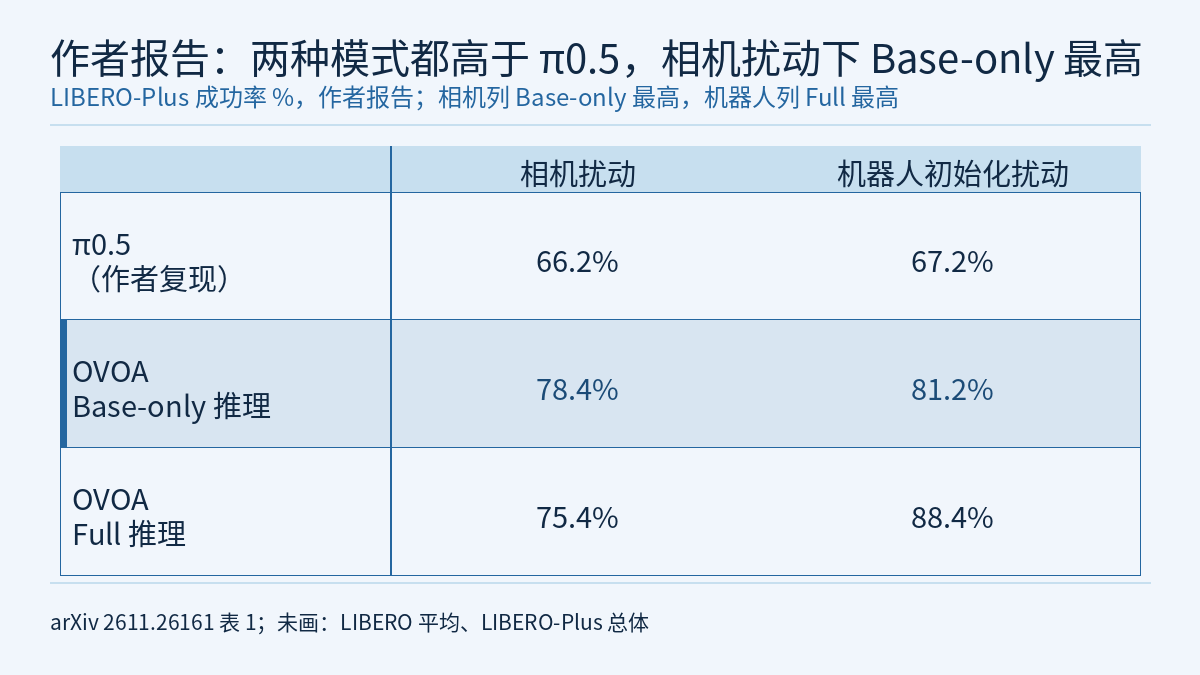
每个基准各训练一个模型,30,000 步,batch size 32。LIBERO-Plus 用 LIBERO 训练出的模型零样本评测,总体成功率覆盖 10,030 个评测实例。论文表 1 中与 π0.5 的对比如下(π0.5 由作者用相同数据与训练设置复现,单位为成功率 %):
| 模型 | LIBERO 平均 | LIBERO-Plus 相机扰动 | LIBERO-Plus 机器人初始化扰动 | LIBERO-Plus 总体 |
|---|---|---|---|---|
| π0.5(作者复现) | 92.6 | 66.2 | 67.2 | 77.4 |
| OVOA-VLA Base-only | 96.3 | 78.4 | 81.2 | 85.7 |
| OVOA-VLA Full | 98.7 | 75.4 | 88.4 | 88.1 |
相机扰动下 Base-only 的 78.4% 高于 Full 的 75.4%;机器人初始化扰动下 Full 的 88.4% 高于 Base-only 的 81.2%。作者的解释带有“可能”的语气:Base-only 不直接依赖与视角相关的动作特征,对视角变化可能更不敏感;机器人初始化扰动改变的是所需的运动,Full 可以借用其他坐标系的动作特征。消融(表 4)与这个分工一致:只用 B→R 图训练时相机扰动 79.1%,只用 R→B 图时机器人扰动 85.4%;把两个方向放进同一张双向图,相机 77.1%、机器人 71.7%,两边的优势都没保住。在两张图联合训练(74.1%、86.8%)的基础上,CGC 再带来 1.3 和 1.6 个百分点。
其他基准上,作者报告 VLABench Track 1 平均成功率从 π0.5 的 42.2% 升到 56.8%(Base-only)和 60.6%(Full),MimicGen 十个 D0 任务从 64.4% 升到 72.7% 和 75.3%。
Base-only 的推理代价与 π0.5 相当
论文表 5 在同一块 NVIDIA RTX PRO 6000D 上测量,batch size 1、10 个去噪步,延迟取 100 次平均:
- π0.5:254.65 GFLOPs,峰值显存 10.56 GB,延迟 63.07 ms,LIBERO 92.6%。
- Full(R→B):263.79 GFLOPs,19.12 GB,103.07 ms,98.7%。显存和延迟分别约增加 81% 和 63%。
- Base-only:254.66 GFLOPs,10.49 GB,62.77 ms,96.3%。
FLOPs 差别小,因为计算量主要在共享的视觉编码器和 PaliGemma 前缀编码,动作专家只处理很短的词元序列。表里还有一行:保留视角专家、用 B→R 图推理,LIBERO 为 97.0%,比 Base-only 的 96.3% 高 0.7 个百分点。按论文对 B→R 的定义,这两种情况下基座专家拿到的输入相同,正文没有解释这个差。论文没有报告种子数或区间,本站无法判断这 0.7 个百分点是否在评测随机性范围内。
真机:Franka Research 3 上只测了 Base-only
真机实验用 7 自由度的 Franka Research 3,输入一个固定第三人称相机和一个腕部相机。六个任务(三个短程、三个长程)各用 GELLO 遥操作采 50 条示范,合起来训练一个多任务策略,所有真机评测都用 Base-only 模式。
- 分布内:每个任务 20 次 rollout,平均成功率 77.5%,π0.5 为 72.5%,差 5.0 个百分点;三个长程任务从 65.0% 升到 73.3%。
- 空间分布偏移:选三个任务,两种未见过的固定相机视角(腕部相机不变),加两种扰动后的末端初始位姿,每个任务每种配置 5 次 rollout,零样本、不重新训练。合并后成功率从 π0.5 的 28.3% 升到 58.3%,三个任务上 OVOA-VLA 都更高。
按这些设置推算(本站计算,论文没有直接写出),偏移实验每个方法共 60 次 rollout,28.3% 和 58.3% 约为 17 次和 35 次成功;分布内实验每个方法 120 次,5.0 个百分点约是 6 次成功之差。论文没有给出区间。样本量与区间的关系可以对照 物理AI实验室 2.8 的 Wilson 区间算法自己核算。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。本站读到的正文没有报告多个训练种子、置信区间,也没有提到代码或权重是否发布。
- π0 和 π0.5 是作者复现的结果;表 1 中其余基线未标复现,评测条件可能与本文不完全一致。
- 方法依赖准确的相机外参来构造训练标签。按方法定义,Full 推理时视角专家需要相机坐标系下的状态,因而需要测试时的外参;正文没有说明 LIBERO-Plus 相机扰动下 Full 模式用的是哪组外参(本站推断,可能写在附录中)。
- 真机偏移实验只覆盖三个任务、每种配置 5 次 rollout,按偏移类型分开的结果在附录 D.3,本站没有读到;示范采集时第三人称相机固定不动。
- LIBERO、LIBERO-Plus、VLABench 和 MimicGen 都是仿真;仿真成功率和少量真机 rollout 都不是硬件安全验证。
- 本文依据 arXiv HTML 正文,附录只读到表 7 之前的部分。
链接
- One View, One Action: Spatially Generalizable VLAs through Observation-Aligned Experts and Cross Graph Consistency(arXiv 2611.26161)
- 论文 HTML 全文
- 物理AI实验室 1.1:坐标系与运动学,手算一条两连杆手臂怎样够到杯子
- 物理AI实验室 3.1:VLA 拆解,把一个放杯动作编成 256 个区间的词元,再给三个模型的参数量与频率标清口径
- 物理AI实验室 2.8:可复现评测,手算 Wald 与 Wilson 区间,从 1/√n 定评测次数,再给零失败算出失败率上界
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)