マルチビューの VLA は通常、ロボットのベース座標系でしか動作の教師を受けません。各カメラの画像とベース座標系での変位の対応はモデルが自力で学ぶしかなく、カメラの位置やロボットの初期姿勢が変わると崩れやすくなります。プレプリント OVOA-VLA(arXiv 2611.26161、2026-11-19、中山大学と X-Era AI Lab)は、既知のカメラ外部パラメータを使って同じデモの状態と動作を各カメラ座標系に変換し、視点ごとに動作エキスパートを追加して予測させます。学習後はこれらのエキスパートを外し、ベースエキスパートだけで推論することもできます。以下の数値はすべて著者報告 [R] で、本サイトでは再現していません。
本サイトの フィジカルAIラボ 1.1 では、同じコップでもカメラから見た座標とベースから見た座標は異なり、カメラで見た位置をベース座標系に換算して初めて手の伸ばし先が決まる、と説明しました。OVOA-VLA が行うのはその逆向きの換算です。ベース座標系のデモ動作を各カメラ座標系に移し、追加の学習目標として使います。VLA のバックボーンと動作出力の基本構造は フィジカルAIラボ 3.1 を参照してください。
1 本のデモから複数の動作ラベルを作る方法
論文でのロボットの状態は、ベース座標系におけるエンドエフェクタの絶対位置、姿勢、グリッパ状態です。動作はエンドエフェクタの並進増分、相対回転、グリッパ指令です。i 番目のカメラについて、ベースからそのカメラへの剛体変換 T_bc(回転成分 R_bc)が既知とします。
- 状態:エンドエフェクタの姿勢に左から
T_bcを掛け、カメラ座標系での位置と姿勢を得ます。グリッパ状態はそのままです。 - 動作:
Δp_c = R_bc · Δp_b、ΔR_c = R_bc · ΔR_b · R_bcᵀとし、回転行列を回転ベクトルに戻します。グリッパ指令はそのままです。 - 手首カメラの外部パラメータは時間とともに変わります。LIBERO と MimicGen では動作チャンクの各ステップにその時刻の手首外部パラメータを使い、VLABench と実機の Franka ではチャンク全体に観測時刻の外部パラメータを使って、再計画のたびに更新します。
追加のアノテーションは不要で、同じ物理的な動きに対して、各視点の画像とそろったラベルが得られます。その代わり、学習データには正確なカメラ外部パラメータが必要です。実機実験では著者がカメラのキャリブレーションを行っています(詳細は付録 D.2)。
2 つのアテンショングラフと Cross Graph Consistency
モデルは π0.5 を出発点とし、Mixture of Transformers 構造を採ります。ベースエキスパートは全視点の視覚トークンとベース座標系の状態を見ます。視点ごとのエキスパートは自分の視点の画像だけを見て、そのカメラ座標系での状態を入力し、同じ座標系での動作を予測します。すべての動作エキスパートは視覚言語バックボーンを共有し、π0.5 の元の動作エキスパートの重みで初期化されます。
エキスパート間の情報の流れは 2 つの有向アテンショングラフで制御します。両者はパラメータを共有し、アテンションマスクだけが異なります。
- B→R:視点エキスパートの動作トークンはベースエキスパートの動作トークンを参照でき、逆方向は遮断されます。視点エキスパートの損失はこのアテンション接続を通じてベースエキスパートにも逆伝播しますが、ベースの予測は視点エキスパートの特徴に依存しません。
- R→B:方向が逆で、ベースエキスパートが視点エキスパートの動作特徴を利用できます。
どちらのグラフでも、異なる視点エキスパート同士は直接参照し合えません。学習時は各サンプルを両方のグラフで 1 回ずつ順伝播し、入力、flow のタイムステップ、ノイズはそろえます。得られる 2 つのベース座標系動作は同じ目標に対応するため、Cross Graph Consistency(CGC)が平均二乗誤差で両者を近づけます。stop-gradient をかける側は毎回ランダムに選びます(確率は各 0.5)。損失の重みはベース 1、各視点エキスパート 0.1、CGC 0.02 です。
推論モードは 2 つあり、どちらもベース座標系の動作を実行します。Full モードは R→B グラフを使い、すべてのエキスパートが必要です。Base-only モードは B→R グラフを使います。ベースが視点エキスパートを参照しないのでそれらを削除できますが、全視点の画像は引き続き入力します。
LIBERO-Plus:2 つのモードはそれぞれ得意な条件が違う
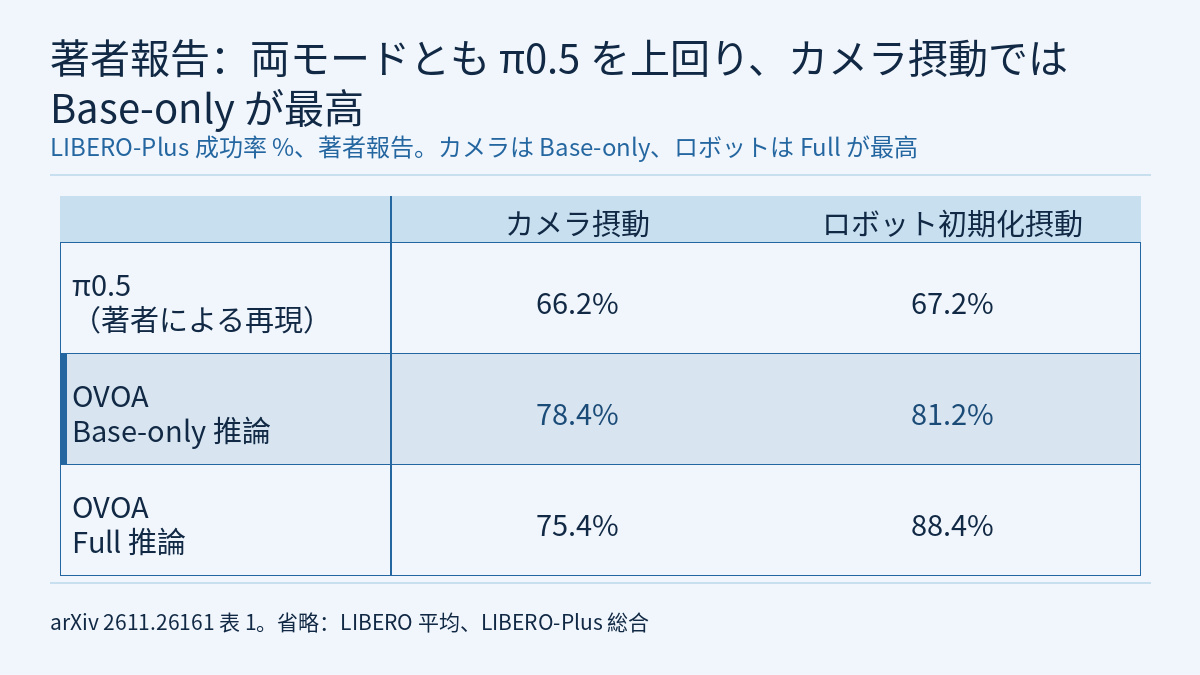
ベンチマークごとに 1 つのモデルを 30,000 ステップ、バッチサイズ 32 で学習しています。LIBERO-Plus は LIBERO で学習したモデルをゼロショットで評価し、総合成功率は 10,030 件の評価インスタンスを対象とします。論文の表 1 にある π0.5 との比較は次のとおりです(π0.5 は著者が同じデータと学習設定で再現したもの。単位は成功率 %)。
| モデル | LIBERO 平均 | LIBERO-Plus カメラ摂動 | LIBERO-Plus ロボット初期化摂動 | LIBERO-Plus 総合 |
|---|---|---|---|---|
| π0.5(著者による再現) | 92.6 | 66.2 | 67.2 | 77.4 |
| OVOA-VLA Base-only | 96.3 | 78.4 | 81.2 | 85.7 |
| OVOA-VLA Full | 98.7 | 75.4 | 88.4 | 88.1 |
カメラ摂動では Base-only の 78.4% が Full の 75.4% を上回り、ロボット初期化摂動では Full の 88.4% が Base-only の 81.2% を上回ります。著者の説明は「可能性がある」という控えめな書き方です。Base-only は視点に依存する動作特徴に直接頼らないため視点の変化に鈍感になりうる一方、ロボット初期化摂動は必要な動き自体を変えるので、Full は他の座標系の動作特徴を活用できる、というものです。アブレーション(表 4)もこの役割分担と整合します。B→R グラフだけで学習するとカメラ摂動で 79.1%、R→B グラフだけだとロボット摂動で 85.4% です。両方向を 1 つの双方向グラフにまとめるとカメラ 77.1%、ロボット 71.7% となり、どちらの長所も残りませんでした。2 つのグラフの同時学習(74.1%、86.8%)に CGC を加えると、さらに 1.3 ポイントと 1.6 ポイント上がります。
ほかのベンチマークでは、VLABench Track 1 の平均成功率が π0.5 の 42.2% から 56.8%(Base-only)と 60.6%(Full)に、MimicGen の D0 タスク 10 件が 64.4% から 72.7% と 75.3% に上がったと著者は報告しています。
Base-only の推論コストは π0.5 とほぼ同じ
論文の表 5 は同じ NVIDIA RTX PRO 6000D で、バッチサイズ 1、デノイズ 10 ステップ、レイテンシは 100 回の平均で測定しています。
- π0.5:254.65 GFLOPs、ピークメモリ 10.56 GB、レイテンシ 63.07 ms、LIBERO 92.6%。
- Full(R→B):263.79 GFLOPs、19.12 GB、103.07 ms、98.7%。メモリとレイテンシはそれぞれ約 81% と 63% 増えます。
- Base-only:254.66 GFLOPs、10.49 GB、62.77 ms、96.3%。
FLOPs の差が小さいのは、計算の大半が共有の視覚エンコーダと PaliGemma のプレフィックス符号化で占められ、動作エキスパートは短いトークン列しか処理しないためです。表にはもう 1 行あります。視点エキスパートを残したまま B→R グラフで推論すると LIBERO は 97.0% で、Base-only の 96.3% より 0.7 ポイント高くなっています。論文の B→R の定義では、両者でベースエキスパートが受け取る入力は同じであり、本文はこの差を説明していません。論文はシード数や区間を報告していないため、この 0.7 ポイントが評価の乱数の範囲内かどうか、本サイトには判断できません。
実機:Franka Research 3 で試したのは Base-only だけ
実機実験は 7 自由度の Franka Research 3 で、固定された三人称カメラ 1 台と手首カメラ 1 台を入力に使います。6 タスク(短期 3、長期 3)それぞれで GELLO による遠隔操作デモを 50 本集め、まとめて 1 つのマルチタスク方策を学習しました。実機評価はすべて Base-only モードです。
- 分布内:タスクごとに 20 回のロールアウトで、平均成功率は 77.5%、π0.5 は 72.5% で、差は 5.0 ポイントです。長期タスク 3 件では 65.0% から 73.3% に上がりました。
- 空間的な分布シフト:3 タスクを選び、未見の固定カメラ視点 2 種(手首カメラは同じ)と、摂動を加えたエンドエフェクタ初期姿勢 2 種を用意し、タスクと構成の組ごとに 5 回のロールアウトを、再学習なしのゼロショットで行いました。合算の成功率は π0.5 の 28.3% から 58.3% に上がり、3 タスクすべてで OVOA-VLA が上回っています。
これらの設定から計算すると(本サイトの計算で、論文には直接書かれていません)、シフト実験は手法ごとに 60 回のロールアウトで、28.3% と 58.3% はそれぞれ約 17 回と 35 回の成功に当たります。分布内実験は手法ごとに 120 回で、5.0 ポイントは約 6 回の成功の差です。論文は区間を示していません。サンプル数と区間の関係は、フィジカルAIラボ 2.8 の Wilson 区間の計算方法で自分で確かめられます。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者報告 [R] です。本サイトでは再現していません。本サイトが読んだ本文には、複数の学習シードや信頼区間の報告がなく、コードや重みの公開についての記述もありません。
- π0 と π0.5 は著者による再現結果です。表 1 のほかのベースラインは再現の印がなく、評価条件が完全には一致しない可能性があります。
- 学習ラベルの作成には正確なカメラ外部パラメータが必要です。手法の定義上、Full 推論では視点エキスパートがカメラ座標系の状態を必要とするため、テスト時にも外部パラメータが要ります。LIBERO-Plus のカメラ摂動下で Full モードがどの外部パラメータを使ったかは本文に書かれていません(本サイトの推論です。付録に記載がある可能性があります)。
- 実機のシフト実験は 3 タスクのみで、構成ごとのロールアウトは 5 回です。シフトの種類別の結果は付録 D.3 にあり、本サイトは読めていません。デモ収集中、三人称カメラは固定されていました。
- LIBERO、LIBERO-Plus、VLABench、MimicGen はいずれもシミュレーションです。シミュレーションの成功率も少数の実機ロールアウトも、ハードウェアの安全性検証にはなりません。
- 本記事は arXiv の HTML 本文に基づいています。付録は表 7 より前の部分しか読んでいません。
リンク
- One View, One Action: Spatially Generalizable VLAs through Observation-Aligned Experts and Cross Graph Consistency(arXiv 2611.26161)
- 論文 HTML 全文
- フィジカルAIラボ 1.1:座標系と運動学――2 リンクのアームがコップに届く計算を手で追う
- フィジカルAIラボ 3.1:VLA を分解する――コップを置く動作を 256 区間のトークンに直し、三つのモデルのパラメータ数と周波数の範囲を確かめる
- フィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求める
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座概要)