この回の動画
ナレーションは AI 合成音声です。 動画の章・文字起こし・出典
文字起こし
文字起こし
知行の問い
絵を見て、指示を聞いて、手を動かす。三つのロボットモデルのやり方は同じなの?今回は、三つの視覚・言語・行動モデルを分解します。視覚、言語バックボーン、行動ヘッドを見て、どこが違うのかを確かめます。
共通の骨組み
まず共通点から。視覚・言語・行動モデル、略称は VLA です。画像と指示を一つ与えると、ロボットの動作をそのまま出力します。今回は一つの作業を通して見ていきます。机の上のコップを、かごに入れる。同じ作業が、三つのモデルでどう進むかを見ます。チャットモデルと比べると、VLA には厳しい制約が一つ加わります。出力で、モーターを動かせなければなりません。だから意味も、形や位置も分かる必要があります。分解すると、三つのブロックがあります。一つ目は世界を見る。二つ目は言語を理解する。三つ目は動作を生成する。今回の主役は、三つ目です。もう一つ大事な言葉があります。クロスエンボディメントです。一つのモデルで、ロボットアームも、双腕も、ヒューマノイドまでも動かしたいのです。これまでロボットは、認識、計画、制御と、いくつもの段に分けられていました。VLA はそれを一つにまとめ、エンドツーエンドで学ぼうとします。三つとは、オープン・ブイ・エル・エー、パイゼロ、グルート N1 です。それぞれスタンフォードなどの機関、フィジカル・インテリジェンス、エヌビディアから。論文によると、オープン・ブイ・エル・エー と グルート N1 は、公開済みです。
行動ヘッド:三つのルート
行動ヘッドとは、モデルが考えを、本物の動作の列に変える部分です。三つのモデルは、三つの違うルートを選びました。まず オープン・ブイ・エル・エー。動作を文字として扱います。論文によると、動作の各次元を、二百五十六の区間に分けます。長所は単純なことです。言語モデルが文字を生成するのと同じように、動作を生成します。パイゼロの論文によると、この方法は、高い周波数が必要で、器用さが求められる作業が苦手です。フローマッチングはどう働くのでしょう。まずモデルにノイズの塊を与え、少しずつノイズを取り除きます。ノイズは最後に、なめらかな一続きの動作になります。次はパイゼロ。トークンは出さず、フローマッチングを使います。論文によると、拡散型の動作生成の方法です。言語モデルの横に、小さな行動エキスパートを加えました。論文によると、動作のチャンク化とフローマッチングで、制御の周波数を最大五十ヘルツまで上げられます。三つ目は、エヌビディアの グルート N1。モデル全体が、速い系と遅い系の二重システムです。論文によると、遅い系は視覚・言語のバックボーンで、画像を見て理解します。速い系は動作のモジュールで、動作を生成します。ここで、たとえを借ります。遅い系は大脳のように、じっくり考える。速い系は小脳のように、すばやく動く。ただし、あくまでたとえです。その速い系は、拡散トランスフォーマーです。論文によると、これもフローマッチングで学習します。へいループの動作を、最大百二十ヘルツで出力します。つまり、オープン・ブイ・エル・エー はトークンを数え、ほかの二つはどちらもフローマッチング。パイゼロは小さな行動エキスパートを付け、グルート は速い系を別に設けます。なぜ連続的な生成のほうがなめらかなのか。動作はもともと連続した量だからです。一文字ずつ飛び出すほうが、かえって不自然です。パイゼロの論文によると、動作のチャンク化とフローマッチングで、速くて細かい作業をこなせます。論文では、服をたたむ作業で実演しました。行動ヘッドって、標準部品じゃないんだ。どのルートを選ぶかで、手が安定するかが決まる!
視覚と言語のバックボーン
その一つ手前が、世界を見ることと、言語を理解することです。ここで三つのモデルは、それぞれ別のオープンソースの巨人の肩に立っています。オープン・ブイ・エル・エー の言語バックボーンは、ラマ・ツー です。論文によると、その目は、二組の視覚特徴をつなぎ合わせています。なぜ目を二組つなぐのか。論文によると、一方は意味に強く、もう一方は空間に強い。ロボットが働くには、両方が必要です。論文によると、モデル全体で七十億個のパラメータがあります。およそ九十七万件の、実際のロボットの実演で学習しました。パイゼロはもっと小ぶりです。論文によると、そのバックボーンは、オープンモデルの PaliGemma です。そこに、あの小さな行動エキスパートを足します。論文によると、合わせておよそ三十三億個のパラメータです。三つ目のモデルのバックボーンは、エヌビディア製です。論文によると、イーグル・ツーという視覚言語モデルを使っています。このイーグル・ツーも、組み合わせでできています。論文によると、スモール・エルエム・ツーを微調整したもので、視覚エンコーダーにはシグリップ・ツーを使います。論文によると、公開された グルート N1 のモデルは、全体で二十二億個のパラメータです。ほかの二つより小さく、おもにヒューマノイド向けです。三つの軸を並べてみましょう。視覚エンコーダー、言語バックボーン、行動ヘッド。これが、どんな VLA でも分解できる地図です。
限界とトレードオフ
なぜゼロから学習しないのか。意味や物体をゼロから覚えるのは、高すぎるし遅すぎます。借りてきた大規模モデルは、もうコップもかごも知っています。もう一つ、トレードオフがあります。トークンは一つずつ出てきますが、チャンク化とフローマッチングなら、一まとまりを一度に出せます。遅延と精度が、ここで引っ張り合います。何をもって強いと言うのか。成功率、速さ、そして見たことのない物体でも安定しているか。このあたりは、この先の回で話します。注意してほしいのは、パラメータは多ければいいわけではないことです。グルート はいちばん小さいけれど、小さいから強いとも弱いとも言えません。合うかどうかは、作業によって決まります。オープン・ブイ・エル・エー と グルート が公開ダウンロードできることには、もう一つの意味があります。自分でダウンロードし、自分で微調整し、自分で検証までできるのです。オープンモデルの肩に立つ良さは、ほかにもあります。コミュニティが一歩進むたびに、VLA もそれを受け取れるのです。まだ解決していないこともあります。分解して出てきた名前は、どれが強いかを示すものではありません。実機でどれが上かは、一つずつ試すしかありません。ロボットや環境が変われば、順位もまた変わるかもしれません。ふりかえりです。ポイントは三つ。一つ、VLA はどれも、画像を見て、言語を理解し、動作を出力する。二つ、動作を生む行動ヘッドは、オープン・ブイ・エル・エー がトークンを数え、ほかの二つはフローマッチングを使う。三つ、バックボーンは、視覚も言語も、それぞれ別のオープンモデルの上に立っている。名前を覚えられなくても大丈夫。三つのブロックさえ覚えれば十分だよ!でも、こうしたモデルの学習データは、どこから来るの?次回は、世界を一つ作りに行くよ。また次回!
根拠と出典
256個 · の区間。OpenVLA の行動ヘッドは、動作の各次元を256区間に離散化し、トークンとして予測する [R] · arXiv 2406.09246 · OpenVLA
フローマッチング · π-zero の行動ヘッド:事前学習済みの視覚・言語モデルの上で、フローマッチング(拡散の一種)により連続動作を生成 [R] · arXiv 2410.24164 · π0
70億 · 個の OpenVLA のパラメータ(7B)。約97万件の実際のロボットの実演で学習(論文) [R] · arXiv 2406.09246 · OpenVLA
PaliGemma · が π-zero の視覚・言語バックボーン。重みはこのオープンモデルから初期化(論文) [R] · arXiv 2410.24164 · π0
33億 · π-zero の合計パラメータは約33億(30億の VLM + 3億の行動エキスパート、論文) [R] · arXiv 2410.24164 · π0
Eagle-2 · GR00T N1 はエヌビディアの Eagle-2 を視覚・言語バックボーンに使う(論文) [R] · arXiv 2503.14734 · GR00T N1(NVIDIA)
22億 · GR00T-N1-2B の総パラメータは約22億、うち約13.4億が視覚・言語バックボーン(論文) [R] · arXiv 2503.14734 · GR00T N1(NVIDIA)
練習とセルフチェック
小テストは公開で、回答するとすぐ解説が出ます。読み物の練習問題の答えはログイン会員向けです。
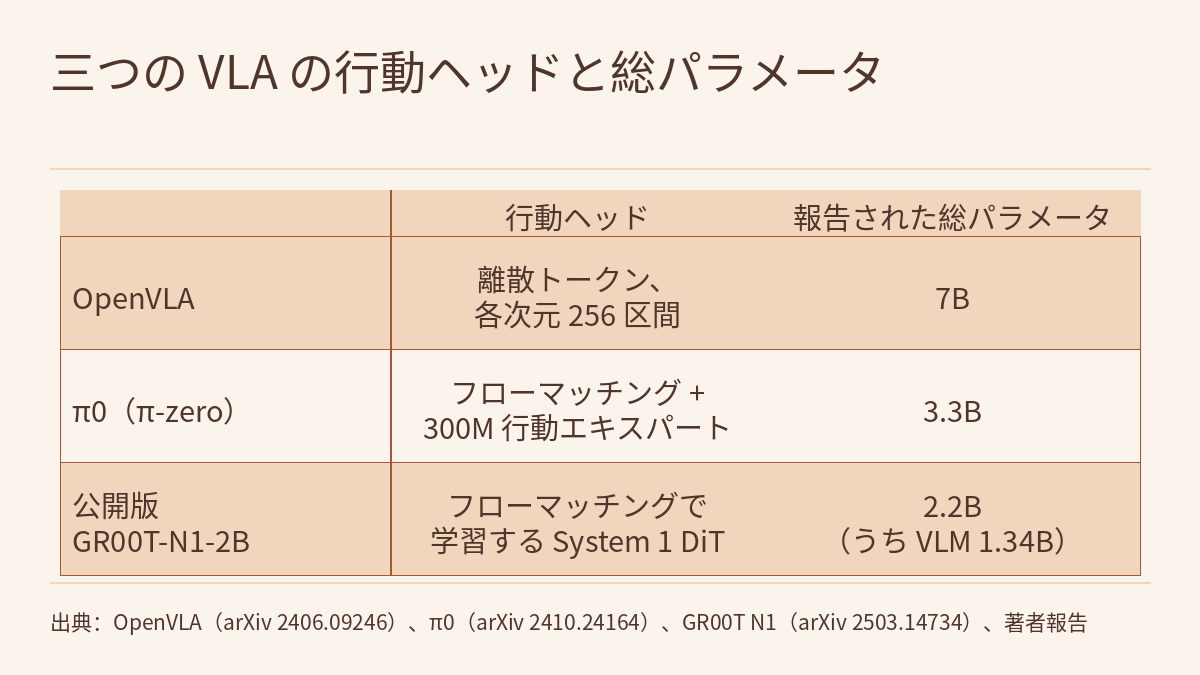
第 3.1 回の動画は L3 に入り、三つの視覚・言語・行動モデル(VLA)、OpenVLA、π0(π-zero)、GR00T N1 を分解します。動画は三つのことを説明します。三つの骨組みは同じで、どれも画像を見て、言語を理解し、動作をそのまま出力します。中身は、世界を見る、言語を理解する、動作を生成する、の三ブロックです。行動ヘッドは三つのルートに分かれます。OpenVLA は動作の各次元を 256 の区間に分けてトークンとして扱い、π0 はフローマッチングと行動エキスパートを使い、GR00T N1 の速い系はフローマッチングで学習する拡散トランスフォーマーです。視覚と言語のバックボーンはそれぞれ別のオープンモデル(Llama 2、PaliGemma、Eagle-2)の上に立っており、名前もパラメータ数も強さを示しません。動画の数字カードは三本の arXiv 論文、OpenVLA(2406.09246)、π0(2410.24164)、GR00T N1(2503.14734)から取られています。このページはこの回の解説と練習です。文字起こしは繰り返さず、動画が触れるだけだった三つのことを扱います。架空のコップを置く動作で「256 の区間に分ける」を実際に計算し、区間の幅が何で決まり、範囲の外の値がどうなるかを確かめます。二つのフローマッチング型の行動ヘッドが一まとまりの動作を出すのに何ステップの積分を行い、論文がどんな時間を報告しているかを、それぞれのハードウェアと設定に戻します。そして 7B、3.3B、2.2B という三つの総パラメータ数を論文が名指しする各ブロックに分け、それぞれが何を数えているのかを見ます。全体を通じたルールは一つです。パラメータ数、周波数、時間は、それを報告した論文、そのバージョンのモデル、そのハードウェアだけのものです。三本の論文の数字は互いに換算できず、一つのランキング表にまとめることもできません。
この回の動画、文字起こし、出典はこのページの上部にあります。シーズン全体の構成は講座の概要をご覧ください。前回のフィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求めるは、最後に「見て、考えて、動く大規模モデルの中身はどうなっているのか」と問いかけました。この回はその答えです。π0 が 50 Hz のロボットで 25 個の動作を実行するごとに推論し直すこと、そして速い系と遅い系がどう層をなすかは、フィジカルAIラボ 0.3:見る・考える・動く――3 つの周波数をそれぞれのシステムに戻すでそれぞれのシステムに戻しました。フローマッチングで学習する行動エキスパートと非同期の動作キューは、フィジカルAIラボ 2.3:SmolVLA をファインチューニングする――指示に合わせてお手本を計画し、各数字が何を測ったかを確かめ、非同期の動作キューの時間を計算するで扱いました。動作チャンクの長さの決め方は、フィジカルAIラボ 2.6:エッジへ――遅延のログから制御周波数の上限を求め、量子化で減るのが容量か時間かを見分け、動作チャンクの長さを決めるで計算しました。この回ではそれらを繰り返さず、三本の論文自身が三つのブロックをどう書いているか、そして数字を読むときに明記すべき範囲だけを扱います。0.3 で引用したのは GR00T N1.7 についてのメーカーのブログです。この回で読むのは GR00T N1 の論文で、本文の GR00T の数字は GR00T-N1-2B だけのものです。次回 3.2 では、Cosmos で学習データを生成・変換する世界モデルを扱います。
公開小テストの 5 問には詳しい解説が付いています。ログインすると、三つの練習に取り組めます。架空のコップを置く動作の三つの次元を 256 区間のインデックスに直し、復元の誤差と範囲外の誤差を求める。三つのモデルの総パラメータ数を各ブロックに分け、積分のステップ数と時間を整理して、四つの主張を判定する。架空の VLA 選定メモを審査し、各文を論文の原文の条件に戻して書き直し、自分のロボットで実測すべき項目を挙げる。いずれにも段階的な解答例、よくある誤り、20 点満点の採点基準が付いています。
1. 三本の論文は三つのブロックをどう書いているか
三本とも arXiv のプレプリントで、この講座の区分では R レベルです。以下の構造と数字はすべて著者の報告で、本サイトは再現しておらず、どのモデルも動かしていません。GR00T N1 は NVIDIA が自社のモデルについて報告したものです。動画の数字カードに対応する原文を、それぞれ独立に引用します。
OpenVLA(Kim ら、著者は Stanford University、UC Berkeley などの機関、arXiv 2406.09246)の要旨:
we introduce OpenVLA, a 7B-parameter open-source VLA trained on a diverse collection of 970k real-world robot demonstrations.
OpenVLA builds on a Llama 2 language model combined with a visual encoder that fuses pretrained features from DINOv2 and SigLIP.
手法の節(HTML v1)で動作について述べた一文:
we discretize each dimension of the robot actions separately into one of 256 bins.
論文の構造図の説明は、モデルを三つの部分に分けています。DINOv2 と SigLIP の特徴を連結する視覚エンコーダー、視覚特徴を言語の埋め込み空間に写すプロジェクター、そして Llama 2 7B の言語バックボーンです。観測画像一枚と言語の指示一つを与えると、モデルは 7 次元のロボット制御動作を予測します。土台は Prismatic-7B という視覚・言語モデルで、600M パラメータの視覚エンコーダー、2 層の MLP プロジェクター、7B パラメータの Llama 2 からなります。入力の画像パッチは二つのエンコーダーを別々に通り、得られた特徴はチャンネル方向に連結されます。論文によると、DinoV2 の特徴を加えると空間的な推論に役立ちます。動画の「一方は意味に強く、もう一方は空間に強い」は、関連研究の節の記述に対応します。DINOv2 からの低レベルの空間情報と、SigLIP からの高レベルの意味情報を組み合わせる、というものです。
π0(Physical Intelligence、arXiv 2410.24164)の要旨:
We propose a novel flow matching architecture built on top of a pre-trained vision-language model (VLM) to inherit Internet-scale semantic knowledge.
序論、フレームワーク図の説明、モデルの節(HTML v1):
This enables our model to control robots at frequencies of up to 50 Hz for dexterous tasks such as laundry folding
The VLM backbone weights are initialized from PaliGemma , providing representations learned from large-scale Internet pre-training.
PaliGemma is an open-source 3 billion parameter VLM that offers a convenient tradeoff between size and performance. We add 300M parameters for the action expert (which is initialized from scratch) for a total of 3.3 billion parameters.
一つ目の文の This は、論文で直前の文が述べている、動作のチャンク化とフローマッチングを組み合わせた構造を指します(論文はフローマッチングを拡散の一種と呼んでいます)。フレームワーク図の説明によると、モデルは大きめの VLM バックボーンと、ロボットの状態と動作を処理する小さめの行動エキスパートからなります。第 IV 節によると、画像エンコーダーは観測画像を言語トークンと同じ空間に埋め込みます。論文はさらに、PaliGemma を使ったのは便利さと、比較的小さくリアルタイム制御に向くためで、フレームワーク自体はどの事前学習済み VLM とも組み合わせられると述べています。著者らは比較実験のために、VLM で初期化しない 470M パラメータの π0-small も学習させました。
GR00T N1(NVIDIA、arXiv 2503.14734)の要旨と本文(HTML v1):
GR00T N1 is a Vision-Language-Action (VLA) model with a dual-system architecture. The vision-language module (System 2) interprets the environment through vision and language instructions. The subsequent diffusion transformer module (System 1) generates fluid motor actions in real time.
It generates closed-loop motor actions at a higher frequency (120Hz).
We use the NVIDIA Eagle-2 VLM ( Li et al., 2025 ) as the vision-language backbone.
Specifically, our publicly released GR00T-N1-2B model has 2.2B parameters in total, with 1.34B in the VLM.
Eagle-2 is finetuned from a SmolLM2 ( Allal et al., 2025 ) LLM and a SigLIP-2 ( Tschannen et al., 2025 ) image encoder.
モデル構造の節にはさらに、GR00T N1 がフローマッチングで動作の生成を学習すること、System 1 の拡散トランスフォーマー(DiT)がクロスアテンションで VLM の出力する画像と文字のトークンを読み、機体ごとのエンコーダーとデコーダーで次元の異なる状態と動作を扱うことが書かれています。序論によると、System 2 は NVIDIA L40 GPU 一枚の上で 10 Hz で動きます。
次の表は、この回が三本の原文を整理したもので、原文の文ではありません。
| ブロック | OpenVLA | π0 | GR00T N1 |
|---|---|---|---|
| 視覚エンコード | DINOv2 と SigLIP の特徴をチャンネル方向に連結、600M | 画像エンコーダーが観測を言語トークンと同じ空間に埋め込む。PaliGemma の一部で、読んだ範囲に単独のパラメータ数はない | SigLIP-2(Eagle-2 の一部)。1 フレーム 224 × 224 で、画像トークン 64 個 |
| 言語バックボーン | Llama 2 7B | PaliGemma(3B、VLM 全体) | Eagle-2。SmolLM2 を微調整したもの。GR00T-N1-2B は LLM の 12 層目の表現を使う |
| 行動ヘッド | 各次元 256 区間の離散トークン。次のトークンの予測で学習 | 300M の行動エキスパート。フローマッチングで動作チャンクを出力 | System 1 の DiT。フローマッチング、1 チャンク 16 個の動作 |
| 論文が報告する総パラメータ | 7B | 3.3B | 2.2B(うち VLM 1.34B) |
| 読んだ範囲で公開と明記されているもの | モデルのチェックポイント、微調整用 notebook、PyTorch のコード。脚注によると、再現に必要な学習データ、コード、重みも公開 | π0 自体の重みが公開されているかは書かれていない。PaliGemma がオープンソースの VLM だとだけ述べる | GR00T-N1-2B のチェックポイント、学習データ、シミュレーションのベンチマーク |
この表を読むときの注意点が二つあります。一つ目に、「オープン」が指すものは三本で違います。OpenVLA の脚注によると、OpenVLA が使う SigLIP、DinoV2、Llama 2 が公開しているのは重みだけで、学習データやコードは公開していません。GR00T が公開と明記しているのは GR00T-N1-2B という版です。だから動画は「論文によると、OpenVLA と GR00T N1 は公開済み」とだけ言い、「三つのオープンソースモデル」とは言いません。二つ目に、「バックボーン」がカバーする範囲も違います。π0 の VLM バックボーンには画像エンコーダーが含まれ、OpenVLA は視覚エンコーダーを別に挙げ、GR00T の 1.34B は VLM 全体です。
ログインすると、このレッスンの続きと確認問題、解答を読めます。
制約と注意点
- 三本の論文はいずれも arXiv のプレプリントで R レベルです。構造、パラメータ数、周波数、時間はすべて著者の報告で、本サイトは再現しておらず、どのモデルも動かしていません。GR00T N1 は NVIDIA が自社のモデルについて報告したものです。この回で読んだのは、OpenVLA の要旨、序論、関連研究、第 3 節から学習データの節の冒頭まで。π0 の要旨、序論、関連研究、概要、第 IV 節の冒頭、推論とパラメータ数を述べた段落。GR00T N1 の要旨、序論、モデル構造の節、学習データ生成の節の冒頭です。
- π0 の推論時間は論文の付録 A-D にあり、この回では読んでいません。読んだ範囲の π0 の文には動作チャンクの長さがなく、π0 の重みが公開されているかも書かれていません。
- 以下はこの回の約束、計算、推論です。OpenVLA のインデックスの切り捨て、区間の中央での復元、範囲外の切り詰め。分位点の方式で各次元の学習動作の約 2% が切り詰められること。GR00T の 16 個の動作のチャンクを 120 Hz で続けて実行すると 133 ms 分になり、サンプリングがその約 48% であること。パラメータの残りと割合。ネットワークの呼び出し回数の数え方。
- 2 節の +4.2 mm、−10〜+10 mm の範囲と外れ値、そして練習のロボット D、チーム Q、モデル Z、すべての分位点、目標の動作、メモの文は架空のもので、どの論文やシステムのデータでもありません。
- 三本の論文は、同じロボット、同じ作業でこの三つのモデルを比べておらず、この回もそうした比較はしません。紙の上の計算とシミュレーションの結果は、ハードウェアの安全性の検証ではありません。
- この回の GR00T の数字は GR00T N1 の論文と GR00T-N1-2B だけのものです。0.3 で引用した GR00T N1.7 は別のバージョンです。
リンク
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)
- フィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求める
- フィジカルAIラボ 0.3:見る・考える・動く――3 つの周波数をそれぞれのシステムに戻す
- フィジカルAIラボ 2.3:SmolVLA をファインチューニングする――指示に合わせてお手本を計画し、各数字が何を測ったかを確かめ、非同期の動作キューの時間を計算する
- フィジカルAIラボ 2.6:エッジへ――遅延のログから制御周波数の上限を求め、量子化で減るのが容量か時間かを見分け、動作チャンクの長さを決める
- Kim ら:OpenVLA: An Open-Source Vision-Language-Action Model(arXiv 2406.09246)
- OpenVLA(arXiv 2406.09246、HTML v1)
- Physical Intelligence:π0: A Vision-Language-Action Flow Model for General Robot Control(arXiv 2410.24164)
- π0(arXiv 2410.24164、HTML v1)
- NVIDIA:GR00T N1: An Open Foundation Model for Generalist Humanoid Robots(arXiv 2503.14734)
- GR00T N1(arXiv 2503.14734、HTML v1)