
プレプリント MoMaSplat(arXiv 2611.08372、2026-11-05、テキサス大学オースティン校 RobIn ラボ)は、モバイルマニピュレーションの実際的な問題を扱います。ロボットが作業台の前までナビゲーションしても、ベースがデモ収集時とまったく同じ位置に止まることはまれで、模倣学習で得た視覚運動方策はカメラの視点に敏感です。既存の新視点合成(NVS)による拡張はシーンを静的なものとして扱うため、物体が持ち上げられたり開けられたりすると正しく再描画できません。MoMaSplat は静的シーンと操作対象の物体を別々に再構成し、サンプリングした新しいベース姿勢から接触後の段階を含むデモ全体を再描画し、行動を新しいベース座標系に変換します。著者の報告では、実機 5 タスクの未見のベース姿勢での平均成功率は 37% で、最も強いベースラインは 17% でした。以下の数値はすべて著者の報告 [R] で、本サイトでは再現していません。
問題:ベースがずれると視点もずれる
論文はベース位置のずれの原因として、ナビゲーションの不確かさ、自己位置推定のドリフト、障害物回避、不完全な計画を挙げています。カメラはロボットの頭部や胴体に取り付けられているため、ベースが動けば方策が見る画像はデモのときと変わります。最も直接的な対策は多くの位置でデモを集めることですが、著者は実機の遠隔操作は高価で規模を広げにくいと指摘しています。
もう一つの道は、NVS で新しい視点のデモを生成することです。論文が挙げる VISTA、Yang らの 3D Gaussian Splatting に基づく手法、One-Thousand Trajectories、EgoDemoGen は、いずれも動いている物体を明示的に再構成しません。物体はデモの途中で動かされるため、これらの手法は接触前の接近動作しか拡張できないか、幾何的に一貫しない画像を生成します。著者は、接触後のインタラクション段階こそデモで最も重要な部分だとしています。
論文の出発点は、標準的なモバイルマニピュレーションのデータ収集が、再構成に必要な多視点の観測をすでに含んでいるという点です。ナビゲーションの軌道は静止したシーンと物体をさまざまな角度から捉え、操作デモそのものが物体中心の観測と物体の動きを提供します。
手法:シーン・物体・ロボットを 3 系統で描画する
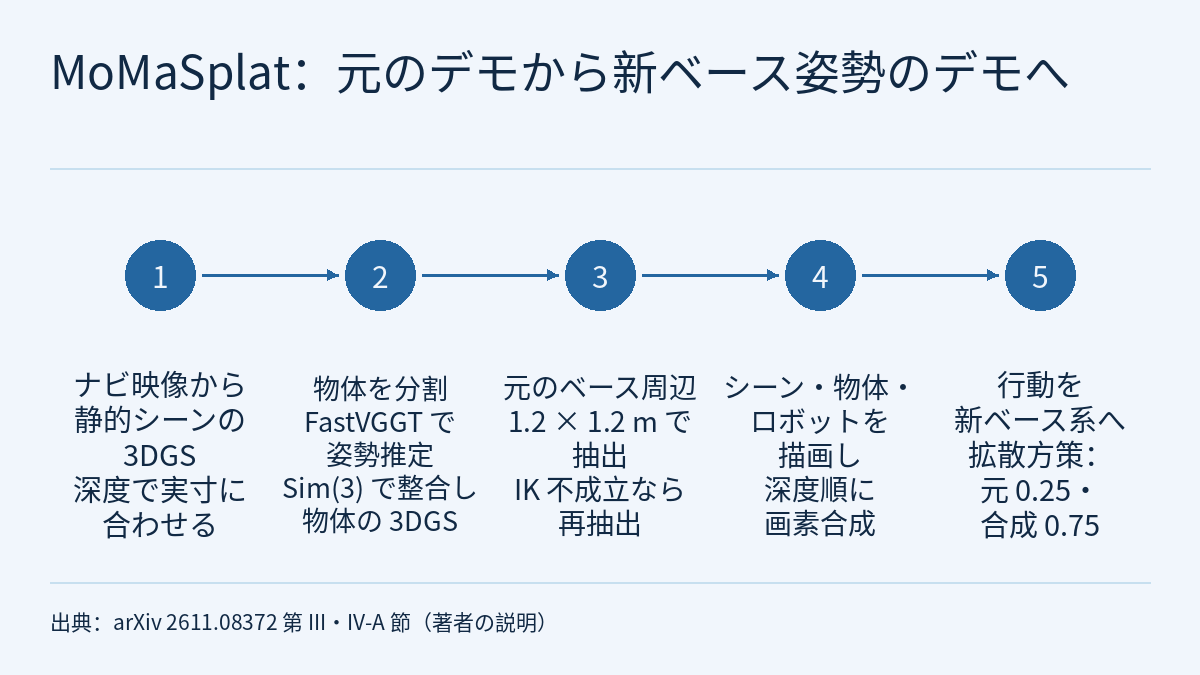
収集時、ロボットはまず異なる出発点から N 個の目標ベース姿勢へナビゲーションし、各姿勢でベースを固定して M 本の操作デモを記録します。行動は 7 次元の指令で、ベース座標系でのエンドエフェクタの並進増分と回転増分、それにグリッパ指令からなります。MoMaSplat はこの 2 種類のデータを使って次の手順を踏みます。
- 静的シーン。ナビゲーションのフレームで COLMAP を実行し、カメラ姿勢と疎な点群を得て 3DGS を初期化します。WildGaussians の不確かさを考慮した定式化を使い、フレーム間で一貫しない領域の重みを下げます。再構成時には操作対象の物体とロボットの画素をマスクし、物体がシーンに固定されて、後で物体を合成したときに静止した「ゴースト」が残るのを防ぎます。Structure-from-Motion(SfM)では尺度が未知のままですが、行動の変換にはメートル単位が必要なため、搭載の深度カメラで尺度を決めます。実測深度と描画深度を比べ、画素ごとの比の中央値を取ります(付録では、フレームごとの中央値のさらに中央値と明記)。
- 操作対象の物体。Grounded-SAM と SAM 2 で物体を分割し、背景とロボットをマスクしたフレームをフィードフォワード型 3D 基盤モデル FastVGGT に入力して、物体に対するフレームごとのカメラ姿勢を得ます。これらの姿勢はモデル独自の座標系にあり、尺度・向き・原点は任意です。整合の鍵はナビゲーションのフレームです。ナビゲーション中は物体が静止しているので、同じカメラ群が FastVGGT と SfM の両方で姿勢推定され、二つの軌道は Sim(3) 変換一つ分だけ異なります。これを Umeyama アルゴリズムで閉形式に求めます。実験では 1 本のナビゲーションデモの 50 フレームで整合しています。その後、物体の姿勢と物体の 3DGS を同時に最適化します。関節物体では、動く剛体部分(ノートパソコンの画面側、エアフライヤーのバスケット)だけを物体として扱い、残りはシーンに含めます。関節パラメータは推定せず、デモの範囲を超える動きへの外挿もしません。
- ベース姿勢のサンプリング。元の各ベース姿勢の周囲の領域(実験では 1.2 × 1.2 m)で平面位置を一様にサンプリングし、向きは物体がカメラ視野の中央に来るように決めたうえで一様ノイズを加えます。物体に対するエンドエフェクタの姿勢を固定したまま、デモ中のいくつかの確認時刻で逆運動学(IK)の解があるかを調べ、解がない姿勢は棄却して再サンプリングします。
- 描画と合成。新しいベース姿勢に合わせて仮想カメラを置き、内部パラメータは実カメラと同じにします。シーンと物体は 3DGS で描画し、ロボットは IK で関節角を求めて OmniGibson で描画します。3 つの画像を画素ごとに深度順に並べ、手前から奥へアルファ合成するので、近い面が遠い面を隠します。
- 行動と固有感覚の変換。エンドエフェクタの姿勢に、元のベース座標系から新しいベース座標系への変換を掛けます。並進増分はその変換の回転成分で回転させ、回転増分は回転軸を回転させて回転角はそのままにします。グリッパ指令は変えません。
- 学習。元のデモ 1 本ごとに K 本の合成デモを生成し、両者の和集合で Diffusion Policy を学習します。サンプリング比は元データ 0.25、合成データ 0.75 です。
手順 5 は簡単な例で理解できます(本サイトの例で、論文のデータではありません)。新しいベースが元のベースと同じ位置で、左に 90° 回っただけだとします。ベース座標系の x 軸は前向き、y 軸は左向きとします。元のベース座標系で「前へ 0.10 m」の並進増分は、世界での変位は同じですが、新しいベース座標系では「右へ 0.10 m」(y = −0.10 m)と表されます。画像だけを変えて行動を変えなければ、方策は画像と食い違う行動ラベルを学ぶことになります。論文は VISTA の結果が悪い理由の一つとして、行動を変換しない点を挙げています。
実験設定:実機 5 タスク、未見の姿勢ごとに 3 回
3 つのシーンに 5 タスクがあります。デスクのシーンで Pick-Place Bottle と Open Drawer、リビングで Pick-Place Remote と Close Laptop、キッチンで Open Air-fryer です。剛体のピック・アンド・プレースと 1 自由度の関節物体を含みます。デモは Close Laptop が 75 本、ほかのタスクは各 90 本で、3 つのベース姿勢に分かれています。ほかにナビゲーション軌道を 9 本収集しました。各手法は元のデモ 1 本につき合成デモを 10 本生成し、1 タスクあたり 750〜900 本になります(One-Thousand Trajectories の Pick-Place Bottle は 400 本。後述)。
評価では、各タスクで未見のベース姿勢 12 か所それぞれ 3 回ずつ実行します。1 タスク 36 回、5 タスクで 180 回です(本サイトの計算)。未見の姿勢は元の姿勢から 5〜50 cm 離れています。元の 3 つの姿勢ではそれぞれ 15 回実行しています。
4 つのベースラインはいずれも著者が実装または設定したもので、同じ元デモを使います。
- Source Only:拡張なしの Diffusion Policy。
- Action Augmentation:固有感覚と行動に平均ゼロのガウスノイズを加え、画像は変えません。
- VISTA:ZeroNVS でフレームごとに新しい視点を生成し、行動は変えません。平面の摂動は各軸 ±10 cm 以内で、著者によるとこれを超えると画像のアーティファクトが大きくなり、模倣学習の結果も悪化します。フレームごとに生成した画像は時間的に一貫しません。
- One-Thousand Trajectories:MoMaSplat と同じ手順で静的シーンを再構成しますが、物体はマスクしません。著者は MoMaSplat の行動変換を加え、元の手法にある追加の軌道拡張は省いています。Pick-Place Bottle では、物体の初期姿勢が再構成シーンと一致するデモが 40 本しかないため、それらだけから 400 本を生成しました。学習には元デモ 90 本をすべて使っています。
結果:未見の姿勢で平均 37%、距離が大きいほど差が開く
| 手法 | 未見のベース姿勢での成功率(5 タスクの平均) |
|---|---|
| MoMaSplat | 37% |
| One-Thousand Trajectories | 17% |
| VISTA | 8% |
| Source Only | 6% |
| Action Augmentation | 6% |
元のベース姿勢では、どの手法も同程度でした。未見の姿勢では、Source Only と Action Augmentation は多くのタスクで 10 cm を超えるとほぼゼロになり、著者はここから、観測を変えずに行動だけを揺らしてもベースのずれへの頑健性はほとんど得られないと考えています。One-Thousand Trajectories は下がり方が緩やかですが、距離が大きくなるとやはり落ち込みます。著者はその理由を、自由空間での接近動作しか拡張しないためと説明しています。著者の報告では、MoMaSplat は全タスクで未見の姿勢での総合成功率が最も高く、すべての距離区間でどのベースラインにも劣りません。たとえば Pick-Place Bottle の 30 cm で 33%、Close Laptop の 40 cm で 50% で、この 2 か所ではベースラインはすべて 0 でした。本サイトが読んだ本文と図 4–5 のキャプションには、距離区間ごとの姿勢の数も信頼区間も示されていません。
元デモの本数の影響は Pick-Place Bottle だけで調べています。元デモ 10 本、50 本、90 本でそれぞれ 10 倍の合成デモを作り、元の姿勢から 10〜20 cm の 4 か所で試すと、成功率は 33%、42%、50% でした。元デモ 90 本で拡張しない場合は 8% です。これらの百分率は、4 か所で各 3 回、計 12 回とした場合の 4/12、5/12、6/12、1/12 にちょうど一致しますが、論文のこの段落には 1 か所あたりの回数が書かれていないため、これは本サイトの推測です。推測が正しければ、隣り合う設定の差は成功 1 回分です。
生成品質は、まずシミュレーションで評価しています。著者は OmniGibson にデスクのシーンを模した Sim Pick-Place Bottle を作り(タスク構造は同じで、幾何形状は再現していません)、生成デモの変換済み行動をシミュレータで実行して搭載カメラを描画したものを正解としました。生成デモ 75 本から 10 フレームごとに 1 フレームを取り、計 2,486 フレームです。これらの視点は、再構成に使った視点から 0.4〜27.3 cm 離れています。
| 領域 | PSNR (dB) ↑ | SSIM ↑ | LPIPS ↓ |
|---|---|---|---|
| 画像全体 | 21.27 ± 1.12 | 0.902 ± 0.019 | 0.253 ± 0.030 |
| シーン | 26.40 ± 2.18 | 0.936 ± 0.021 | 0.248 ± 0.037 |
| 物体 | 18.18 ± 2.15 | 0.688 ± 0.081 | 0.341 ± 0.106 |
| ロボット | 17.43 ± 1.30 | 0.812 ± 0.057 | 0.287 ± 0.048 |
シーンの PSNR はデモ 1 本につき 1 フレーム(計 75 フレーム)で計算しています。著者は参考として、元の 3DGS 論文が Tanks & Temples で報告した約 23 dB を挙げていますが、これは別のデータセットで、桁の目安にしかなりません。物体の値が低い理由を著者は動く物体の視点カバー範囲が限られるためとし、ロボットの誤差は主に合成時の照明と影の違いによるとしています。元デモ 30 本で、推定した物体姿勢のシミュレータ正解に対する誤差は、並進 1.46 ± 0.71 cm、回転 4.01° ± 4.66° でした。実データでは、ロボットと物体をマスクしたシーンが 110 枚の評価用フレームで 24.00 dB、物体はバウンディングボックスで切り出して背景をマスクした領域で計算し、VGGT が直接推定した姿勢で 23.63 dB、補間した姿勢で 22.59 dB でした。上の表のシミュレーションで物体マスクを使って計算した 18.18 dB とは計算領域が異なるため、そのまま比較することはできません。シミュレーションのロボットは実機と見た目が異なるため、著者は実データでの画像全体の指標を報告していません。
本サイトの内容との関係
フィジカルAIラボ 1.6 では、行動クローニングの誤差がロボットをお手本のカバー範囲の外へ運ぶ仕組みを扱いました。ベースのずれは別の形のはみ出しです。方策が動き出す前から、見ている画像がすでに学習分布の外にあります。MoMaSplat は実機のデモを増やすのではなく、「ベース姿勢」という次元に沿って観測のカバー範囲を補います。使う方策も 1.6 で取り上げた Diffusion Policy です。
フィジカルAIラボ 1.5 は、合成をデータの三つ目の入手ルートとして挙げました。論文の関連研究の節によると、MimicGen 系の手法が生成するのは純粋に運動学的な計画で、実現可能性の確認と画像の取得のために、通常は実機での開ループ再生がまだ必要です。MoMaSplat は実際のシーンと物体を再構成し、シミュレーションは既知のロボット本体の描画だけに使う、という選択をしています。手順 5 の座標変換は、フィジカルAIラボ 1.1 の座標系と運動学と合わせて読むとわかりやすくなります。
2026-10-16 のフロンティア・レーダーで取り上げた Cracking Mobile Manipulation は、計画、ベース姿勢、エンドエフェクタの各段階に介入を加えるものでした。MoMaSplat は別の道を取り、ベースを正確に止めることを求める代わりに、ベースのずれに左右されにくい方策を学習します。1 タスク 36 回の試行を距離で区切った成功率を読むときは、フィジカルAIラボ 1.8 のやり方で、まず各百分率の裏に何回の試行があるかを数えてください。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者の報告 [R] です。本サイトでは再現していません。論文はコードを公開予定としていますが、本サイトが読んだ本文にはコードの所在は書かれていません。
- 各タスクの未見の姿勢は 12 か所、各 3 回だけです。本サイトが読んだ本文と図 4–5 のキャプションには、信頼区間も、距離区間ごとの姿勢の数も示されていません。30 cm で 33%、40 cm で 50% のような個々の数値は、ごく少ない試行に基づいている可能性があります。
- 4 つのベースラインは著者が実装または設定したものです。VISTA の摂動は各軸 ±10 cm に限られ、One-Thousand Trajectories には MoMaSplat の行動変換を加え、元の手法の軌道拡張を省いています。比較結果はこれらの設定に依存します。
- 生成品質のシミュレーション評価は、デスクを模しつつ幾何形状は再現していないシーンで、視点の距離は 0.4〜27.3 cm です。方策評価での最大 50 cm のベース距離とは別の量で、本サイトが読んだ本文には 27.3 cm より遠い視点での忠実度の数値はありません。
- 著者が述べる制約:この手法はほぼ静的なシーンと、剛体で見える物体を前提としており、変形物体、強い遮蔽、テクスチャの乏しい表面は扱いが難しいとしています。物体の初期位置で隠れていた領域(持ち上げたボトルの下の面、開けた引き出しやエアフライヤーのバスケットの内側)はシーン再構成で一度も観測されず、現れてもモデル化されません。オープンワールドの分割が一貫していることに依存します。生成デモは元の物体軌道を再生するだけで接触力や力学をモデル化しないため、物理的なデモではありません。視点の品質はナビゲーションデータのカバー範囲に左右されます。
- タスクは剛体のピック・アンド・プレースと 1 自由度の関節操作だけで、ベース姿勢のサンプリングは元の姿勢周辺の 1.2 × 1.2 m の領域に限られ、広い範囲のナビゲーションは含みません。
- 実機の成功率はタスクの達成を測るもので、安全性の検証ではありません。シミュレーションでの忠実度も実機試験の代わりにはなりません。
リンク
- MoMaSplat: Dynamic Novel-View Demonstration Augmentation for Mobile Manipulation(arXiv 2611.08372)
- 論文の HTML 全文
- フィジカルAIラボ 1.1:座標系と運動学――2 リンクのアームがコップに届く計算を手で追う
- フィジカルAIラボ 1.5:データはどこから来る?――SO-101 のメタデータからお手本の長さを求め、三つの入手ルートの単位と動作空間を見分ける
- フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読む
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フロンティア・レーダー|Cracking Mobile Manipulation:サブタスクでは 80%、つないでモバイル操作にすると 19%――失敗エピソードの原因を割り当ててから、段階ごとに介入する
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)


