
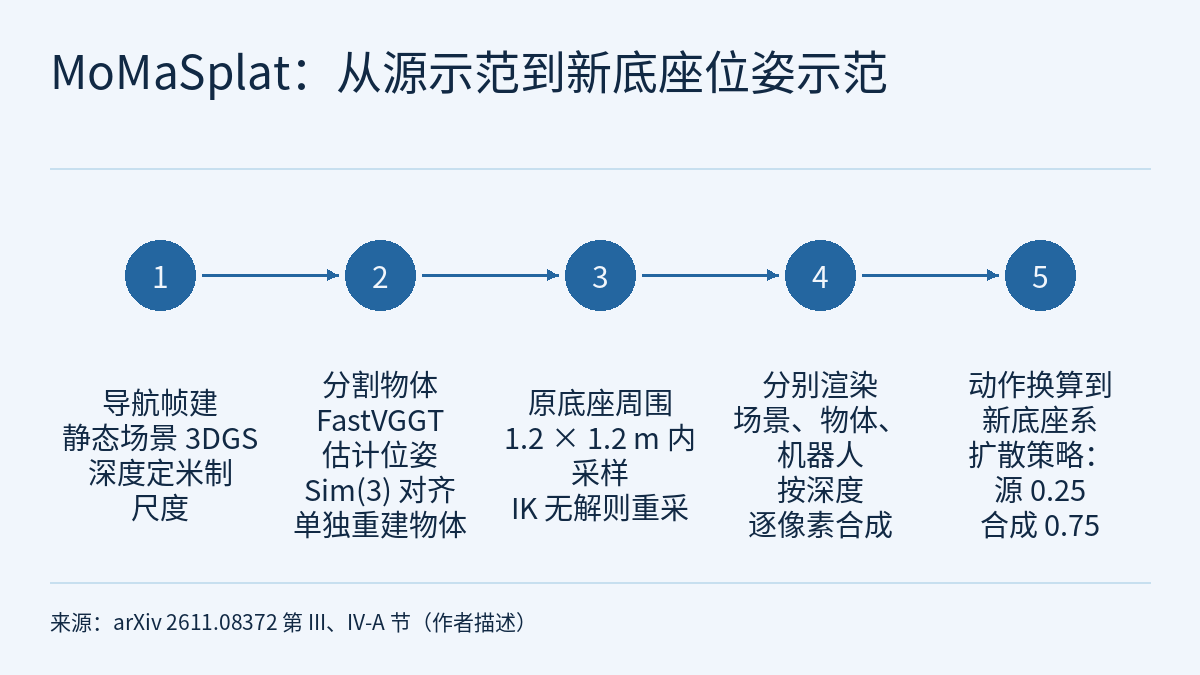
预印本 MoMaSplat(arXiv 2611.08372,2026-11-05,得克萨斯大学奥斯汀分校 RobIn 实验室)处理移动操作里的一个实际问题:机器人导航到工作台前,底座很少停在采示范时的同一位置,而模仿学习得到的视觉运动策略对相机视角很敏感。已有的新视角合成(NVS)增强把场景当成静止的,物体一被拿起或打开就无法正确重渲染;MoMaSplat 把静态场景和被操作物体分开重建,从采样的新底座位姿重渲染包括接触后阶段在内的整段示范,并把动作换算到新底座坐标系。作者报告,五项真机任务在未见底座位姿上的平均成功率为 37%,最强基线为 17%。以下数字均为作者报告 [R],本站没有复现。
问题:底座停偏,视角就变了
论文把底座位置偏差归因于导航不确定、定位漂移、避障和规划不精确。相机装在机器人头部或躯干上,底座一动,策略看到的画面就和示范时不同。最直接的办法是在许多位置都采示范,但作者指出真机遥操作昂贵、难以扩展。
用 NVS 生成新视角示范是另一条路。论文列举的 VISTA、Yang 等人基于 3D Gaussian Splatting 的方法、One-Thousand Trajectories 和 EgoDemoGen,都没有显式重建移动中的物体。物体在示范中被移动,这些方法只能增强接触前的接近动作,或者生成几何不一致的画面。作者认为,接触后的交互阶段恰是示范中最关键的部分。
论文的出发点是:标准的移动操作数据采集已经提供了重建所需的多视角观测。导航轨迹从不同角度看到静止的场景和物体;操作示范本身提供以物体为中心的观测和物体的运动轨迹。
做法:场景、物体、机器人分三路渲染
采集时,机器人先从不同起点导航到 N 个目标底座位姿,再在每个位姿固定底座做 M 条操作示范。动作是 7 维指令:底座坐标系中的末端平移增量、旋转增量,加夹爪指令。MoMaSplat 用这两类数据做以下几步:
- 静态场景。用导航帧跑 COLMAP,得到相机位姿和稀疏点云,以此初始化 3DGS;采用 WildGaussians 的不确定性形式,降低帧间不一致区域的权重。重建时遮掉被操作物体和机器人的像素,避免物体被固定进场景,之后合成时出现静止的“重影”。运动恢复结构(SfM)得到的尺度未知,而动作换算需要米制,所以用机载深度相机定尺度:比较实测深度与渲染深度,逐像素取比值的中位数(附录写明再对各帧中位数取中位数)。
- 被操作物体。用 Grounded-SAM 与 SAM 2 分割物体,遮掉背景和机器人后送入前馈 3D 基础模型 FastVGGT,得到每帧相对物体的相机位姿。这些位姿在模型自己的坐标系里,尺度、方向和原点都是任意的。对齐的关键是导航帧:导航时物体静止,同一批相机同时被 FastVGGT 和 SfM 定位,两条轨迹只差一个 Sim(3) 变换,用 Umeyama 算法闭式求出。实验中对齐用一段导航示范的 50 帧。之后联合优化物体位姿和物体的 3DGS。铰接物体只把运动的那个刚性部件(笔记本电脑的屏幕盖、空气炸锅的炸篮)当作物体,其余部分留在场景里;不估计铰接参数,也不外推到示范之外的运动。
- 采样底座位姿。在每个原底座位姿周围的区域内均匀采平面位置(实验中为 1.2 × 1.2 m),朝向设为让物体位于相机视野中央,再加均匀噪声。保持末端相对物体的位姿不变,在示范中的若干探测时刻检查逆运动学(IK)是否有解,无解则拒绝并重采。
- 渲染与合成。按新底座位姿放置虚拟相机,内参与真实相机一致。场景和物体用 3DGS 渲染;机器人用 IK 求出关节后在 OmniGibson 中渲染。三路图像按每个像素的深度排序,从前到后做 alpha 合成,近处遮挡远处。
- 换算动作与本体感觉。末端位姿乘上原底座系到新底座系的变换;平移增量用该变换的旋转部分旋转;旋转增量的转轴随之旋转、转角不变;夹爪指令不变。
- 训练。每条源示范生成 K 条合成示范,用 Diffusion Policy 在两者的并集上训练,采样比例为源数据 0.25、合成数据 0.75。
第 5 步可以用一个简化例子理解(本站举例,不是论文数据):假设新底座与原底座位置相同,只向左转了 90°,并设底座系 x 轴向前、y 轴向左。原底座系里“向前 0.10 m”的平移增量,在世界中的位移不变,但在新底座系里表示为“向右 0.10 m”(y 为 −0.10 m)。如果只换图像、不换动作,策略学到的就是一个与画面不符的动作标签。论文对 VISTA 结果差的解释之一正是它不换算动作。
实验设置:五项真机任务,每个未见位姿 3 次
三个场景五项任务:书桌场景的 Pick-Place Bottle 和 Open Drawer,客厅场景的 Pick-Place Remote 和 Close Laptop,厨房场景的 Open Air-fryer,涵盖刚体抓放和单自由度铰接物体。Close Laptop 采 75 条示范,其余任务各 90 条,分布在三个底座位姿;另采 9 条导航轨迹。每种方法对每条源示范生成 10 条合成示范,每个任务共 750–900 条(One-Thousand Trajectories 在 Pick-Place Bottle 上为 400 条,见下)。
评测时,每个任务在 12 个未见底座位姿上各跑 3 次,即每任务 36 次、五个任务共 180 次(本站计算);未见位姿距原位姿 5–50 cm。三个原位姿各跑 15 次。
四个基线都由作者实现或配置,都用同样的源示范:
- Source Only:不做增强的 Diffusion Policy。
- Action Augmentation:给本体感觉和动作加零均值高斯噪声,图像不变。
- VISTA:用 ZeroNVS 逐帧生成新视角,动作不变;平面扰动在每轴 ±10 cm 内,作者称超出这个范围图像伪影明显、模仿学习结果变差。逐帧生成的画面在时间上不一致。
- One-Thousand Trajectories:用与 MoMaSplat 相同的流程重建静态场景,但不遮掉物体;作者给它加上了 MoMaSplat 的动作换算,去掉了原方法另外的轨迹增强。Pick-Place Bottle 上只有 40 条示范的物体初始位姿与重建场景一致,因此只用它们生成 400 条;90 条源示范仍全部用于训练。
结果:未见位姿平均 37%,远距离差距最大
| 方法 | 未见底座位姿成功率(五项任务平均) |
|---|---|
| MoMaSplat | 37% |
| One-Thousand Trajectories | 17% |
| VISTA | 8% |
| Source Only | 6% |
| Action Augmentation | 6% |
在原底座位姿上,各方法表现相当。在未见位姿上,Source Only 和 Action Augmentation 在多数任务中超过 10 cm 就接近零,作者据此认为只扰动动作而不改变观测,对底座偏移几乎没有帮助。One-Thousand Trajectories 下降得更平缓,但距离大时仍会掉下来,作者的解释是它只增强自由空间里的接近动作。作者报告 MoMaSplat 在每项任务上的未见位姿总成功率都最高,在每个距离区间都不低于所有基线;例如 Pick-Place Bottle 在 30 cm 处为 33%,Close Laptop 在 40 cm 处为 50%,这两处所有基线都是 0。本站读到的正文和图 4–5 的图注没有给出每个距离区间的位姿数和置信区间。
源示范数量的影响只在 Pick-Place Bottle 上测:分别用 10、50、90 条源示范,各自生成 10 倍合成示范,在距原位姿 10–20 cm 的 4 个测试位置上,成功率为 33%、42%、50%;90 条源示范不做增强只有 8%。这几个百分数恰好与 4 个位置各 3 次、共 12 次试验的 4/12、5/12、6/12、1/12 相符,但论文这一段没有写明每个位置的次数,这是本站的推断。若推断成立,相邻两档之间只差 1 次成功。
生成质量先在仿真中评估。作者在 OmniGibson 里搭了一个仿照书桌场景的 Sim Pick-Place Bottle(任务结构相同,不复制几何),把生成示范的换算动作在仿真中执行并渲染机载相机作为真值。75 条生成示范每隔十帧取一帧,共 2,486 帧;这些视角与重建所用视角的距离为 0.4–27.3 cm。
| 区域 | PSNR (dB) ↑ | SSIM ↑ | LPIPS ↓ |
|---|---|---|---|
| 整幅图像 | 21.27 ± 1.12 | 0.902 ± 0.019 | 0.253 ± 0.030 |
| 场景 | 26.40 ± 2.18 | 0.936 ± 0.021 | 0.248 ± 0.037 |
| 物体 | 18.18 ± 2.15 | 0.688 ± 0.081 | 0.341 ± 0.106 |
| 机器人 | 17.43 ± 1.30 | 0.812 ± 0.057 | 0.287 ± 0.048 |
场景 PSNR 每条示范只算一帧(共 75 帧)。作者拿原始 3DGS 论文在 Tanks & Temples 上约 23 dB 作参照,这是不同的数据集,只能当量级参考。物体较低,作者归因于运动物体的视角覆盖有限;机器人误差主要来自合成时的光照和阴影差异。在 30 条源示范上,估计的物体位姿相对仿真真值的平移误差为 1.46 ± 0.71 cm,旋转误差为 4.01° ± 4.66°。真实数据上,遮掉机器人和物体后场景在 110 个留出帧上为 24.00 dB;物体取其包围框裁剪区域并遮掉背景后计算,在 VGGT 直接定位的位姿上为 23.63 dB,在插值位姿上为 22.59 dB;这与上表仿真中按物体掩码计算的 18.18 dB 口径不同,不宜直接比较。仿真机器人与真实机器人外观不同,作者因此没有报告真实数据的整幅图像指标。
和本站内容的关系
物理AI实验室 1.6 讲过行为克隆的误差怎样把机器人带出示范覆盖的范围。底座停偏是另一种越界:策略还没动手,看到的画面就已经不在训练分布里。MoMaSplat 不多采真机示范,而是沿“底座位姿”这一维把观测覆盖补出来;它用的策略也正是 1.6 讨论过的 Diffusion Policy。
物理AI实验室 1.5 把合成列为数据的第三条来路。按论文相关工作一节的说法,MimicGen 一类方法生成的是纯运动学计划,通常还要在真机上开环回放来验证可行性并采集画面;MoMaSplat 的取舍是重建真实场景和物体,仿真只用来渲染已知的机器人本体。第 5 步的坐标换算可以对照 物理AI实验室 1.1 的坐标系与运动学来读。
前沿雷达 2026-10-16 的 Cracking Mobile Manipulation 是在规划、底座位姿和末端几个阶段加干预;MoMaSplat 走另一条路:不要求底座停得准,而是训练对底座偏移不敏感的策略。读每任务 36 次、按距离分箱的成功率时,可以用 物理AI实验室 1.8 的方法先数清每个百分数背后有几次试验。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。论文称将公开代码,本站读到的正文没有给出代码地址。
- 每个任务只有 12 个未见位姿、每个位姿 3 次;本站读到的正文和图 4–5 的图注没有给置信区间,也没有给出每个距离区间的位姿数。30 cm 处 33%、40 cm 处 50% 这类单格数字可能只对应很少几次试验。
- 四个基线由作者实现或配置:VISTA 的扰动限制在每轴 ±10 cm,One-Thousand Trajectories 加了 MoMaSplat 的动作换算并去掉了原方法的轨迹增强。比较结果依赖这些设置。
- 生成质量的仿真评估使用仿照书桌、不复制其几何的场景,视角距离为 0.4–27.3 cm。这与策略评测中最远 50 cm 的底座距离不是同一个量,本站读到的正文没有给出 27.3 cm 以外视角的保真度数字。
- 作者自述的局限:方法假设场景基本静态、物体刚性且可见,可变形物体、严重遮挡和少纹理表面都难处理;物体初始位置挡住的区域(被提起的瓶子下方、拉开的抽屉内部、空气炸锅炸篮内部)在场景重建中从未被观测到,露出时没有建模;依赖开放世界分割的一致性;生成示范只是回放源物体轨迹,不建模接触力和动力学,因此不是物理上的示范;视角质量取决于导航数据的覆盖。
- 任务只有刚体抓放和单自由度铰接,底座采样限于原位姿周围 1.2 × 1.2 m 的区域,不涉及大范围导航。
- 真机成功率衡量的是任务完成,不是安全验证;仿真中的保真度也不能替代真机测试。
链接
- MoMaSplat: Dynamic Novel-View Demonstration Augmentation for Mobile Manipulation(arXiv 2611.08372)
- 论文 HTML 全文
- 物理AI实验室 1.1:坐标系与运动学,手算一条两连杆手臂怎样够到杯子
- 物理AI实验室 1.5:数据从哪来,从 SO-101 元数据算出示范时长,再分清三条来路的单位与动作空间
- 物理AI实验室 1.6:模仿学习,手算误差怎样滚出示范覆盖范围,再把 ACT、扩散策略与数据规模律的数字放回各自条件
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 前沿雷达|Cracking Mobile Manipulation:子任务成功率 80%,串成移动操作只剩 19%,先给失败回合归因,再逐段加干预
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)


