本节视频
配音由 AI 合成。 视频章节、文字稿与出处
文字稿
文字稿
知行问
看图、听指令、再动手,三个机器人模型的做法一样吗?这一集,我们拆开三个视觉-语言-动作模型。看它们的视觉、语言骨干和动作头,差在哪。
一张共同的骨架
先说共同点。视觉-语言-动作模型,简称 VLA。给它图像和一句指令,它直接吐出机器人的动作。我们用一个动作贯穿全集:把桌上的杯子,放进篮子。看同一个动作,在三个模型里怎么走。和聊天模型比,VLA 多了一件硬约束。它的输出,要能驱动电机。所以它既要懂语义,又要懂几何。拆开看,它有三块。第一块看世界,第二块懂语言,第三块生成动作。这一集,主角是第三块。还有一个词很关键:跨本体。人们希望同一个模型,能管机械臂、双臂,甚至人形。过去,机器人要拆成好几段:感知模块、规划模块、控制模块。VLA 想把它们合成一整块,端到端地学。OpenVLA、π-zero、GR00T,首个来自斯坦福等。第二个来自机器人 AI 公司,第三个来自英伟达。论文称,OpenVLA 和 GR00T 已公开发布。
动作头:三条路线
动作头,就是模型怎么把想法,变成一串真正的动作。三个模型,走了三条不同的路。先看 OpenVLA。它把动作当成文字。论文写道,把每个动作维度,切成两百五十六个区间。好处是简单:语言模型怎么生成字,就怎么生成动作。π-zero 论文称,这样做遇到高频、高度灵巧的任务,会吃力。流匹配怎么干活?先给模型一团噪声,再一步步去噪。噪声最后变成一段平滑的动作。再看 π-zero。它不吐词元,改用流匹配。论文称,这是一种扩散式的动作生成方式。它在语言模型旁边,加了个小小的动作专家。论文称,靠动作分块加流匹配,控制频率最高能到五十赫兹。第三个,英伟达的 GR00T N1,整个模型分快慢两套系统。论文写道,慢的是视觉-语言骨干,看图讲理解。快的是动作模块,负责生成动作。这里借了个比喻。慢系统像大脑,慢慢想;快系统像小脑,飞快地动。不过,这只是类比。那个快系统,是一个扩散 transformer。论文写道,它也用流匹配训练。它输出闭环动作,频率高到一百二十赫兹。所以,OpenVLA 数词元,另两个都用流匹配。π-zero 挂个动作专家,GR00T 另设快系统。为什么连续生成更顺?因为动作本来就是连续的量。一个字一个字蹦,反而别扭。π-zero 论文称,靠分块加流匹配,能做又快、又精细的活。论文就用叠衣服做了演示。原来动作头不是标准件,选哪条路,直接决定手稳不稳!
视觉与语言骨干
再往前一块,是看世界和懂语言。这里,三个模型站在不同的开源巨人肩膀上。OpenVLA 的语言骨干,是 Llama 2。论文说,它的眼睛把两套视觉特征,拼在一起。为什么拼两套眼睛?论文说,一套偏语义,一套偏空间。机器人干活,两样都得要。整个模型,论文称有七十亿参数。它用了大约九十七万条真实机器人示范,来训练。π-zero 更小巧。论文称,它的骨干,是开源模型 PaliGemma。再加上那个小小的动作专家。论文称,两者加起来,大约三十三亿参数。第三个模型的骨干,来自英伟达。论文写道,它用的是 Eagle-2 视觉语言模型。这个 Eagle-2,也是拼出来的。论文写道,它由 SmolLM2 微调而来。视觉编码,用的是 SigLIP-2。论文称,公开发布的这版 GR00T N1,共有二十二亿参数。它比另外两个都小,主要面向人形机器人。把三条轴摆在一起:视觉编码、语言骨干、动作头。这就是拆解任何 VLA 的地图。
局限与权衡
为什么不从零训练?从零学语义、认识物体,太贵也太慢。借来的大模型,已经认识杯子和篮子。再补一个权衡。数词元是一个一个来,分块加流匹配,能一次出一整段。延迟和精度,就在这里拉扯。怎么算强?要看成功率、速度,还要看在没见过的物体上稳不稳。这些,后面几集接着聊。注意,参数量不是越大越好。GR00T 最小,可小不说明强,也不说明弱。合不合适,看任务。OpenVLA 和 GR00T 开放下载,还有一层意思。你能自己下载、自己微调,甚至自己复核。站在开源模型肩上,还有个好处。社区每前进一步,VLA 都能顺手接过来。还没解决的是:拆出来的这些名字,不代表哪个一定强。真机上谁更好,还得一个个测。换个机器人、换个环境,排名可能又变了。回顾一下,三个要点。一,VLA 都是看图、懂语言,再输出动作。二,动作头:OpenVLA 逐个吐词元,另两个都用流匹配。三,视觉和语言骨干,各站在不同开源模型上。名字记不住没关系,记住三块结构就够用了!可这些模型的训练数据,从哪来?下一集,我们去造一个世界。下一集见!
证据与出处
256 个 · OpenVLA 的动作头:把每个动作维度离散成 256 个区间,当作词元来预测 [R] · arXiv 2406.09246 · OpenVLA
流匹配 · π-zero 的动作头:在预训练视觉-语言模型上,用流匹配(扩散的变体)生成连续动作 [R] · arXiv 2410.24164 · π0
50 赫兹 · π-zero 用动作分块加流匹配,把控制频率最高做到 50 赫兹(论文称,峰值,用于叠衣等灵巧任务) [R] · arXiv 2410.24164 · π0
流匹配 · GR00T N1 的快系统(扩散 transformer,DiT)也用流匹配学习生成动作(论文) [R] · arXiv 2503.14734 · GR00T N1(NVIDIA)
Llama 2 · OpenVLA 语言骨干是 Llama 2;视觉编码器把 DINOv2 与 SigLIP 两套特征融合 [R] · arXiv 2406.09246 · OpenVLA
70 亿 · OpenVLA 参数量(7B);用约 97 万条真实机器人示范训练(论文) [R] · arXiv 2406.09246 · OpenVLA
PaliGemma · π-zero 的视觉-语言骨干,权重初始化自开源模型 PaliGemma(论文) [R] · arXiv 2410.24164 · π0
33 亿 · π-zero 合计约 33 亿参数(30 亿 VLM + 3 亿动作专家,论文) [R] · arXiv 2410.24164 · π0
Eagle-2 · GR00T N1 用英伟达 Eagle-2 作视觉-语言骨干(论文) [R] · arXiv 2503.14734 · GR00T N1(NVIDIA)
22 亿 · GR00T-N1-2B 总参数约 22 亿,其中约 13.4 亿在视觉-语言骨干里(论文) [R] · arXiv 2503.14734 · GR00T N1(NVIDIA)
动手与自测
小测公开,答案与解析在作答后显示;图文课里的练习答案需登录查看。
第 3.1 集的视频进入 L3,拆开三个视觉-语言-动作模型(VLA):OpenVLA、π0(π-zero)和 GR00T N1。视频讲了三件事:三者骨架相同,都是看图、懂语言、再直接输出动作,内部分成看世界、懂语言、生成动作三块;动作头走了三条路,OpenVLA 把每个动作维度切成 256 个区间当词元,π0 用流匹配加一个动作专家,GR00T N1 的快系统是用流匹配训练的扩散 transformer;视觉与语言骨干各站在不同的开源模型上(Llama 2、PaliGemma、Eagle-2),名字和参数量都不代表强弱。片中的数字卡出自三篇 arXiv 论文:OpenVLA(2406.09246)、π0(2410.24164)和 GR00T N1(2503.14734)。本篇是这一集的图文课与练习,不重复文字稿,而是做三件视频只点到的事:在一个虚构的放杯动作上把“切成 256 个区间”算一遍,看区间宽度由什么决定、超出范围的值会怎样;把两种流匹配动作头出一段动作要做几步积分、论文给了哪些计时,放回各自的硬件和设置;把 7B、3.3B、2.2B 三个总参数拆到论文点名的各块,看清它们各自数的是什么。贯穿全文的规则:一个参数量、频率或计时,只属于报告它的那篇论文、那个版本的模型和那台硬件;三篇论文的数字不能互相换算,也不能拼成一张排行榜。
本节视频、文字稿与出处在本页上方,全季安排见课程大纲。上一课物理AI实验室 2.8:可复现评测,手算 Wald 与 Wilson 区间,从 1/√n 定评测次数,再给零失败算出失败率上界结尾问:那个会看、会想、会动的大模型,内部到底长什么样?本课接着回答。π0 在 50 Hz 的机器人上每执行 25 个动作重新推理一次、快慢两套系统怎样分层,物理AI实验室 0.3:看-想-动,把三个频率放回各自的系统已经放回各自的系统;用流匹配训练的动作专家和异步动作队列,物理AI实验室 2.3:微调 SmolVLA,为一句指令配好示范数据,核对每个数字的口径,再给异步动作队列算时间账已经讲过;动作块该定多长,物理AI实验室 2.6:上边缘,从时延日志算出控制频率上限,分清量化省下的是体积还是时间,再给动作块定长度已经算过。本课不再重复这些,只讲三篇论文本身怎样写这三块,以及读它们的数字时要标清的口径。0.3 引用的是 GR00T N1.7 的厂商博客;本课读的是 GR00T N1 论文,文中的 GR00T 数字只属于 GR00T-N1-2B。下一集 3.2 讲用 Cosmos 生成与迁移训练数据的世界模型。
公开小测的 5 道题附完整解析;登录后可完成三项练习:把一个虚构放杯动作中的三维编成 256 个区间的索引,算出还原误差和越界误差;把三个模型的总参数拆到各块,给积分步数和计时记账,再判断四条说法;审一份虚构的 VLA 选型备忘录,把每句话放回论文原文的条件,改写它,并列出要在自己的机器人上实测的项目。每项都附分步解法、常见错误与 20 分评分标准。
一、三篇论文怎样写这三块
三篇都是 arXiv 预印本,按本课程的分级属 R 级;下面的结构和数字都是作者报告,本站没有复现,也没有运行其中任何一个模型。GR00T N1 是 NVIDIA 对自家模型的报告。片中数字卡对应的原文如下,各自独立摘录。
OpenVLA(Kim 等,作者来自 Stanford University、UC Berkeley 等机构,arXiv 2406.09246)的摘要:
we introduce OpenVLA, a 7B-parameter open-source VLA trained on a diverse collection of 970k real-world robot demonstrations.
OpenVLA builds on a Llama 2 language model combined with a visual encoder that fuses pretrained features from DINOv2 and SigLIP.
方法一节(HTML v1)讲动作的一句:
we discretize each dimension of the robot actions separately into one of 256 bins.
论文的结构图说明把模型分成三部分:拼接 DINOv2 与 SigLIP 特征的视觉编码器、把视觉特征映射到语言嵌入空间的投影层,以及 Llama 2 7B 语言骨干;给定一张观测图像和一句语言指令,模型预测 7 维的机器人控制动作。它建在 Prismatic-7B 视觉-语言模型上:一个 600M 参数的视觉编码器、一个 2 层 MLP 投影层和一个 7B 参数的 Llama 2。输入的图像块分别通过两个编码器,得到的特征按通道拼接;论文说,加入 DinoV2 特征有助于空间推理。视频里“一套偏语义、一套偏空间”对应相关工作一节的说法:来自 DINOv2 的低层空间信息,加上来自 SigLIP 的高层语义。
π0(Physical Intelligence,arXiv 2410.24164)的摘要:
We propose a novel flow matching architecture built on top of a pre-trained vision-language model (VLM) to inherit Internet-scale semantic knowledge.
引言、框架图说明和模型一节(HTML v1):
This enables our model to control robots at frequencies of up to 50 Hz for dexterous tasks such as laundry folding
The VLM backbone weights are initialized from PaliGemma , providing representations learned from large-scale Internet pre-training.
PaliGemma is an open-source 3 billion parameter VLM that offers a convenient tradeoff between size and performance. We add 300M parameters for the action expert (which is initialized from scratch) for a total of 3.3 billion parameters.
第一句里的 This,指论文前一句说的动作分块架构加流匹配(论文称流匹配是扩散的一种变体)。框架图说明写明,模型由一个较大的 VLM 骨干和一个较小的、处理机器人状态与动作的动作专家组成。第 IV 节说,图像编码器把观测图像嵌入到和语言词元相同的空间。论文还说,用 PaliGemma 是为了方便,也因为它相对小、便于实时控制,而框架可以接任何预训练 VLM;作者另训练了一个不用 VLM 初始化、470M 参数的 π0-small,用于消融对比。
GR00T N1(NVIDIA,arXiv 2503.14734)的摘要与正文(HTML v1):
GR00T N1 is a Vision-Language-Action (VLA) model with a dual-system architecture. The vision-language module (System 2) interprets the environment through vision and language instructions. The subsequent diffusion transformer module (System 1) generates fluid motor actions in real time.
It generates closed-loop motor actions at a higher frequency (120Hz).
We use the NVIDIA Eagle-2 VLM ( Li et al., 2025 ) as the vision-language backbone.
Specifically, our publicly released GR00T-N1-2B model has 2.2B parameters in total, with 1.34B in the VLM.
Eagle-2 is finetuned from a SmolLM2 ( Allal et al., 2025 ) LLM and a SigLIP-2 ( Tschannen et al., 2025 ) image encoder.
模型结构一节还写明:GR00T N1 用流匹配学习生成动作;System 1 的扩散 transformer(DiT)通过交叉注意力读取 VLM 输出的图像与文本词元,并用按本体区分的编码器和解码器处理不同维度的状态与动作。引言说,System 2 在一块 NVIDIA L40 GPU 上以 10 Hz 运行。
下表是本课对三篇原文的整理,不是原文句子:
| 这一块 | OpenVLA | π0 | GR00T N1 |
|---|---|---|---|
| 视觉编码 | DINOv2 与 SigLIP 的特征按通道拼接,600M | 图像编码器把观测嵌入语言词元的同一空间;属于 PaliGemma,所读段落没有单列参数 | SigLIP-2(Eagle-2 的一部分);每帧 224 × 224,得到 64 个图像词元 |
| 语言骨干 | Llama 2 7B | PaliGemma(3B,整个 VLM) | Eagle-2,由 SmolLM2 微调;GR00T-N1-2B 取 LLM 第 12 层的表示 |
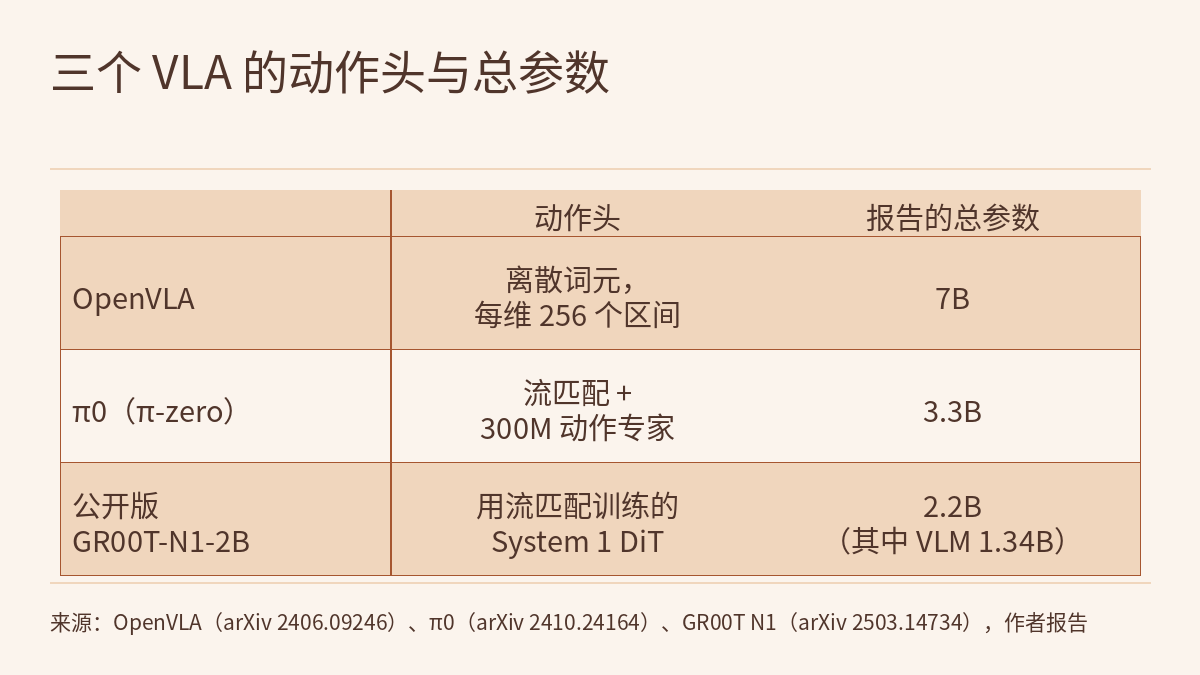
| 动作头 | 每维 256 个区间的离散词元,按下一个词元预测训练 | 300M 的动作专家,流匹配,输出动作块 | System 1 DiT,流匹配,一块 16 个动作 |
| 论文报告的总参数 | 7B | 3.3B | 2.2B(其中 VLM 1.34B) |
| 所读段落写明公开的内容 | 模型检查点、微调 notebook、PyTorch 代码;脚注说还发布了复现所需的训练数据、代码和权重 | 没有说明 π0 自身的权重是否公开;只说 PaliGemma 是开源 VLM | GR00T-N1-2B 检查点、训练数据和仿真基准 |
读这张表要注意两点。第一,“开源”在三篇里指的东西不同。OpenVLA 的脚注说,它用到的 SigLIP、DinoV2 和 Llama 2 只开放了权重,没有开放训练数据和代码;GR00T 写明公开的是 GR00T-N1-2B 这一版。视频因此只说 OpenVLA 和 GR00T“论文称已公开发布”,不说“三个开源模型”。第二,“骨干”覆盖的范围也不同:π0 的 VLM 骨干包含图像编码器,OpenVLA 把视觉编码器单独列出,GR00T 的 1.34B 是整个 VLM。
登录后继续阅读本课其余各节、自测题与答案。
局限 / 注意
- 三篇论文都是 arXiv 预印本,属 R 级;结构、参数量、频率和计时都是作者报告,本站没有复现,也没有运行任何模型。GR00T N1 是 NVIDIA 对自家模型的报告。本课读的是 OpenVLA 的摘要、引言、相关工作和第 3 节到训练数据一节的开头;π0 的摘要、引言、相关工作、概述、第 IV 节开头,以及讲推理与参数量的那一段;GR00T N1 的摘要、引言、模型架构一节和训练数据生成一节的开头。
- π0 的推理耗时在论文附录 A-D,本课没有读;所读的 π0 段落没有给出动作块长度,也没有说明 π0 权重是否公开。
- 以下是本课的约定、算术或推断:OpenVLA 的索引向下取整、还原取区间中点、越界截断;分位数方案每维约截断 2% 的训练动作;GR00T 一块 16 个动作按 120 Hz 连续执行时覆盖 133 ms、采样约占 48%;参数的剩余量与比例;网络调用次数的计数。
- 第二节的 +4.2 mm、−10 到 +10 mm 和离群值,以及练习里的机器人 D、团队 Q、模型 Z、所有分位数、目标动作和备忘录句子,都是虚构的,不是任何论文或系统的数据。
- 三篇论文没有在同一台机器人、同一任务上比较这三个模型,本课也不做这种比较。纸面计算和仿真结果都不是硬件安全验证。
- 本课的 GR00T 数字只属于 GR00T N1 论文和 GR00T-N1-2B;0.3 引用的 GR00T N1.7 是另一个版本。
链接
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)
- 物理AI实验室 2.8:可复现评测,手算 Wald 与 Wilson 区间,从 1/√n 定评测次数,再给零失败算出失败率上界
- 物理AI实验室 0.3:看-想-动,把三个频率放回各自的系统
- 物理AI实验室 2.3:微调 SmolVLA,为一句指令配好示范数据,核对每个数字的口径,再给异步动作队列算时间账
- 物理AI实验室 2.6:上边缘,从时延日志算出控制频率上限,分清量化省下的是体积还是时间,再给动作块定长度
- Kim 等:OpenVLA: An Open-Source Vision-Language-Action Model(arXiv 2406.09246)
- OpenVLA(arXiv 2406.09246,HTML v1)
- Physical Intelligence:π0: A Vision-Language-Action Flow Model for General Robot Control(arXiv 2410.24164)
- π0(arXiv 2410.24164,HTML v1)
- NVIDIA:GR00T N1: An Open Foundation Model for Generalist Humanoid Robots(arXiv 2503.14734)
- GR00T N1(arXiv 2503.14734,HTML v1)