本节视频
配音由 AI 合成。 视频章节、文字稿与出处
文字稿
文字稿
知行问
一篇论文报了个漂亮的成功率。可你怎么知道,这个数字信得过?这一集,我们学怎么读前沿。不背结论,而是学会复核关键数字。这是研究者的基本功。
数字为什么会骗人
先说清楚,多数时候不是造假。是口径没对齐,或者不小心。但结果一样误导人。先分清两件事。一是数字算得对不对。二是它到底在说什么。数字被断章取义,也常见。一个峰值,被写成了日常。一看就吓人。读到一个数,先别急着惊叹。问一句,它是在什么条件下测的?条件不同,数就不同。举个真例子。有人微调 π0,早期报告改进九成六。后来把评测集和训练集严格分开,降到八成九。这不是个例。评测集悄悄混进训练,是最常见的坑之一。防不胜防。为什么成绩会偏高?因为模型在评测时,见过训练里的题。等于开卷考。原来不是它变差了,是之前那个数,本来就虚高!同样的坑,还有几个。演示不等于量产。峰值不等于常态。还有一个,仿真不等于真机。屏幕里成,不代表桌上也成。物理没那么听话。还有人只报最好的一次。跑十次挑一次,也能很好看。这叫挑樱桃。还有平均的花样。换种平均口径,数字也能好看几分。细看才发现。
一张核对清单
怎么少踩坑?给自己一张清单。读每一篇,都过一遍。第一问,谁在说?我们用一个前沿雷达来帮忙。它给每条结论,都标了证据等级。同一个结论,官方、论文、媒体说,分量完全不同。别一视同仁。先看谁在说。三档:官方一手是 O,论文预印本是 R,媒体二手是 M。厂商自己报的和同行评议的,别混。证据等级不是打分。它只是提醒你,这句话的分量有多重。心里先有个数。第二问,口径是什么?成功率算的是哪一步?是单步,还是整条任务?口径不写清,两篇论文的成功率,根本没法比。先对齐口径,再比高低。不然白比。同一个词,口径能差很远。抓取成功,是碰到就算,还是稳稳拿起?差别很大。第三问,怎么分的?评测集有没有混进训练集?这一条最容易翻车。怎么查?看它有没有写清,训练用哪些、评测用哪些。写不清就要警惕。分错了,模型等于提前看了答案。这种高分,一到新场景就垮。中看不中用。第四问,数字对得上吗?有个数据集,基准描述可能让人以为有五百段。可真去数,只有三百七十九段。别小看这条。硬按五百去跑,程序跑到一半就报错。所以数字要回原始文件核。还有一问,是峰值还是常态?厂商爱报最高,你要问平常跑多少。两者往往差一截。峰值当然可以报。但要标清楚,别让人当成日常。标注是本分。再一问,样本够吗?还是那篇 π0 的报告。它的数字,只在前五段留出集上平均。样本一小,名次就容易抖。细微差别可能只是噪声,别太较真。多跑几次更稳。这几问,都记下来。谁说的、什么口径、怎么分、是不是峰值、样本够不够?缺一条都可能被坑。
动手:用雷达复核
跟着做一遍。挑一条你关心的前沿结论,先在雷达里找到它。这里挑的是一篇讲评测方法的论文。为什么从雷达起步?因为它已经把等级和数字,替你抽好了。省一半功夫。第一件事,看日期。arXiv 用第一版的提交日为准。别把旧数字,当成新进展。雷达每天列几条前沿,条条带证据等级和抽出来的数字。先看它标 O、R,还是 M。心里先分个档。点进原文。别停在标题和摘要,翻到方法和结果那几段。数字都藏在那。看不懂全文没关系。你只要盯住,那一个关键数字。抓住主线就行。论文称,边跑边判的评测,比标准批量评测最多少跑七成。比只看成败的同类方法,最多少五成。把旁边那句原话抄下来,这就是你的证据。抄原话有讲究。它得能直接支撑那个数字。含糊的句子,不算数。抄的时候,把条件一起抄。这个七成是上限,比的是标准批量评测。离开条件就没意义,条件才是关键。拿那篇 π0 报告练手。它称,严格分开后,动作误差在两个数据集上,各降了约九成。但别停在这。看清口径,这是开环的动作误差,不是真机成功率。这是两码事。复核到这,你就比只看标题的人,懂得多了。你知道这个九成,成色几何。心里有杆秤。复核完,写下来。像刚才那篇论文,标上等级和链接,方便别人也能查。下次直接引用。以后再看到同一个数,你就有底了。这份记录,越攒越值钱。这就是复利。还没解决的是,复核靠人,费时间。而且原文有时也语焉不详。工具还能再帮点忙。回顾一下,三个要点。一,数字虚高多因口径,不是造假。二,读前沿先过一张核对清单。三,回原文核对,抄下能支撑数字的原话。会复核,你就从追热闹的,变成能判断的!这就是这门课想给你的。判断完模型,那机器人的身体、成本,又怎么看?这是产业的账。下一集见!
证据与出处
动手与自测
小测公开,答案与解析在作答后显示;图文课里的练习答案需登录查看。
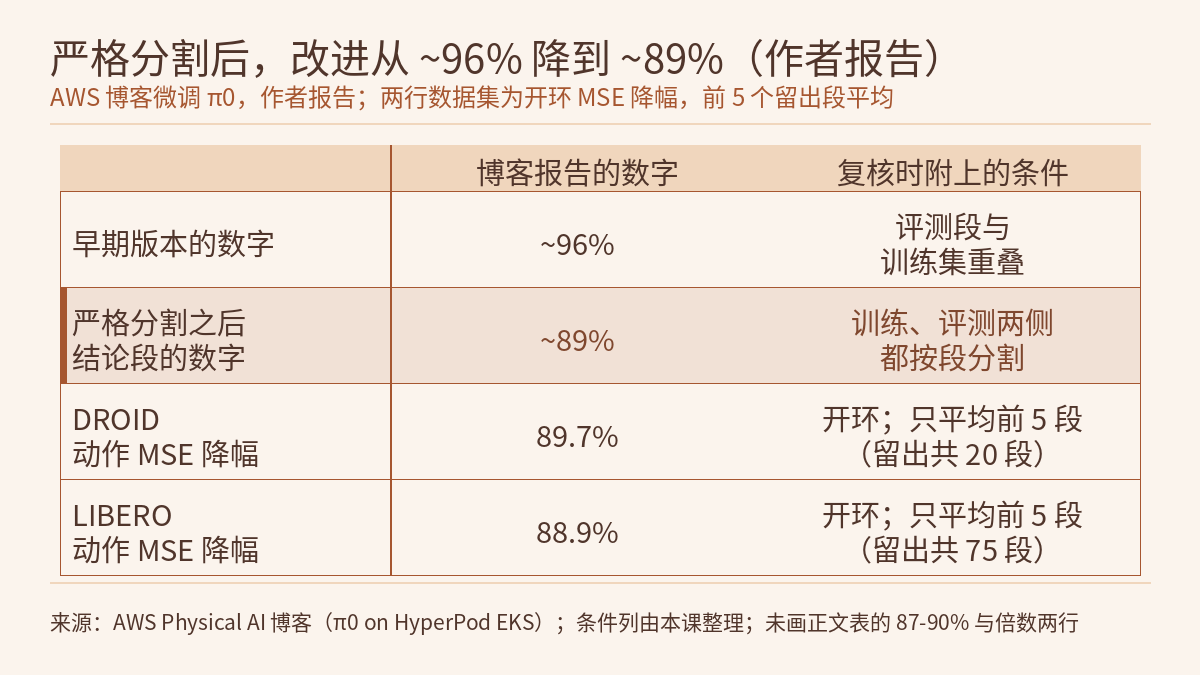
第 3.6 集的视频讲怎么读前沿:数字虚高多半不是造假,而是口径没对齐,比如评测集混进训练集、峰值当常态、仿真当真机;读每一篇都先过一张核对清单,问谁说的、什么口径、怎么分的、对不对得上、峰值还是常态、样本够不够;最后回原文,抄下一句能直接支撑那个数字的原话。片中的例子来自两份公开材料:AWS 在 SageMaker HyperPod EKS 上微调 π0 的工程博客,以及 arXiv 预印本 Beyond Binary Success(2603.13616)。本篇是这一集的图文课与练习,不重复文字稿,只做视频给了结论、没有展开的三件事:把同一篇博客里出现的几个“约九成”逐个对上指标和基线,换算降幅与倍数,看哪句话撑得起哪个数;从博客的划分表数清训练段和留出段,算出 N=5 覆盖了留出集的多少,找出原文没说明的那一层;再把论文摘要里的 70% 和 50% 放回各自的基线,看两个“最多”为什么不能连起来算。贯穿全文的规则:一个数字要和它的指标、基线、数据划分与样本量一起记录,缺了其中一项,这个数字就不能单独转述。
本节视频、文字稿与出处在本页上方,全季安排见课程大纲。上一课物理AI实验室 3.5:GR00T 微调实战,逐项核对微调命令与 modality 接线图,再用 CPU 替身实验分清开环误差和闭环成功率结尾问:这些成功率、这些改进,怎么判断是真的,还是被夸大了?本课接着回答。开环误差和闭环成功率差多远,3.5 已经用替身实验算过;同一篇 AWS 博客的“不到 200 ms、约 5 Hz 重规划”,物理AI实验室 3.4:长程任务,手算单步与整条链的成功率,看进度记忆改变了哪一项,再审一次只换高层的路由消融用过。O/R/M 三级、“最多”不等于“平常”、70% 省的是评测工作量而不是成功率,物理AI实验室 0.6:怎么判断一条机器人新闻靠不靠谱,把每一问落回原文那一句已经讲过、练过;配对比较和区间,分别在物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账和物理AI实验室 2.8:可复现评测,手算 Wald 与 Wilson 区间,从 1/√n 定评测次数,再给零失败算出失败率上界里算过。这篇论文本身的方法介绍见站内雷达前沿雷达|Beyond Binary Success:真机评测次数有限时,用序贯检验更早分出策略优劣。本课不再重复这些,只讲 L3 读者复核一篇材料时的三步:对指标、数划分、拆基线。下一集 4.1 讲本体与供应链:执行器、BOM 和成本曲线。
公开小测的 5 道题附完整解析;登录后可完成三项练习:把 AWS 博客的六组数字对成一张复核表,换算降幅与倍数,并审四句虚构的转述;核对博客的划分表与 N=5 的覆盖率,再给一个段数对不上的虚构数据集重写划分;审一段虚构的论文摘要转述,把 70% 和 50% 放回各自的基线并改写。每项都附分步解法、常见错误与 20 分评分标准。
一、三份材料各属哪一级,一条复核记录要写哪几栏
AWS 博客(Fine-Tuning π0 (Pi-Zero) for robotic manipulation on Amazon SageMaker HyperPod EKS)是 AWS 对自己一次微调实验的报告。π0 是 Physical Intelligence 的 30 亿参数流匹配 VLA;博客在两个数据集上微调它:真实 Franka 机械臂采集的 lerobot/droid_100,和仿真 Franka Panda 的 lerobot/libero_10。按本课程的分级属 O 级,下面的数字都是作者报告,本站没有运行这套流程。
Beyond Binary Success(arXiv 2603.13616)的作者来自 University of Pennsylvania、Toyota Research Institute 和 Princeton University。论文提出 N-SCORE,一种基于 safe, anytime-valid inference(SAVI)的序贯比较方法:证据够了就可以提前停止评测,指标可以是二值成败,也可以是部分得分、回报或轨迹平滑度这类有界的连续量。它是预印本,按本课程的分级属 R 级,以下也都是作者报告,本站没有复现。本课读的是 arXiv HTML 页面上从摘要到第四节开头的正文,不含实验结果各节和补充材料。
Physical AI 前沿雷达的 README 写明了三级的含义,原文是:
[O] 一手官方 · [R] 论文预印本 · [M] 媒体二手。厂商自报与同行评议不混为一谈。
同一份 README 的“怎么读”一节还说,R 级的数字是作者自报,O 级也要区分“平台可用”和“客户已部署”。所以 AWS 博客标 O,意思是“AWS 亲口说的”,不是“已经被独立验证”。
视频说复核的产物是“数字 + 一句能直接支撑它的原话 + 证据等级 + 链接”。L3 读者要多写几栏,因为本课后面三节查出来的问题,都出在这几栏里。下表是本课建议的记录格式,不是任何来源的规定;例子用的是博客里 DROID 那个数字:
| 栏目 | 写什么 | 例:博客的 DROID 数字 |
|---|---|---|
| 数字 | 原文写的值,连同“约”“最多”这类限定词 | 89.7% |
| 原句 | 逐字抄一句,一句一条,不拼接 | 见第二节第一段引文 |
| 指标与单位 | 量的是什么、是降幅还是倍数 | 动作预测 MSE 的降幅 |
| 基线 | 和谁比 | 基座检查点(lerobot/pi0_base) |
| 数据与划分 | 哪个数据集、训练与评测各用哪些段 | lerobot/droid_100,训练 0–79,留出 80–99 |
| 样本量 | 实际平均了几段、几颗种子 | 前 5 个留出段;所读文本没有写种子数 |
| 评测方式 | 开环还是闭环,仿真还是真机 | 开环,对照录好的轨迹 |
| 等级、链接、核对日期 | O / R / M,原文链接,你打开原文的那一天 | O,AWS 博客链接,自己的核对日期 |
| 原文没写的 | 转述时最容易被补上的那部分 | 闭环成功率、区间、种子数 |
最后一栏最容易被省掉。转述的人常常把原文没写的部分自己补上,比如把开环 MSE 的降幅写成成功率;把它单独列出来,下次引用时就知道哪些话不能说。
登录后继续阅读本课其余各节、自测题与答案。
局限 / 注意
- AWS 博客属 O 级,是 AWS 对自己一次微调实验的报告:~96%、~89%、89.7%、88.9%、87-90%、3.7×–5.6×、roughly 9×、划分表和 N=5 都是作者报告。本站没有运行这套流程,也没有核对它的仓库。所读文本是博客正文的摘录,没有看到种子数和置信区间。
- Beyond Binary Success 是预印本,属 R 级;70%、50%、10–60 次、4500 多次与 2000 次 rollout、第一类错误的证明都是作者报告,本站没有复现。本课读的是从摘要到第四节开头的正文,不含实验结果各节和补充材料,所以不知道上限出现在哪个数据集和指标上。“50% 的基线是 STEP 一类方法”是本课推断。
- 前沿雷达的 O/R/M 是来源的分类,用来提醒一句话的分量,不是对结论正误的判断。
- 以下是本课的计算、整理或建议:降幅与倍数的换算、覆盖率、“前五个”指 80–84 和 304–308 的字面推断、第一节的记录格式、第二节与第四节的对照表、40% 推不出来的论证。
- R1–R4、toy_shelf、同事 K 的摘要、60 次与 50 次的计划、预印本 P 和方法 X 都是虚构的。开环误差和纸面计算都不是任务成功率,也不是硬件安全验证。
链接
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)
- 物理AI实验室 3.5:GR00T 微调实战,逐项核对微调命令与 modality 接线图,再用 CPU 替身实验分清开环误差和闭环成功率
- 物理AI实验室 3.4:长程任务,手算单步与整条链的成功率,看进度记忆改变了哪一项,再审一次只换高层的路由消融
- 物理AI实验室 0.6:怎么判断一条机器人新闻靠不靠谱,把每一问落回原文那一句
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 物理AI实验室 2.8:可复现评测,手算 Wald 与 Wilson 区间,从 1/√n 定评测次数,再给零失败算出失败率上界
- 前沿雷达|Beyond Binary Success:真机评测次数有限时,用序贯检验更早分出策略优劣
- Physical AI 前沿雷达:每条标注证据等级的具身智能早报
- AWS:Fine-Tuning π0 (Pi-Zero) for robotic manipulation on Amazon SageMaker HyperPod EKS
- Beyond Binary Success: Sample-Efficient and Statistically Rigorous Robot Policy Comparison(arXiv 2603.13616)
- Physical AI 前沿雷达(GitHub,O/R/M 证据等级说明)