
遥操作机器人时,操作者通常不会边做边说出自己的打算。ETH Zurich 与香港中文大学作者的预印本 arXiv 2611.16419(2026-11-12)研究的问题是:只看一小段遥操作画面,视觉-语言模型(VLM)能不能同时说出操作者正在做的动作(如“拿起苹果”)和这个动作服务的任务(如“把苹果放到盘子上”),再把任务当作语言指令交给 VLA,让机器人接着做完。作者为此构建了 VI AMO 数据集,微调出 VIM 模型,并在 Franka 真机上做了人机交接实验。下文数字均为作者报告 [R],本站没有运行代码,也没有独立复现。
两层意图:当前动作和它服务的任务
论文把意图分成两层。当前动作(ongoing action,OA)是正在执行的一个原子操作步骤;当前任务(ongoing mission,OM)是由连续几个原子动作组成、服务于同一个直接目标的一段,例如“拿起苹果”加“把苹果放进篮子”合起来是“把苹果放进篮子”。作者认为两层都需要,因为同一个动作可以服务不同的任务:拿起苹果之后,可能放进篮子,也可能递给一个人。论文引用的 VOSA 和 CASPER 把意图表示为当前这一步的目标物体、位置,或从预定义技能库里选出的技能,没有显式推断动作背后的任务。
VIM 的输入有两部分:按时间排列的 n 帧画面(可以来自多路相机),以及一段文字形式的执行上下文,列出当前任务里已经完成的动作;列表为空时写作 “Robot has no previous actions.”。输出按固定格式写成 “Ongoing action: …” 和 “Ongoing mission: …”,在一次自回归生成里同时给出,都是开放词汇的自然语言,生成时不提供候选标签。这样预测出的任务可以直接充当语言条件策略的指令,不需要固定的技能库。难点在时机:交接时只看到了动作的一部分,模型得凭几帧画面和已完成动作的记录给出判断。
站内课程 物理AI实验室 2.3 讲过 VLA 把画面、机器人状态和一句语言指令一起变成动作,物理AI实验室 3.4 讲长程任务里给低层策略下指令的高层。这篇论文换了指令的来源:指令不由人写,也不由规划器给出,而是从操作者已经做过的动作里推断。
VI AMO 数据集:标签大多由模型起草
VI AMO 有 6,600 段示范,来自 11 个机器人数据来源(包括 Bridge V2、DROID、Fractal(RT-1)、TACO Play 等),共 13,653 条与时间对齐的动作标注和 9,702 条任务标注,按段划分为训练 5,500、验证 550、测试 550。动作标注里 DROID 占 6,372 条、Bridge V2 占 4,950 条,两者合计约 82.9%(本站按论文表 I 计算)。
标注流程分五步:
- 动作分解:GPT-5.6 Sol 根据原数据集的回合指令和首帧画面,列出有序的原子动作描述。
- 任务分组:GPT-5.6 Sol 逐对判断相邻动作是否明确连向同一个目标,是则并入同一任务,否则保留边界;单独的动作自成一个任务。
- 粗定位:Qwen3.7-Plus 从稀疏抽取的帧里估计每个动作的大致时间窗。
- 细化边界:在粗边界附近取连续帧,有夹爪开合信号时一并参考,由 Qwen3.7-Plus 判断动作在哪一帧完成。
- 人工审核:审核者在约 50% 的段里检查并修正动作描述、任务分组和时间边界。
VIM 以 Qwen3.5-27B 为底座,在视觉和语言两部分的注意力与 MLP 模块上做 LoRA(秩 16,α 16),只更新低秩参数,损失只算 OA 和 OM 两段文字。训练集有 11,481 个动作,每路相机取 4 帧,每个动作构造 6 种时间采样方式,共 68,886 个训练样本;BF16 训练一个 epoch,在单块 A100 80GB 上约 13.44 GPU 小时。
测试集结果:同一个底座,微调前后差多少
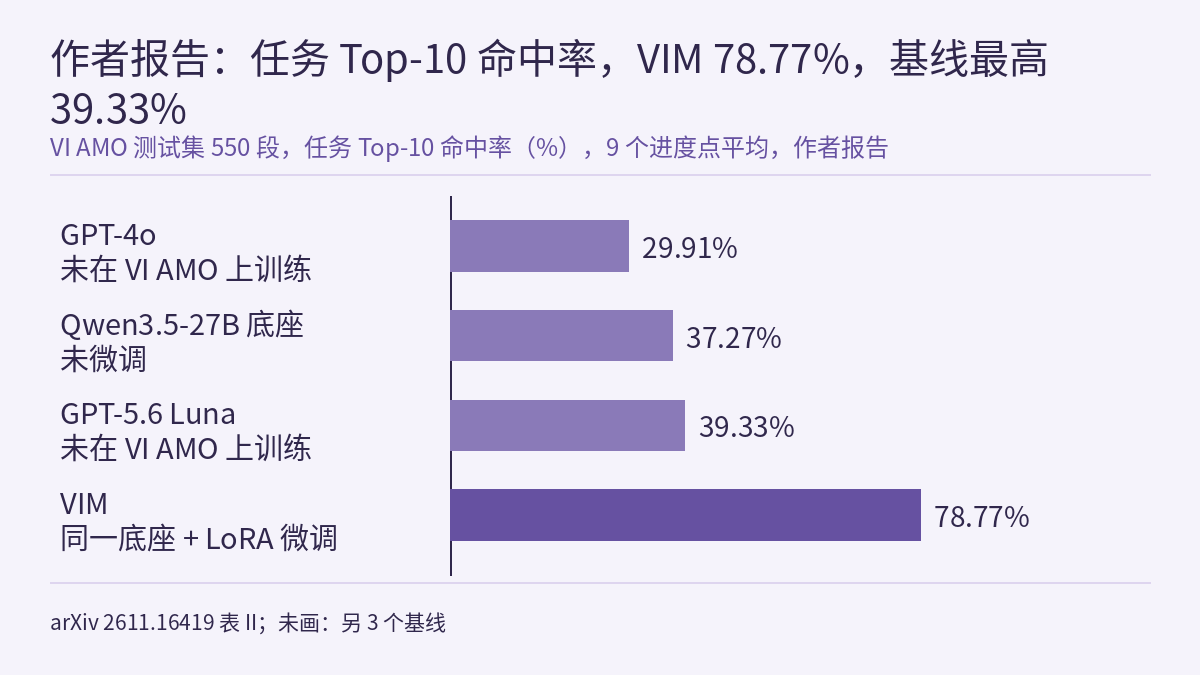
测试集 550 段与训练集不重叠,含 1,091 个动作、781 个任务实例。每个动作在 9 个进度点上评测(动作时长的 0% 到 95%),每次从动作开始到该时刻均匀取 4 帧。指标有四个:词级 F1;SBERT(all-mpnet-base-v2 句向量的余弦相似度);SigLIP 文本编码器的余弦相似度;以及 Top-10,即把测试集中全部去重标签(726 个动作标签、539 个任务标签)按与预测的 SigLIP 相似度排序,正确标签排进前 10 的比例。下表摘自论文表 II,为 9 个进度点的平均:
| 模型 | 当前动作 SBERT | 当前任务 SBERT | 当前任务 Top-10(%) |
|---|---|---|---|
| GPT-5.6 Luna | 0.581 | 0.554 | 39.33 |
| GPT-4o | 0.563 | 0.470 | 29.91 |
| Qwen Base (27B),未微调 | 0.581 | 0.564 | 37.27 |
| Qwen Base (9B) | 0.529 | 0.496 | 28.32 |
| RynnBrain 1.1-9B | 0.505 | 0.499 | 35.49 |
| RoboBrain 2.5-8B | 0.316 | 0.315 | 19.29 |
| VIM | 0.825 | 0.821 | 78.77 |
所有基线都没有在 VI AMO 上训练。最直接的对照是同一个底座:未微调的 Qwen3.5-27B 当前任务 SBERT 为 0.564、Top-10 为 37.27%,微调后的 VIM 为 0.821 和 78.77%;当前动作 Top-10 也从最高基线的 39.14% 升到 76.59%。两个面向机器人后训练的模型 RynnBrain 和 RoboBrain 没有超过通用 VLM,作者认为从动作推断操作者意图是一个独立的难题。本文配图只画了 GPT-4o、未微调的 Qwen3.5-27B、GPT-5.6 Luna 和 VIM 四条,表中另外 3 个基线未画入。
按进度看,VIM 的当前动作与当前任务 SBERT 从 0% 时的 0.776/0.776 升到 95% 时的 0.855/0.849,70% 以后增幅变小;在 0% 时(只看到动作起点)得分已为 0.776/0.776。消融里,去掉腕部相机降到 0.798/0.798,去掉文字上下文降到 0.767/0.788,把 4 帧历史换成 0% 时的一帧降到 0.793/0.792。
作者还按标签是否在训练中出现过拆分了 1,091 个测试动作:621 个的两个标签都见过,386 个(35.4%)都没见过,其余 84 个只有一个没见过。见过的部分 VIM 为 0.902/0.903,最强基线为 0.587/0.566;没见过的部分 VIM 降到 0.726/0.717,最强基线最高 0.570/0.564。这里的“没见过”按归一化后的标签字符串判断,换个说法的同义描述也会算作没见过,所以它不等于全新的动作或任务(本站推断)。
真机交接:VIM 给出任务,操作者确认,π0.5 接着做
真机平台是一台带平行夹爪的 Franka 机械臂,前方和腕部各一台 OAK-D 相机,操作者戴 Rokoko Smartglove 遥操作:手的相对运动控制末端,拇指与食指的捏合距离控制夹爪开合。交接流程是:
- VIM 读取从最近一次人工接管开始的历史,均匀取 4 组同步的前方/腕部图像,预测当前动作和当前任务。
- 操作者查看预测的任务,与自己的目标一致时确认,控制权交给 VLA。
- 经过微调的 π0.5 以预测的任务为指令,按标称 15 Hz 输出动作,接着完成操作。
- 操作者随时可以重新接管,手套映射重新对齐后机器人再次跟随操作者;之后的每次交接重复同一流程。
VIM 部署在一块 RTX 5090 上,用 TensorRT-Edge-LLM 运行,量化为 NVFP4,论文写明这样做是为了放进可用显存。量化在这里省的是显存,和 物理AI实验室 2.6 分开记的“体积”和“时间”两笔账可以对照着读。π0.5 用新采的示范微调:全部水果摆放任务 130 条,其余每项 100 条,在 4 块 A100 80GB 上联合训练 10,000 步。
5 项实验分属四类,每类考一种意图线索:苹果摆放和香蕉摆放在同一场景、只差目标水果;鸡蛋摆放要求常识性的物体-容器对应(鸡蛋放进蛋托);扫垃圾要从机器人去拿的工具读出目标;全部水果摆放要求连续多次推断和接续。这些场景都不在 VIM 的微调数据里。对照条件是用 GPT-4o 或 GPT-5.6 Luna 做意图模块,以及全程遥操作;每项实验每种条件各 5 次。
作者报告:VIM 在每项实验上需要的人工遥操作时间都少于两种 GPT 设置,平均比 GPT-4o 少 34.6%,比 GPT-5.6 Luna 少 39.8%。在扫垃圾一项里,两个 GPT 模型都没有给出可用的意图,这项实验因此全程遥操作。每次预测的平均延迟,VIM 在各项实验上为 0.70–0.81 s,GPT-4o 为 3.09–3.53 s,GPT-5.6 Luna 为 1.92–2.27 s,分别降低 76.9% 和 63.8%(摘要概括为平均约 70%)。作者解释说,很多操作动作只持续几秒,超过 2 秒的延迟会让推断出的意图落后于机器人的实际状态。
读这组结果要注意三点。第一,三种条件用的是同一个 VLA,比较的只是意图模块。第二,正文只给了相对两个 GPT 基线的百分比,相对全程遥操作的节省和绝对时间只画在图 5 里,所读文本没有数值;两个 GPT 基线在扫垃圾上直接退回全程遥操作,这一项会拉大平均差距(本站推断)。第三,VIM 是本地 GPU 上的量化模型,GPT 基线是 API 调用,延迟差异里包含部署方式的不同,不只是模型本身(本站推断)。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],没有独立复现。测试集结果没有给出区间、标准差或多种子结果;真机部分每项实验每种条件只有 5 次,均值与标准差只在图 5 中,所读文本没有数值。
- 评测用的参考答案由 GPT-5.6 Sol 起草、Qwen3.7-Plus 定位,人工只审了约 50% 的段。VIM 在这些标签上微调,学到了它们的措辞;未微调的基线没有,文本相似度类指标可能因此偏向 VIM(本站推断,论文没有讨论)。
- 测试段与训练段不重叠,但来自同一批数据来源(11 个来源中的 10 个;HYDRA 没有测试段);真机场景不在 VIM 的微调数据里,π0.5 却在这些实验任务上用 100–130 条示范专门微调过。
- 作者写明的局限:模型仍会预测错,也没有校准过的置信度,何时可以信任预测仍是开放问题;数据集评测假定动作边界已知,没有评估实时遥操作中的在线边界检测;VLA 执行比熟练操作者慢,所以人工控制时间减少,不一定意味着完成任务更快。
- 交接前由操作者确认预测的任务,这一步是论文流程的一部分;论文没有报告预测错误被操作者否决的次数,真机实验也不是安全验证。
- 论文称数据集、标注流程和 VIM 权重“将会”在项目页发布;本站没有打开该页面,也没有核实是否已经公开。
链接
- I See What You Want: Decoding Hierarchical Operator Intent from Visual Teleoperation History(arXiv 2611.16419)
- 论文 HTML 全文
- 物理AI实验室 2.3:微调 SmolVLA,为一句指令配好示范数据,核对每个数字的口径,再给异步动作队列算时间账
- 物理AI实验室 2.6:上边缘,从时延日志算出控制频率上限,分清量化省下的是体积还是时间,再给动作块定长度
- 物理AI实验室 3.4:长程任务,手算单步与整条链的成功率,看进度记忆改变了哪一项,再审一次只换高层的路由消融
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程


