
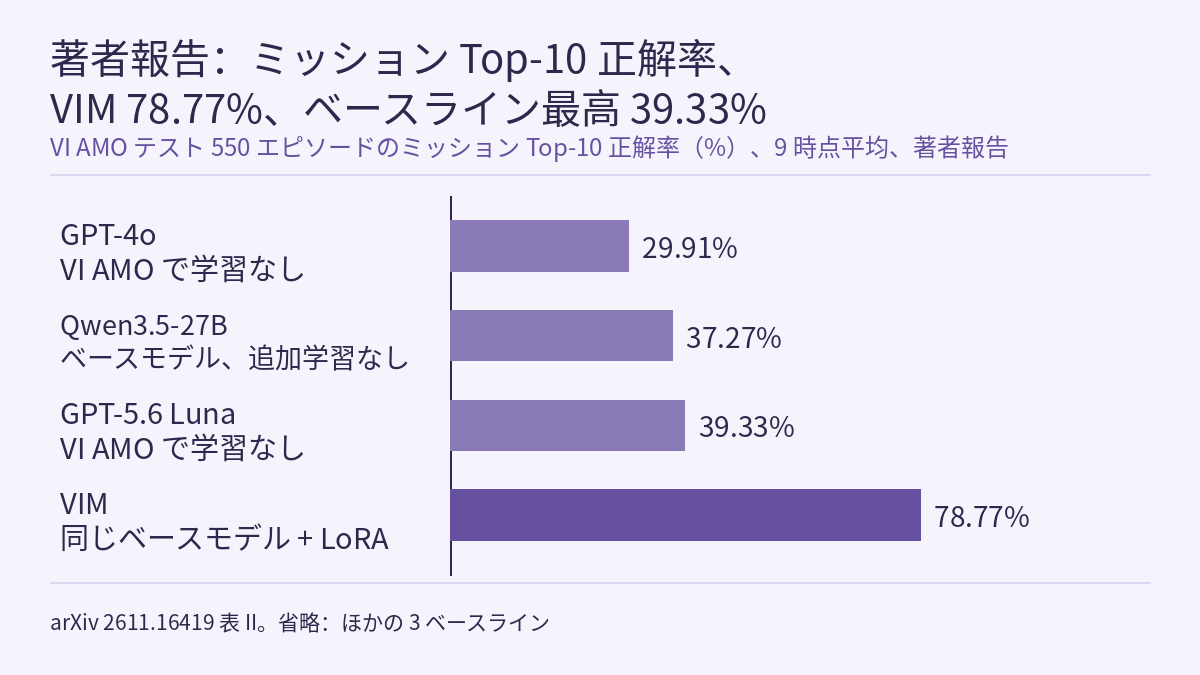
ロボットを遠隔操作している人は、作業しながら自分の意図を口に出すことはふつうありません。ETH Zurich と香港中文大学の著者によるプレプリント arXiv 2611.16419(2026-11-12)が扱うのは、短い遠隔操作の映像だけを見て、視覚言語モデル(VLM)が操作者の行っている動作(例:「リンゴを持ち上げる」)と、その動作が仕えるミッション(例:「リンゴを皿に置く」)を同時に言い当てられるか、さらにそのミッションを言語指示として VLA に渡し、ロボットに作業の続きを任せられるか、という問題です。著者は VI AMO データセットを構築し、VIM モデルをファインチューニングし、Franka の実機で人からロボットへの引き継ぎ実験を行いました。以下の数値はすべて著者報告 [R] で、本サイトはコードを実行しておらず、独立した再現もしていません。
2 階層の意図:進行中の動作と、それが仕えるミッション
論文は意図を 2 つの階層に分けます。進行中の動作(ongoing action、OA)は、いま実行中の 1 つの原子的な操作ステップです。進行中のミッション(ongoing mission、OM)は、1 つの直接の目標に仕える連続した原子動作のまとまりで、「リンゴを持ち上げる」と「リンゴをかごに入れる」を合わせると「リンゴをかごに入れる」になります。著者が両方の階層を必要とする理由は、同じ動作が異なるミッションに仕えうるからです。リンゴを持ち上げたあと、かごに入れることもあれば、人に手渡すこともあります。論文が引用する VOSA と CASPER は、意図を現在のステップの対象物体や位置、あるいは事前に定義したスキルライブラリから選んだスキルとして表しており、動作の背後にあるミッションは明示的に推定していません。
VIM の入力は 2 つです。時間順に並んだ n 枚のフレーム(複数のカメラから取ることもできます)と、現在のミッション内ですでに完了した動作を並べたテキストの実行コンテキストです。リストが空のときは “Robot has no previous actions.” と書きます。出力は “Ongoing action: …” と “Ongoing mission: …” という固定形式で、1 回の自己回帰生成で同時に出します。どちらもオープン語彙の自然言語で、生成時に候補ラベルは与えません。そのため予測したミッションを、固定のスキルライブラリなしで言語条件付き方策の指示としてそのまま使えます。難しいのはタイミングです。引き継ぎの時点では動作の一部しか見えていないので、モデルは数枚のフレームと完了済み動作の記録から判断を下す必要があります。
本サイトの講座では、フィジカルAIラボ 2.3 で VLA が画像、ロボットの状態、1 文の言語指示をまとめて動作に変えることを、フィジカルAIラボ 3.4 で長期タスクにおいて下位の方策に指示を出す上位層を扱いました。この論文は指示の出どころを変えています。指示は人が書くのでも計画器が出すのでもなく、操作者がすでに行った動作から推定されます。
VI AMO データセット:ラベルの大半はモデルが下書き
VI AMO は 11 のロボットデータの出典(Bridge V2、DROID、Fractal(RT-1)、TACO Play など)から集めた 6,600 エピソードで、時間的に対応づけた動作アノテーション 13,653 件とミッションアノテーション 9,702 件を含み、エピソード単位で学習 5,500、検証 550、テスト 550 に分かれています。動作アノテーションのうち DROID が 6,372 件、Bridge V2 が 4,950 件で、合わせて約 82.9% です(本サイトが論文の表 I から計算)。
アノテーションは 5 段階です。
- 動作の分解:GPT-5.6 Sol が元データセットのエピソード指示と最初のフレームの画像から、順序付きの原子動作の記述を挙げます。
- ミッションのまとめ:GPT-5.6 Sol が隣り合う動作の組を 1 つずつ判定し、共通の目標へ明確に続く場合は同じミッションにまとめ、そうでなければ境界を残します。まとめられなかった動作は単独でミッションになります。
- 粗い位置決め:Qwen3.7-Plus がまばらに抜き出したフレームから各動作のおおよその時間窓を推定します。
- 境界の精緻化:粗い境界の前後の連続フレームを取り、グリッパーの開閉イベントがあればそれも参照して、Qwen3.7-Plus が動作の完了フレームを判定します。
- 人手による確認:確認者が全エピソードの約 50% で動作の記述、ミッションのまとめ方、時間境界を確認・修正します。
VIM は Qwen3.5-27B をベースに、視覚と言語の両方のアテンションと MLP モジュールに LoRA(ランク 16、α 16)をかけたものです。更新するのは低ランクのパラメータだけで、損失は OA と OM の 2 つのテキストだけで計算します。学習セットの動作は 11,481 件で、カメラごとに 4 フレーム、動作ごとに 6 通りの時間サンプリングを作り、学習サンプルは 68,886 件になります。BF16 で 1 エポック学習し、A100 80GB 1 基で約 13.44 GPU 時間です。
テストセットの結果:同じベースモデルで、ファインチューニングの前後を比べる
テストセットの 550 エピソードは学習セットと重ならず、動作 1,091 件、ミッション 781 件を含みます。各動作は 9 つの進捗点(動作時間の 0% から 95%)で評価し、そのつど動作の開始時点からその時点まで 4 フレームを等間隔に取ります。指標は 4 つです。単語単位の F1、SBERT(all-mpnet-base-v2 の文埋め込みのコサイン類似度)、SigLIP テキストエンコーダのコサイン類似度、そして Top-10 です。Top-10 は、テストセットの重複のないラベル全体(動作ラベル 726 件、ミッションラベル 539 件)を予測との SigLIP 類似度で並べ、正解ラベルが上位 10 件に入る割合です。下の表は論文の表 II から取ったもので、9 つの進捗点の平均です。
| モデル | 動作 SBERT | ミッション SBERT | ミッション Top-10(%) |
|---|---|---|---|
| GPT-5.6 Luna | 0.581 | 0.554 | 39.33 |
| GPT-4o | 0.563 | 0.470 | 29.91 |
| Qwen Base (27B)、追加学習なし | 0.581 | 0.564 | 37.27 |
| Qwen Base (9B) | 0.529 | 0.496 | 28.32 |
| RynnBrain 1.1-9B | 0.505 | 0.499 | 35.49 |
| RoboBrain 2.5-8B | 0.316 | 0.315 | 19.29 |
| VIM | 0.825 | 0.821 | 78.77 |
ベースラインはどれも VI AMO で学習していません。いちばん直接的な比較は同じベースモデルどうしです。追加学習なしの Qwen3.5-27B はミッション SBERT 0.564、Top-10 37.27% で、ファインチューニング後の VIM は 0.821 と 78.77% です。動作の Top-10 も最良のベースラインの 39.14% から 76.59% に上がっています。ロボット向けに事後学習した RynnBrain と RoboBrain は汎用 VLM を上回っておらず、著者はこれを、動きから操作者の意図を推定することが別個の課題である兆候と見ています。本記事の図には GPT-4o、追加学習なしの Qwen3.5-27B、GPT-5.6 Luna、VIM の 4 本だけを描き、表の残り 3 つのベースラインは省いています。
進捗ごとに見ると、VIM の動作とミッションの SBERT は 0% の 0.776/0.776 から 95% の 0.855/0.849 に上がり、70% 以降は伸びが小さくなります。0% の時点(動作の開始時点しか見ていない)でもすでに 0.776/0.776 です。アブレーションでは、手首カメラを外すと 0.798/0.798、テキストのコンテキストを外すと 0.767/0.788、4 フレームの履歴を 0% 時点の 1 フレームに置き換えると 0.793/0.792 に下がります。
著者は 1,091 件のテスト動作を、ラベルが学習中に出てきたかどうかでも分けています。両方のラベルが既出なのが 621 件、両方とも未出なのが 386 件(35.4%)、残り 84 件は片方だけ未出です。既出の部分では VIM が 0.902/0.903、最も強いベースラインが 0.587/0.566 で、未出の部分では VIM が 0.726/0.717 に下がり、ベースラインは最高で 0.570/0.564 です。ここでの「未出」は正規化したラベル文字列で判定しているので、既出ラベルを言い換えた記述も未出に数えられます。まったく新しい動作やミッションという意味ではありません(本サイトの推論)。
実機での引き継ぎ:VIM がミッションを示し、操作者が確認し、π0.5 が続ける
実機は平行グリッパー付きの Franka アームで、前方と手首に OAK-D カメラを 1 台ずつ置き、操作者は Rokoko Smartglove で遠隔操作します。手の相対的な動きでエンドエフェクタを動かし、親指と人差し指のつまむ距離でグリッパーを開閉します。引き継ぎの流れは次のとおりです。
- VIM が直近の人による操作再開以降の履歴を読み、同期した前方・手首の画像の組を等間隔に 4 組取り出して、進行中の動作とミッションを予測します。
- 操作者が予測されたミッションを確認し、自分の目標と合っていれば承認して、制御を VLA に渡します。
- ファインチューニングした π0.5 が予測ミッションを指示として、公称 15 Hz で動作を出し、操作の続きを行います。
- 操作者はいつでも操作を取り戻せます。グローブの対応づけを合わせ直すと、ロボットは再び操作者に従います。その後の引き継ぎも同じ手順を繰り返します。
VIM は RTX 5090 上で TensorRT-Edge-LLM により動かし、NVFP4 に量子化しています。論文は、利用できるメモリに収めるためと書いています。ここで量子化が減らしているのはメモリで、フィジカルAIラボ 2.6 で容量と時間を分けて数えた話と並べて読めます。π0.5 は新たに集めたデモでファインチューニングしており、すべての果物を置くタスクが 130 件、ほかは各 100 件で、A100 80GB 4 基で 10,000 ステップ一緒に学習しています。
5 つの実験は 4 つの系統に分かれ、それぞれ別の意図の手がかりを試します。リンゴを置くタスクとバナナを置くタスクは同じ場面で対象の果物だけが違います。卵を置くタスクには物体と容器の常識的な対応(卵は卵トレーへ)が必要です。ゴミ掃きでは、ロボットが手を伸ばす道具から目標を読み取る必要があります。すべての果物を置くタスクでは推定と継続を何度も繰り返す必要があります。どの場面も VIM のファインチューニングデータには含まれていません。比較条件は、意図モジュールに GPT-4o または GPT-5.6 Luna を使う場合と、すべて遠隔操作する場合で、各実験は条件ごとに 5 回です。
著者の報告では、VIM はどの実験でも 2 つの GPT 構成より人の遠隔操作時間が短く、平均で GPT-4o より 34.6%、GPT-5.6 Luna より 39.8% 短くなりました。ゴミ掃きでは 2 つの GPT モデルがどちらも使える意図を出せず、この実験は最後まで遠隔操作になりました。1 回の予測の平均遅延は、VIM が実験ごとに 0.70–0.81 s、GPT-4o が 3.09–3.53 s、GPT-5.6 Luna が 1.92–2.27 s で、それぞれ 76.9% と 63.8% の短縮です(要旨では平均約 70% とまとめています)。著者は、多くの操作動作は数秒で終わるため、2 秒を超える遅延があると推定した意図がロボットの実際の状態より遅れてしまうと説明しています。
この結果を読むときは 3 点に注意が必要です。第 1 に、3 つの条件はどれも同じ VLA を使っており、比べているのは意図モジュールだけです。第 2 に、本文が数値で示すのは 2 つの GPT ベースラインに対する割合だけで、すべて遠隔操作する場合と比べた短縮や絶対時間は図 5 に描かれているだけで、読んだ本文には数値がありません。2 つの GPT ベースラインはゴミ掃きで全遠隔操作に戻っているので、この実験が平均の差を広げている可能性があります(本サイトの推論)。第 3 に、VIM はローカル GPU 上の量子化モデルで、GPT ベースラインは API 呼び出しなので、遅延の差にはモデルそのものだけでなく展開方法の違いも含まれます(本サイトの推論)。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者報告 [R] であり、独立した再現はありません。テストセットの結果には区間、標準偏差、複数シードの結果がありません。実機の部分は各実験・各条件 5 回だけで、平均と標準偏差は図 5 にしかなく、読んだ本文には数値がありません。
- 評価に使う正解は GPT-5.6 Sol が下書きし、Qwen3.7-Plus が時間位置を決めたもので、人が確認したのはエピソードの約 50% だけです。VIM はこのラベルでファインチューニングされてその言い回しを学んでいますが、追加学習なしのベースラインは学んでいないので、テキスト類似度系の指標は VIM に有利に働く可能性があります(本サイトの推論で、論文は論じていません)。
- テストのエピソードは学習のエピソードと重なりませんが、同じ出典群(11 のうち 10。HYDRA にはテストエピソードがありません)から来ています。実機の場面は VIM のファインチューニングデータに含まれていませんが、π0.5 はそれらの実験タスク向けに各 100–130 件のデモで専用にファインチューニングされています。
- 著者が挙げる制約:モデルはまだ予測を誤り、較正された信頼度も持たないため、いつ予測を信頼できるかは未解決です。データセットでの評価は動作の境界が既知であることを前提としており、実際の遠隔操作中のオンラインな境界検出は評価していません。VLA の実行は熟練した操作者より遅いので、手動操作の時間が減ってもタスクの完了が早くなるとは限りません。
- 引き継ぎの前に操作者が予測ミッションを確認する手順は論文の流れの一部です。誤った予測を操作者が却下した回数は報告されておらず、実機実験は安全性の検証でもありません。
- 論文は、データセット、アノテーションの流れ、VIM の重みをプロジェクトページで「公開する予定」としています。本サイトはそのページを開いておらず、公開済みかどうかも確かめていません。
リンク
- I See What You Want: Decoding Hierarchical Operator Intent from Visual Teleoperation History(arXiv 2611.16419)
- 論文の HTML 全文
- フィジカルAIラボ 2.3:SmolVLA をファインチューニングする――指示に合わせてお手本を計画し、各数字が何を測ったかを確かめ、非同期の動作キューの時間を計算する
- フィジカルAIラボ 2.6:エッジへ――遅延のログから制御周波数の上限を求め、量子化で減るのが容量か時間かを見分け、動作チャンクの長さを決める
- フィジカルAIラボ 3.4:長期タスク――ステップごとの成功率とチェーン全体の成功率を手で計算し、進み具合の記憶が変える量を確かめ、上位層だけを入れ替えたルーティングのアブレーションを審査する
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座


