大規模マルチモーダルモデルをロボットのエージェントに使うと、画面を読み、タスクをサブタスクに分け、失敗後の立て直しを考えさせられます。ただし毎ステップ問い合わせると、トークンと待ち時間が積み上がります。プレプリント RoC(Reasoning on Call、arXiv 2611.26341、2026-11-19、武漢大学、中関村学院、Samsung などの機関)は、学習したタスク状態監視器に推論エージェントのレビューが必要な時点を判断させ、それ以外は低レベル方策にそのまま実行させます。以下の数値はすべて著者報告 [R] で、本サイトでは再現していません。
本サイトの フィジカルAIラボ 3.4 では、長期タスクにおけるステップごとの成功率とチェーン全体の成功率の違い、そしてオーケストレーターが進み具合の記録で完了済みのステップを覚えておく方法を扱いました。RoC は「進み具合」をオンラインで推定する量にし、それを使って上位層が介入する時点を決めます。これまでのレーダー記事では、GPT-6 Astra にロボットアームを直接制御させる研究(GPT-GEAR)と、一部の家事タスクを丸ごとエージェントに任せる研究(One Policy for 100 Household Tasks)を取り上げました。RoC が扱うのは、1 つのエピソードの中でエージェントがどの時点に出てくるべきかです。
3 つの構成要素と 1 つのループ
RoC は低レベル方策、オンラインのタスク状態監視器、推論エージェントで構成されます。実験では方策を事前学習済みの FastWAM で初期化し、50 ステップの拡散デノイズで 32 ステップのアクションチャンクを予測します。入力は現在のサブタスク指示、ロボットの状態、3 枚の画像(初期フレーム、現在のサブタスク中の直近フレーム、現在のフレーム)です。監視器は汎用ロボット報酬モデル Robometer から初期化します。エージェントは GPT-6.1 Sol(xhigh)です。
エピソードの開始時、監視器はタスク指示と初期観測から最初のサブタスクを提案し、エージェントが確認してから方策が動き始めます。その後は各ステップで方策がアクションチャンクを提案し、RoC はまずレビューの発火条件を確認します。発火しなければチャンクの先頭部分(論文では実行プレフィックスと呼びます)を実行して新しい観測を取り、発火すれば該当する動作を保留してエージェントに渡します。エージェント呼び出しの合間も、監視器は問い合わせを続け、方策は実行を続けます。
監視器が出力するもの
- 進捗
p_t:現在のサブタスクがどこまで進んだか。進捗ヘッドは [0, 1] 内の 10 個の離散値上の分布を出し、その期待値をスカラーの推定値にします。 - 切替要求確率
s_t:同じ隠れ状態の上の別のヘッドが直接予測します。 - 後続サブタスクの候補またはタスク終了:自己回帰の言語生成ブランチが出し、
s_tがしきい値を超えたときだけ生成します。
監視器の入力は、タスク指示、現在のサブタスク、実行順に記録したインタラクション記憶、選んだ過去のフレームです。フレームは段階に応じてサンプリングします。エピソード開始から現在のサブタスク開始までは疎に一様サンプリングしてシーンの参照にし、現在のサブタスク内は密にサンプリングして局所的な変化を捉えます。記憶の各レコードはサブタスク指示、実行した動作、結果の説明、対応する観測のタイムスタンプを持ち、エージェントが検証したものだけが書き込まれます。サブタスクの切替は時間的にまばらなので、著者は学習時に注釈付きのサブタスク境界付近のサンプリング間隔を半分にし、切替前後の状態を監視器が多く見るようにしています。監視器は RMBench の 9 タスクすべてで 1 エポック学習します。著者の測定では、監視器はサブタスクを生成しないとき 7.10 Hz、生成するとき 0.53 Hz、全体のスループットは 2.77 Hz です。
3 種類の発火条件と 5 種類の修正
エージェントのレビューを発火させるイベントは 3 種類です。
- 切替イベント:
s_tが要求しきい値を超えたとき。後続の候補は提案にすぎず、それだけでは切替は成立しません。 - 進捗イベント:同じサブタスク内で
p_tが大きく下がる、振動を繰り返す、または停滞するとき。実装では進捗をメディアンフィルタで平滑化し、64 ステップの振り返り窓で判定します。低下のしきい値は 0.2 です。進捗の範囲が 0.25 を超え、意味のある変化の向きが 3 回を超えて反転すれば振動、範囲が 0.1 以内に収まれば停滞とします。 - 重要接触イベント:アクションチャンク内でグリッパーを閉じる前、または置いて放す前に、物体の同一性、相対的な幾何関係、インタラクションの前提条件を確認します。
エージェントは同じタスクと実行の文脈を読み、実行の修復、計画の修正、またはその両方が必要かを判断します。実行の修復には 3 つのモードがあります。実行プレフィックスの短縮(エージェントは 1–32 ステップを承認できます)、エンドエフェクタの姿勢やグリッパー指令の局所的な修正(1–5 ステップ)、結果が検証されるまでのサブタスクの引き継ぎです。計画の修正は 2 つで、切替を却下して未完了のサブタスクを続けるか、不適切な後続候補を置き換えます。どちらも不要なら、エージェントは方策の続行を承認します。サブタスクの完了はエージェントが検証して結果の説明を書き、後続が承認されてはじめて記録がインタラクション記憶に入り、切替が確定します。引き継ぎ中は方策の指令を止め、終了後に RoC は古くなった動作を捨て、新しい観測からアクションチャンクを作り直します。
RMBench:成功率とトークン
RMBench は記憶に依存する操作のベンチマークで、9 タスクが 2 種類に分かれます。M(1) は過去の重要な観測を 1 つ覚えておく必要があり(例:物体の初期位置)、M(n) は過去の複数のインタラクションを追跡する必要があります(例:以前の試行や完了した操作)。エージェント方式との比較は各タスク 30 回の独立試行です。比較対象の Direct Control と GPT-as-Policy のハイブリッドモードは元の設定のまま GPT-6 Astra(xhigh)を使います。論文の表 1 にある 9 タスク平均は次のとおりです。
| 手法 | 平均成功率(%) | 1 エピソードあたり平均トークン(× 10⁴) |
|---|---|---|
| Direct Control | 71.9 | 1845.1 |
| GPT-as-Policy | 75.6 | 830.3 |
| RoC | 99.6 | 288.3 |
これによると、RoC は GPT-as-Policy より 24.0 ポイント高くトークンは 65.3% 少なく、Direct Control より 27.7 ポイント高くトークンは 84.4% 少なくなります。トークンの削減幅はタスクごとに大きく異なります。Cover Blocks では RoC が 131.1、GPT-as-Policy が 2123.9 ですが、Observe and Pick Up ではそれぞれ 391.0 と 409.0 で、ほとんど減っていません。図 4 の例のエピソードでは、エージェント呼び出しは RoC が 46 回、GPT-as-Policy が 84 回、Direct Control が 209 回です。
各タスク 30 回として計算すると(本サイトの計算)、各手法の試行は合計 270 回で、75.6% と 99.6% はおよそ 204 回と 269 回の成功に当たります。本サイトが正規近似で見積もった差の 95% 区間の半幅は約 5.2 ポイントで、24.0 ポイントの差はその外にあります。ただしこの比較ではエージェントのモデルも替わっており(GPT-6 Astra と GPT-6.1 Sol)、論文本文には両側で同じモデルを使った比較がないため、本サイトは差のすべてを発火の仕組みによるものとは判断できません。
方策ベースの手法との比較は各タスク 100 回の試行です(表 2)。RoC の平均は 98.1%、最も強い方策ベースラインの MemoryWAM は 83.0% で、差は 15.1 ポイントです。FastWAM 単体は 5.9%、π0.5 は 10.4% です。Blocks Ranking Try では MemoryWAM が 100.0%、RoC が 98.0% です。表 2 にはトークンの列がなく、方策ベースラインはエージェントを呼ばないので、この比較は同じ計算コストの下での比較ではありません。同じ RoC でも表 1 と表 2 で平均が異なり(99.6% と 98.1%)、2 つの表は試行回数も異なります(30 回と 100 回)。
アブレーションと実機
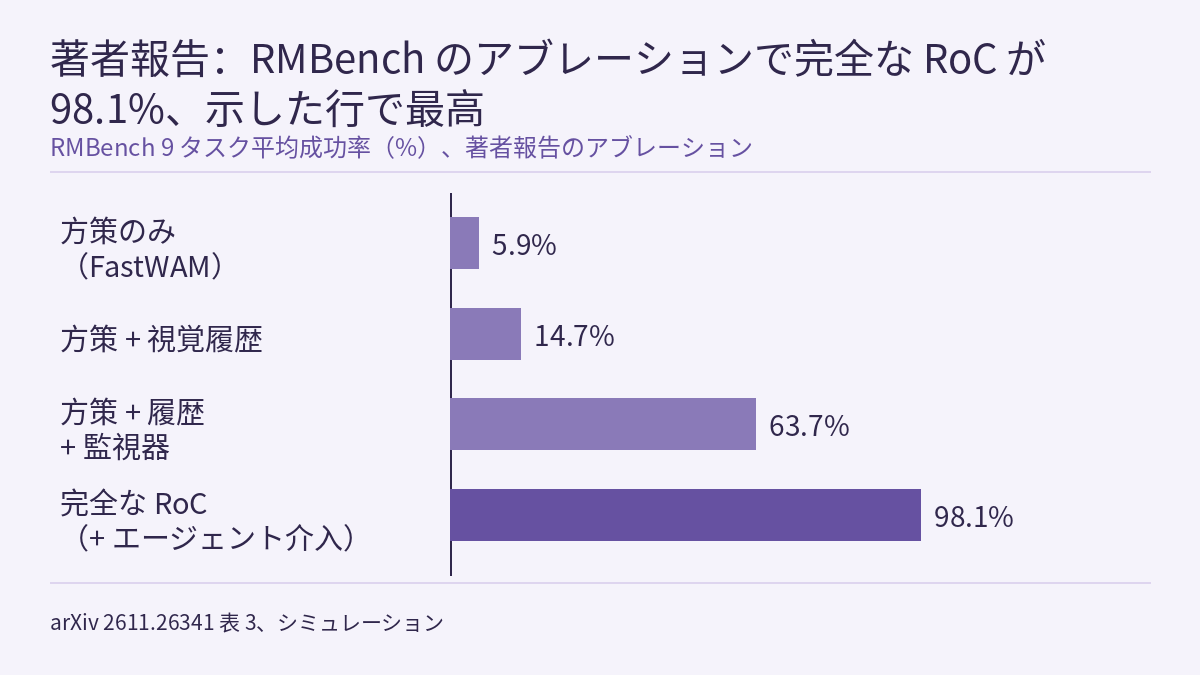
論文の表 3 は構成要素を 1 つずつ加えています。FastWAM 単体は 5.9%、視覚履歴を加えると 14.7%、さらに監視器を加えて予測したサブタスク指示に従って実行すると 63.7%、さらにイベント駆動のエージェント介入を加えた完全な RoC は 98.1% です。監視器だけのとき M(n) タスクの平均は 51.0% で、エージェントを加えると 97.3% になります。著者の解釈では、監視器がタスク状態の推定と切替の提案を出し、エージェントが実行結果を検証して、必要なときに実行の修復と計画の修正を一緒に行います。このアブレーションは 1 層ずつ加えているので、3.4 で扱った「1 層だけ入れ替えてチェーン全体の成功率の変化を見る」対照と同じ読み方ができます。本文にはこのアブレーションの試行回数も区間も書かれていません。
実機実験は 5 自由度の SO-ARM101 に固定の外部 RGB カメラと手首の RGB カメラを付け、3 タスクを各 10 回行います。Drawer Sorting(色と引き出しの段の対応を見てから引き出しを閉じ、ランダムに渡されたブロックを対応する段に入れる)、Cover and Reveal(3 つの色ブロックのランダムな位置を覚え、左から右へカップで覆い、赤、青、黄の順に開ける)、Tabletop Cleanup(電源アダプター、テープ 2 巻、ハンディファンをオレンジの箱に入れる)です。成功の条件は、決められた順序ですべてのサブタスクを終え、目標の最終状態に達することです。RoC は 3 タスクでそれぞれ 70%、80%、70%、全体で 73.3% で、方策+履歴+監視器は 56.7%、方策のみは 30.0% です。エージェント介入による上乗せは 3 タスクでそれぞれ 10、20、20 ポイントです。
各設定の試行は合計 30 回なので、73.3% と 56.7% は 22 回と 17 回の成功です(本サイトの換算)。本サイトが Wilson 法で見積もった 95% 区間はおよそ 56%–86% と 39%–73% で、重なっています。この 30 回だけでは 5 回の成功の差を確かめるには足りません。区間の求め方は フィジカルAIラボ 2.8 にあります。著者は残った失敗の多くを難しい把持によるものとしています。エージェントが介入しても視覚的な手がかりを有効な把持の修正に変えられず、著者はエージェントの能力が残るボトルネックだとしています。エージェント方式との実機での効率比較は付録にあり、本サイトは読んでいません。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者報告 [R] です。本サイトでは再現していません。本サイトが読んだ本文には学習シード数や信頼区間の記載がなく、コードや重みの公開についても書かれていません。
- エージェント方式との比較では、ベースラインが GPT-6 Astra(xhigh)、RoC が GPT-6.1 Sol(xhigh)を使っています。成功率とトークンの差のうちモデル自体による部分を、本文は分けていません。
- 監視器は RMBench の同じ 9 タスクで学習し、サブタスク境界の注釈を必要とします。学習していないタスクでの結果は本文にありません。本サイトが読んだ本文には、実機実験で監視器と方策を何のデータで学習したかも書かれていません。
- 論文の動機にはエージェントを待つ遅延も含まれますが、主要な表はトークンだけを報告しており、1 エピソードあたりの所要時間はありません。監視器はサブタスクを生成するとき 0.53 Hz しか出ません。
- サブタスクの引き継ぎ中はエージェントがロボットを直接制御しますが、本サイトが読んだ本文には引き継ぎ時の安全上の制約の記述がありません。シミュレーションの結果も 30 回の実機試行も、ハードウェアの安全検証ではありません。
- 本記事は arXiv の HTML 本文に基づいており、付録は読んでいません。
リンク
- Reasoning on Call: Efficient Agentic Robot Control for Long-Horizon Robot Manipulation(arXiv 2611.26341)
- 論文の HTML 全文
- フィジカルAIラボ 3.4:長期タスク――ステップごとの成功率とチェーン全体の成功率を手で計算し、進み具合の記憶が変える量を確かめ、上位層だけを入れ替えたルーティングのアブレーションを審査する
- フィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求める
- フロンティア・レーダー|GPT-GEAR:動作方策を学習せず、GPT-6 Astra が 5 つのツールでロボットアームを直接制御――深度・触覚・デモは渡すかどうかより、どう渡すか
- フロンティア・レーダー|One Policy for 100 Household Tasks:1 つの π0.5 チェックポイントで 100 の家事タスクを扱い、14 タスクは事前に練習した GPT-6 Astra に任せる――著者報告で Q 0.639 対 0.108
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)