
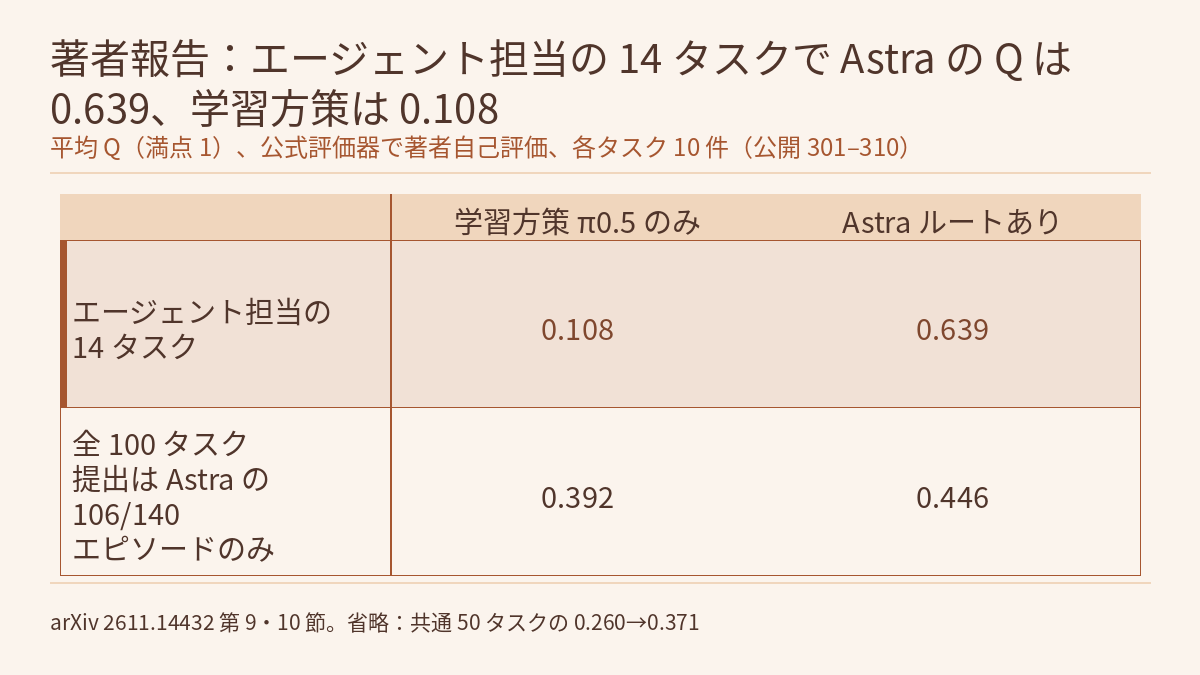
BEHAVIOR Challenge は、OmniGibson シミュレータ上でロボットが長期の家事タスクをどこまでこなせるかを評価するコンペティションで、2026 年大会ではタスク数が 50 から 100 に増えました。Ilia Larchenko ら 7 人の著者は arXiv 2611.14432(2026-11-10)で自分たちの参加方式を報告しています。π0.5 をベースにした 1 つの VLA チェックポイントで 100 タスクすべてを扱い、うち 14 タスクは訓練用インスタンスで事前に練習した GPT-6 Astra のコーディングエージェントに制御を任せます。著者によると順位は 9 位で、上位 10 チーム中で唯一の独立チームでした。このレポートは、学習済みの方策と練習する LLM エージェントを同じタスク群で並べて比べ、1 エピソードあたりの時間と費用も示しています。さらに、学習済みのマルチタスク VLA を新しいタスクへ広げる方法、1 回の測定で学習ハイパーパラメータを選ぶ方法、評価基盤の組み方も具体的に書いています。以下の数値はすべて著者報告 [R] です。主催者はこの提出を非公開テストセットで再評価しておらず、本サイトも著者のコードを実行していません。
課題とスコアの定義
2026 年の 100 の活動は、ラジオをつけることから食事を作ることまでを含みます。各活動に 200 件の遠隔操作デモがあり、合計 20,000 エピソード、211M フレーム、約 1,950 時間で、形式は LeRobot です。ロボットは Galaxea R1Pro で、全方向移動ベース、4 関節の胴体、平行グリッパー付きの 7 自由度アーム 2 本を持ち、頭部カメラ、2 台の手首カメラ、固有受容感覚で観測します。すべてのゴール述語を満たしたエピソードは完全成功で 1 点、そうでなければ q-score(本文では Q とも表記)は満たされた述語の割合です。スコアはまずインスタンスで平均し、次にタスクで平均します。エピソードの制限時間はそのタスクの人間のデモの平均時間の 1.5 倍で、2025 年は 2 倍でした。2025 年の 50 タスクは同じデモのまま残り、残りの 50 タスクは新規です。
主催者が非公開テストセットで再評価したのは上位の提出だけで、この提出は含まれていません。そのため以下のスコアは、著者が公式評価器を使って公開インスタンス 301–310 で自己評価したもので、各タスク 10 インスタンスです。
1 つのチェックポイントを 50 タスクから 100 タスクへ
2025 年、著者は 4 つのチェックポイントで 50 タスクを分担し、モデルは明らかに学習不足だったと結論づけました。締め切りの時点で損失がまだ下がっていたためです。2026 年は 1 つのチェックポイントだけを使い、2025 年のスコアへの寄与が最も大きかったチェックポイントからウォームスタートします。2026 年に追加したパラメータはすべてゼロ、単位行列、または小さな分散の正規分布で初期化し、変換後のモデルが 2025 年のモデルに近い状態から始まるようにしています。主な変更は 3 つです。
- 意味的ステージ。2025 年は各エピソードを時間で 5–15 等分し、それを「ステージ」としていました。デモのスキル注釈と照らし合わせたところ、1 つの時間ステージのフレームのうち最も多い注釈ステップに属するのは平均 50% にとどまり、1,093 の時間ステージの 57% では半分を超えるフレームを占めるステップがありませんでした。注釈から作った意味的ステージに替えると、100 タスクで合計 413 ステージ(タスクあたり 2–9)になります。
- 新タスクのウォームスタート。新タスクの埋め込みは、似た旧タスク 1–5 個の埋め込みの加重平均(類似度の順位に応じて重み 1、0.7、0.5、0.35、0.25)で、元の埋め込みの平均ノルムに合わせて再スケールします。たとえば freeze_fruit は freeze_pies など 3 つの旧タスクから始まります。ステージの埋め込みも同じ考え方で初期化します。
- 21 次元の行動空間。2025 年のモデルは 32 次元を予測し、そのうち実際の自由度は 23 次元でした。JoyLo の遠隔操作には胴体の操作量が 2 つしかなく(決まった経路に沿った移動と、第 3 関節への傾きのオフセット)、データ中の胴体指令はすべてこの形です。そこでモデルは translate と tilt を予測し、それを 4 つの関節に戻します。さらに Gemma の語彙 257,152 行のうち実際に使う 256 行だけを残し、勾配を受けない 526M 個のパラメータを削除して、チェックポイントごとに約 8 GB 小さくしました。
学習は合計 200k ステップです。まず B300 1 基でバッチサイズ 480 で 130k ステップ、続いて H200 8 基でバッチサイズ 2048 で 70k ステップを回し、学習率はバッチサイズの平方根に比例して大きくしました。モデルが見たサンプルは約 200M で、デモの 211M フレームをおよそ 1 周した量です。2025 年と共通の 50 タスクでは Q が 0.260 から 0.371 に上がり、100 タスク全体では 0.392 です。著者は、この向上を学習時間の延長だけに帰することはできないと明言しています。方策は追加の 50 タスクのデモも見ており、モデルの改良やバグ修正も入っています。2026 年は制限時間が 25% 短く、2 年間でシミュレータのバージョンも異なります(著者は意味のある差は見られなかったとしています)。
1 回の勾配ノイズ測定でフローマッチングのサンプル数を選ぶ
π0 系のモデルの学習では VLM のプレフィックスが最も重く、行動エキスパートは軽いので、観測ごとにプレフィックスを 1 回だけ計算し、行動エキスパートを K 組の(フロー時刻, ノイズ)サンプルで回します。著者はパラメータを固定したまま 1 つずつノイズ源をサンプルし直すプローブで、2025 年の設定(K = 15、独立サンプル)では勾配分散の 21% がフローのサンプル、38% がデータ拡張、42% がバッチにどの観測が入るかに由来すると測定しました。3 つのうち K を増やして小さくなるのはフローの項だけです。
著者は期待損失を変えない分散削減を 2 つ使っています。フロー時刻を Beta(1.5, 1) の分位区間で層化してサンプルし、隣り合う区間で符号が逆のノイズを 1 組共有させます。著者の報告では、層化によって同じ K でのフロー分散項が半分になり、対称ノイズでさらに 17% 減りました。
K そのものの選び方は次のとおりです。ステップ時間は T = B(c_p + c_k·K)、ノイズと時間の積は J(K) ∝ (c_p + c_k·K)(V_oa + V_f/K) で、K について最小化すると K* = √((c_p/c_k)·(V_f/V_oa)) です。著者は B300 1 基で c_p = 21.4 ms、c_k = 0.30 ms、新しいサンプラーで V_f/V_oa = 1.43 を測り、K* ≈ 10、K が 8 から 14 の範囲なら J は最適値から 1.5% 以内と求めました。本サイトで値を代入すると √(71.3 × 1.43) ≈ 10.1 となり、著者の値と一致します。2025 年の設定と比べると、K = 10 の新しいサンプラーは分散と時間の積を約 13% 下げ、著者はこれをバッチを 13% 大きくしたのと同じ効果がコストなしで得られると表現しています。必要な入力は 50 ステップの計時 2 回と分散プローブ 1 回だけです。本サイトの理解では、この見積もりは BEHAVIOR 自体には依存せず、プレフィックスを共有して行動ヘッドを複数回サンプルするフローマッチング学習なら同じように測れます。最終的な成功率への単独の効果は、著者は報告していません。
評価基盤:追跡できる記録と、合計では実時間より速いシミュレーション
100 の長いタスクの評価は高くつきます。1 エピソードの実時間は数十分に及ぶことがあり、シミュレータの起動には 6–9 分かかります。コンペティション期間中に著者は約 9,000 の評価エピソード、約 100M の環境ステップ、1,000 時間近いシミュレーション時間を回しました。各実行にはマニフェストが付き、コードのリビジョンと diff、シミュレータとパッケージのバージョン、評価とサービングの全引数、使ったチェックポイントのチェックサムを記録します。ロボットとシーン内のすべての物体の状態は開始時、30 ステップごと、終了時に保存され、新しいシミュレータに読み込んで失敗の近くから再生したり、リカバリー実験を始めたりできます。
高速化の大部分は、CPU に常に有用な仕事をさせることから来ています。シミュレータは 1 回だけ起動し、各インスタンスの前に起動時に保存したシーンを復元します。これは約 10 秒で、再起動なら 7.6 分かかります。終わった環境スロットにはすぐに次のエピソードを入れます。著者によると、公式のベクトル化評価器は最も遅いエピソードを待つことで 45–48% のステップを無駄にしています。1 つの方策サーバーがすべての環境の推論をまとめて処理します。RTX PRO 6000 1 基で 6 つのシミュレータを同時に動かすと、合計で毎秒 33 環境ステップとなり、シミュレーション時間の毎秒 30 ステップに対して実時間の 1.11 倍です。これは 6 つのシミュレータの合計です。1 つのシミュレータ単独では毎秒約 5.5 ステップなので、個々のエピソードは依然として実時間より遅く、起動やバッチの終わりのばらつきを含めると、フリート全体では GPU あたり実時間の約 0.86 倍です。100 タスクを各 10 インスタンスで回す完全な評価は、8 台のマシンで約 20 時間、約 300 ドルでした。
14 タスクを、事前に練習した GPT-6 Astra に任せる
著者は先に別の方式も試しています。学習方策が制御し、GPT-6.1 Sol がカメラ映像を監視し、方策が行き詰まったときに Astra が回数を限ってリカバリーする方式です(1 エピソードで最大 3 回、各回最大 900 動作)。介入によるものと言える改善は見つからず、この方式は提出しませんでした。
最終的な方式はタスクごとに振り分けます。各タスクにはまず練習セッションがあります。GPT-6 Astra は Pi コーディングエージェント上で、訓練用インスタンスを載せたシミュレータ(評価用インスタンスは使いません)を相手に難しい部分を列挙し、部分ごとにシーンを保存して試し、どのゴール条件が成り立つかを読み取ります。何度も失敗した部分は人間のデモ 2–3 件と見比べて動きを直します。最後に新しいリセットから、復元を使わず、公式のステップ上限内でタスク全体を通して実行し、後の自分のコピーのために手順を書き残します。リセット、保存、復元、ゴールのフィードバックは練習中にだけ使える特権的なツールです。重みは一切学習せず、学んだことは会話(タスクあたり 29–395 MB)、メモ、レシピに残ります。
評価では、各エピソードがそのタスクの凍結したセッションの新しいコピーから始まり、受け取るのは公式の観測だけです。Astra は低レベルの動作を直接出力しません。observe、xyz、act の 3 つのツールを呼ぶ短いプログラムを書き、ゴールを 1 つずつ送ります。コントローラは 30 Hz のシミュレータのステップごとに逆運動学を 1 ステップ進め、ゴールへの到達、動きの停止、ステップ上限のいずれかで結果を返します。著者によると、プロンプトの言い回しよりも、ツールの 3 回の改修のほうが重要でした。呼び出しごとに 1 つのゴールとしステップごとにループを閉じた結果、自由な動きは目標から 0.83 mm 以内に到達しました。位置を深度から求めるようにしたあとは、シミュレータの真値との最大誤差が 1.06 μm(3,598 サンプル)でした。長いベース移動で転倒しないよう、ベースの速度は 0.20 m/s に制限しています。
練習が別の状況に通用するかを確かめるため、著者は見たことのない、シーン配置の異なる訓練用インスタンスで試しました。最後の 2 日間で、メモだけを使った最初の試行は 17 回中 8 回成功しました。著者は 27 タスクを練習し、そのうち 14 タスクをエージェントに割り当てました。条件は、学習方策がそのタスクで弱く(平均 Q 0.108)、かつ著者自身のテストでエージェントのほうが良かったか、方策のスコアがほぼゼロであることです。エージェントが実行中に失敗した場合(3 回続けてクエリの制限時間を超えた、API エラー、費用または実時間の上限に達した)、そのエピソードの残りは学習方策が引き継ぎます。
著者の報告では、この 14 タスクでの Astra の平均 Q は 0.639、学習方策単独では 0.108 でした。installing_smoke_detectors では Astra が 1.0、方策が 0.10 です。費用も書かれています。エージェントの 1 エピソードの実時間の中央値は 0.63 時間で、実時間の約 17 倍、API 料金は 1 エピソードあたり数十ドルです。時間が足りず、公開結果に含まれるのは 140 のエージェントエピソードのうち 106 だけで、公開提出のスコアは Q 0.446、完全成功率 27.3% でした。0.639 をすべて算入すると、タスク平均で 100 タスクの平均は約 0.466 になります(本サイトの推算で、0.392 と 0.108 が同じ方策エピソードから得られたと仮定)。0.446 がこれより低いことは、Astra のエピソードの一部しか含めていないという説明と整合します。
本サイトで紹介した GPT-GEAR は、GPT-6 Astra がツールだけでロボットアームを直接制御する別のプレプリントです。このレポートが加えるのは、長期の家事ベンチマークで学習済みの VLA とタスクごとに比べた結果と、1 エピソードあたりの時間と費用です。エージェントがロボットを直接制御するときのリスク審査については LEASH を参照してください。フィジカルAIラボ 3.4 では複数方策のルーティングと、上位層だけを入れ替えたルーティングのアブレーションを扱いました。ここでのルーティングは評価前にタスクごとに固定した表で、タスクは著者自身の試行から選ばれています。そのため 0.639 対 0.108 はこの選ばれた 14 タスクについてだけの結果で、エージェントがすべてのタスクで方策より優れているとまでは言えません。
2025 年と比べて、どの失敗が減ったか
両年とも人手で確認した 10 タスクでは、完全成功率が 2025 年の提出の 20% から 2026 年の学習方策の 36% に上がりました。著者が人手で付けた失敗理由(1 エピソードに複数の理由がある場合は均等に配分)では、順序の誤りが 13.0 から 6.7 エピソードに、転倒が 7.2 から 4.5 に、行き詰まりが 2.8 から 0 に減り、器用さに関わる失敗は減っていません(29.8 対 32.2)。著者は 2025 年の失敗を見直し、順序の誤りのかなりの部分を、タスク完了後のデモの待機部分にたどりました。2025 年の学習ではこれらのフレームも使っていましたが、公式評価は成功した時点で終わるため、2026 年のデータローダーは完了時点でデモを切ります。著者は、注釈とよりよく揃った意味的ステージも順序の誤りを減らした可能性があるとしています。21 次元の行動空間に切り替えると、方策はデモに現れない胴体の姿勢を出せなくなり、著者は深くしゃがむときに転倒しにくくなったことを観察しました。転倒の件数が減ったことはこの観察と整合するとし、同じ変更で行き詰まりが減ったことも説明できる可能性があるとしています。著者は、難しい操作のステップまで進むエピソードが増えたことで、器用さの限界がより目立つようになったと説明しています。論文はこれらの要因をアブレーションで個別に検証していません。こうした失敗ラベルの読み方は フィジカルAIラボ 1.8 と照らし合わせてください。
悪化したタスクもあります。cook_bacon は 0.757 から 0 に下がりました。著者は、2026 年の公開評価で 7/10 のインスタンスがベーコンのトレイを冷蔵庫の下段に置いており、199 件の訓練デモすべてでの高さより約 41 cm 低かったことを見つけ、これが原因の一つである可能性を挙げていますが、残りの 3 インスタンスもスコアはゼロでした。2 種類のリカバリーデータは単一タスクでわずかな効果にとどまりました。スクリプトによるリカバリーで turning_on_radio の成功率は約 50% から 60–75% に上がり、人による修正では 1 タスクの Q が 0.267 から 0.367 に上がりましたが、片側の対応のある並べ替え検定で p = 0.131 で、有意ではありません。著者はどちらも 100 タスクに広げることはできませんでした。
制約と注意点
- これは arXiv 上のコンペティション参加レポートで、数値はすべて著者報告 [R] です。主催者はこの提出を非公開テストセットで再評価しておらず、スコアは著者が公開インスタンス 301–310 で自己評価したものです。「9 位、上位 10 チーム中で唯一の独立チーム」は著者の記述で、本サイトはリーダーボードを確認していません。
- エージェントが担当する 14 タスクは、著者自身の試行をもとに学習方策が弱いタスクとして選ばれたもので、一部は練習で完全な成功を得ないまま割り当てられています。0.639 と 0.108 の区間は示されていません。
- 共通 50 タスクでの 0.260→0.371 には、長い学習、より多くのタスクのデータ、モデルの変更、バグ修正が混ざっており、制限時間とシミュレータのバージョンも異なるため、1 つの変更に帰することはできません。レジスタ、スクラッチトークン、アテンションシンクは、事前学習済みの SigLIP で行き場を誤ったアテンションに専用の受け皿を与えるために著者がモデルに加えた専用トークンと層ごとの学習可能なシンクで、主な目的はアテンションマップを読めるようにしてデバッグに使うことでした(論文第 4 節)。これらの変更はアブレーションをしておらず、著者はデバッグが楽になる以外に成功率を上げる証拠はないとしています。
- 結果はすべて OmniGibson のシミュレーションによるものです。Astra のエピソードは実時間の約 17 倍かかり、1 エピソードあたり数十ドルで、Astra が考えている間シミュレーションは待機します。いずれも実機での検証やハードウェアの安全性の検証ではありません。
- 論文にはコード、チェックポイント、プロジェクトページのアドレスが載っていますが、本サイトは開いておらず、実行もしていません。
リンク
- One Policy for 100 Household Tasks: Our Solution for the 2026 BEHAVIOR Challenge(arXiv 2611.14432)
- 論文 HTML 全文
- フィジカルAIラボ 3.4:長期タスク――ステップごとの成功率とチェーン全体の成功率を手で計算し、進み具合の記憶が変える量を確かめ、上位層だけを入れ替えたルーティングのアブレーションを審査する
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フロンティア・レーダー|GPT-GEAR:動作方策を学習せず、GPT-6 Astra が 5 つのツールでロボットアームを直接制御――深度・触覚・デモは渡すかどうかより、どう渡すか
- フロンティア・レーダー|LEASH:基盤モデルがロボットアームを直接制御するとき、各ラウンドの計画前・各動作の前・グリッパー開放や注ぐ前に審査する――著者は RoboRisk の 5 つのリスク区分で検証
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座


