
世界行動モデル(World-Action Model、WAM)は、ロボットの動作を生成しながら未来のフレームも予測します。未来の動画は一段ずつデノイズするため、推論の負荷が大きくなります。既存の高速化手法の多くは、現在のタスクや実行状態にかかわらず、未来の精緻化に固定の予算を割り当てます。シンガポール国立大学、RoboScience などに所属する Haitian Li らはプレプリント Elastic-WAM(arXiv 2611.14257、2026-11-10)で、学習した「精緻化需要場」に状態ごとに三つを決めさせています。未来動画の精緻化をいつ止めるか、次のデノイズでノイズをどれだけ下げるか、どの未来動画トークンを更新するかです。基盤の WAM は最後まで凍結したままです。著者の報告では、RoboCasa-GR1 の平均成功率は 57.4%、推論遅延は 388.2 ms で、同じ基盤を使う Joint-WAM(572.6 ms)より 32.2% 低くなっています。以下の数字はすべて著者報告 [R] で、本サイトは著者のコードを実行していません。
手法:一つの精緻化需要場で三つを決める
著者はまず LIBERO-Plus から 10 タスクを選んで観察しました。成功率が最も高くなるデノイズのステップ数はタスクによって 1 から 4 まで異なり、同じタスクの中でも状態によって好ましい精緻化の深さが違いました。動作から動画への注意マップでも、動作生成が未来フレームの各領域に向ける注意は均一ではありませんでした。論文はここから、精緻化の計算をデノイズの時間方向と未来動画の空間方向の両方で必要に応じて配分すべきだと主張します。
具体的には、196 個の未来動画トークンを、時間とカメラ視点の境界を保つ 64 のグループに分けます。各グループのトークン数は 1、2、4 のいずれかです。各グループには、正規化したデノイズ進行度 z ∈ [0, 1] に沿った「残りの需要」の曲線があり、振幅と Beta 密度の積で表します。基盤 WAM ではすべての未来トークンが同じデノイズ軌道をたどるため、著者はグループ間で一つの時間基底 B0 を共有し、振幅だけをグループごとに変えています。各グループの振幅は sigmoid(b0 + Δu_g) で、b0 は全体のオフセット、Δu_g はトークン数で重み付けした平均を差し引いた相対スコアです。全グループの振幅をトークン数で重み付け平均すると、残りの需要の合計 D(s) になります。こう分けることで、全体オフセットは「あとどれだけ精緻化するか」だけを、相対スコアは「どこを先に精緻化するか」だけを担います。三つの判断はこの場から読み出します。
- いつ止めるか(WHEN):各ステップの D を精緻化を続ける条件付き確率とみなし、累積の「World Commit」確率を、1 から各ステップの D の積を引いた値として求めます。累積確率が 0.5 に達すると、未来動画の精緻化を止めます。
- どこまで進むか(HOW FAR):共有時間基底の最頻値 z_k を取り、次のノイズ削減幅を δmin + z_k(δmax − δmin) とします。δmin = 0.05、δmax = min(0.20, σ_k − σ_floor) です。
- どこを更新するか(WHERE):ちょうど K0 トークンの予算の下で、相対スコアの高いグループを選びます。既定では疎な更新 1 回につき K0 = 96 トークンを更新します。予算は外部から与え、学習したスコアはどの領域を選ぶかだけを決めます。
学習と推論:WAM は凍結し、この場だけを学習する
基盤は FastWAM-Joint です。論文によれば、これは Faster-WAM の論文で Joint-WAM と呼ばれているモデルと同じなので、比較表の Joint-WAM はこの仕組みを持たない同じ基盤にあたります。学習は 3 段階で、各段階でパラメータの一部だけを学習し、残りは凍結します。
- 時間方向の形:同じ再帰状態から、「すぐに確定する」場合と、いくつかのデノイズ幅で「もう 1 ステップ進む」場合を比べます。どの候補も動作のデノイズを最後まで行い、終端の動作誤差 E = 0.6 E_seq + 0.4 E_Δ(動作系列の誤差と、隣り合う動作の差の誤差)で採点します。誤差の小さい候補ほどソフトターゲットで高い確率を与え、B0 を教師付けします。同じ比較から、いつ止めるかを判断する時間方向の教師モデルも学習します。
- 空間方向の優先度:同じデノイズ状態で、勾配を流さない密な更新を教師、微分可能な疎な更新を生徒とします。離散的な定数予算マスクの勾配は straight-through 近似で求めます。勾配は凍結した WAM の計算を通り、空間スコアだけを更新します。
- 全体の需要:時間方向の教師の停止予測から各ステップの目標継続確率をつくり、目標の全体オフセット b0 に換算します。学習は完全な再帰プレフィックス上で行い、累積停止確率と確定のタイミングを制約します。
推論では、再計画のたびにまず全未来トークンに対して密な結合デノイズを 1 回行い、再帰状態と層ごとの key–value キャッシュをつくります。その後の各ステップでは、観測と動作のクエリは密なままで、選ばれた未来動画クエリだけを再計算します。このとき、完全な論理的 key–value コンテキストは参照できます。選ばれなかったトークンは、キャッシュした隠れ状態、key、value、前回更新時の速度をそのまま使います。累積確定確率がしきい値に達するか、論文のいう「安全条件」が発動すると、未来動画の精緻化を止め、現在の動画表現とキャッシュをそのまま使って動作のデノイズを続けます。動画のプリフィルをやり直す必要はありません。読んだ本文には、この安全条件の中身は書かれていません。
シミュレーションの結果と遅延
四つのシミュレーション・ベンチマークは、LIBERO(4 スイート、タスクごとに 50 回のロールアウト、計 2,000 エピソード)、LIBERO-Plus(7 種類の摂動)、LIBERO-Pro(4 種類の汎化の変化)、RoboCasa-GR1(24 タスク、StarVLA の評価設定に準拠)です。LIBERO-Plus と LIBERO-Pro では、LIBERO で学習した方策を追加の適応なしで評価しています。平均成功率(%)は次のとおりです。
- LIBERO:Elastic-WAM 98.8、Joint-WAM 98.5、LingBot-VA 98.5、π0.5 96.9。著者は Long スイートで Joint-WAM を上回った点を強調しています(98.2 対 96.8)が、このスイートでは LingBot-VA が 98.5 です。
- LIBERO-Pro:Elastic-WAM 54.1、π0.5 53.4、Joint-WAM 52.8。四つの区分のうち Position はどの手法でも低く、Elastic-WAM は 8.4、π0.5 は 20.8 です。
- LIBERO-Plus:Elastic-WAM 73.7、OpenVLA-OFT 69.6、LingBot-VA 69.5、Joint-WAM 66.3、Fast-WAM 49.1。
論文の本文は、Elastic-WAM が LIBERO-Plus のすべての摂動区分でより頑健だと述べています。論文自身の表 3 で見ると、これは Joint-WAM に対しては成り立ち、7 区分すべてで上回っています。他のベースラインに対しては成り立ちません。4 区分では少なくとも一つのベースラインが上回っています。カメラ視点は π0-Fast 65.1、OpenVLA-OFT 56.4 に対して Elastic-WAM 52.1、ロボットの初期状態は LingBot-VA 83.0 に対して 76.3、背景は OpenVLA-OFT 93.3、π0 81.4、UniVLA 81.0、π0-Fast 73.2 に対して 60.0、センサーノイズは π0 79.0、OpenVLA-OFT 75.8、π0-Fast 74.4、LingBot-VA 64.4 に対して 61.1 です。論文が「particularly notable gains」(特に顕著な向上)として挙げるカメラ視点、ロボットの初期状態、センサーノイズの 3 区分は、いずれもこの 4 区分に含まれます。要旨の「state-of-the-art」も、序論では「大規模な身体性事前学習を使わない手法の中で」と限定されています。
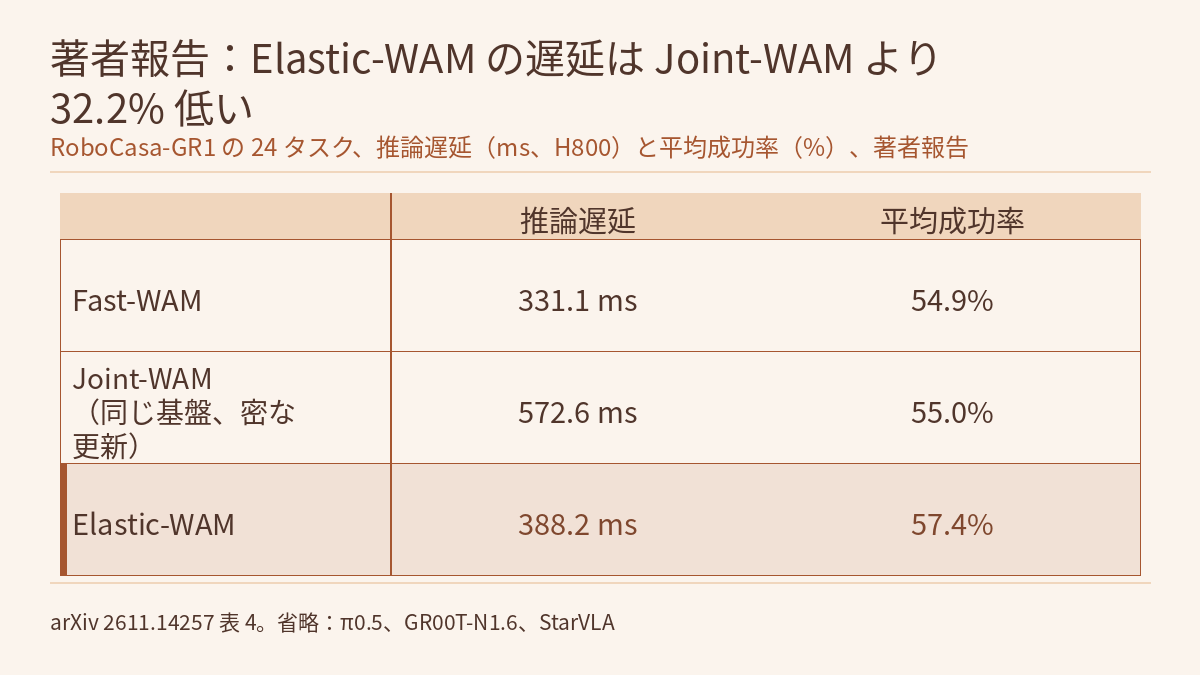
遅延は RoboCasa-GR1 でのみ、ms 単位で、NVIDIA H800 GPU 1 基で測定されています。論文の表 4 のうち WAM の 3 行は次のとおりです。
| 手法 | 推論遅延(ms) | 平均成功率(%) |
|---|---|---|
| Fast-WAM | 331.1 | 54.9 |
| Joint-WAM | 572.6 | 55.0 |
| Elastic-WAM | 388.2 | 57.4 |
32.2% は Joint-WAM に対する削減率で、(572.6 − 388.2)/ 572.6 です。Fast-WAM は推論時に明示的な未来動画生成を省く手法で、遅延は Elastic-WAM より 57.1 ms 短く、成功率は 2.5 ポイント低くなっています。同じ表にある三つの VLA ベースライン、π0.5、GR00T-N1.6、StarVLA の遅延は 77.0–82.0 ms、成功率は 37.0–48.8% で、Elastic-WAM の遅延はその約 4.7–5.0 倍です(表の数字から本サイトが計算)。読んだ本文には、1 回の遅延測定が何を含むか(たとえば 1 回の再計画にあたるか)の説明がなく、動作チャンクの長さや制御周波数も示されていません。
アブレーションと実機試験
アブレーションはすべて凍結した基盤で行われています。各セルは一つの成功率で、論文には実行回数やシード数の記載がありません。
- 空間方向の選択(RoboCasa-GR1、表 5):学習した選択で 1 ステップ 96 トークンが 57.42%、同じ予算でのランダム選択が 53.83%、全トークン有効で K = 128 が 55.17%、FirstKV(Faster-WAM と同じく初期の動画キャッシュを再利用し、それ以上精緻化しない方式)が 54.50% です。
- 時間方向の制御(LIBERO-Plus、表 6a、空間選択と予算は固定):空間選択のみが 71.71%、適応的な確定を加えステップ幅は固定が 72.31%、確定とステップ幅の両方を適応させると 73.71% です。
- 更新予算(LIBERO-Plus、表 6b):K = 49 が 72.84%、K = 96 が 73.71%、K = 147 が 71.71%、K = 196(196 個の未来トークンすべて)が 70.92% です。著者は、更新する未来トークンを増やしても下流の制御が良くなるとは限らないと結論づけています。
実機試験は UFACTORY xArm 7 を 2 台使った双腕プラットフォームで、4 段階のお茶の準備タスクを行います。白いカップを蓋のないティーポットの上に置き、蓋つきのティーポットから白いカップにお茶を注ぎ、白いカップを元の位置に戻し、最後に蓋のないティーポットから黒いカップにお茶を注いでティーポットを戻します。著者は 200 本のデモを収集し、三つの条件でそれぞれ手法ごとに 20 回試行しました。条件は通常、ネオン照明(Lighting OOD)、白いカップを形の少し違う銀色のカップに替えたもの(Object OOD)です。SR は 4 段階すべてを完了した試行の割合、PS は完了した段階数が 4 段階に占める割合の平均です。
- Elastic-WAM:SR 50.0 / 50.0 / 30.0、PS 57.5 / 52.5 / 47.5。
- Joint-WAM:SR 30.0 / 30.0 / 30.0、PS 37.5 / 35.0 / 35.0。
- Fast-WAM:三つの条件すべてで SR 0.0、PS 12.5 / 5.0 / 10.0。
回数に直すと、50.0% は 20 回中 10 回、30.0% は 6 回です。実機の部分では遅延は報告されていません。著者は長いタスクでの優位を一つの仮説として説明しています。時間方向の進め方と空間方向の配分を同時に適応させることで、方策が視覚的な変化から現在の段階を見分けやすくなる可能性がある、というものです。著者はこれが LIBERO の Long スイートと実機の PS の結果と整合すると述べていますが、読んだ本文にはこの仕組みを直接検証する実験はありません。
数字の読み方
この論文の新しさは計算の配分にあります。基盤の WAM は変えず、状態ごとに未来動画をどれだけ、どこを精緻化するかを決めます。本サイトで紹介した Forward Dynamics Models は別の道をとり、推論時に未来生成を省きます。HWAM も Fast-WAM をベースラインに使っていました。世界モデルが何を予測し、何を条件にしているかは フィジカルAIラボ 3.2 で扱っています。
遅延を読むときの注意点は三つです。第一に、32.2% は同じ基盤の密な精緻化との比較で、最速の手法との比較ではありません。Fast-WAM のほうが速く、VLA ベースラインはさらにずっと速いです。第二に、388.2 ms は H800 での数字で、ロボットに載せるハードウェアでは変わります。第三に、1 回の推論で支えられる制御周波数は、推論 1 回あたり何ステップの動作を実行するかで決まりますが、論文にはその情報がありません。遅延から制御周波数の上限を求める方法は フィジカルAIラボ 2.6 にあります。
成功率については、論文のどの表にも信頼区間、乱数シード、繰り返し回数が示されていません。シミュレーションでの差には 1 から 3 ポイントしかないものがいくつかあります。たとえば RoboCasa-GR1 の 57.4 対 55.0(差は 2.4 ポイント)や、アブレーションの 73.71 対 72.31 です。実機は条件ごとに 20 回しかありません。本サイトが Wilson 法で概算すると、95% 区間は 10/20 で約 29.9%–70.1%、6/20 で約 14.5%–51.9% で、大きく重なっています。手計算の方法は フィジカルAIラボ 2.8、対応のある比較は フィジカルAIラボ 1.8 にあります。PS は三つの条件すべてで Joint-WAM より高く、方向はそろっていますが、こちらも区間はありません。
制約と注意点
- arXiv のプレプリントで、数字はすべて著者報告 [R] です。本サイトは再現していません。読んだ本文には、コードや重みを公開するかどうかの記述はありません。
- どの表にも区間やシードがないため、シミュレーションでの 1–3 ポイントの差も、実機 20 回での差も、確定した順位として読むべきではありません。
- 遅延は RoboCasa-GR1 で H800 1 基を使ってのみ測定されています。実機試験では遅延も制御周波数も報告されていません。
- 論文は LIBERO-Plus のすべての区分でより頑健だとしていますが、表 3 で見ると成り立つのは Joint-WAM に対してだけです。
- 疎な更新 1 回あたりの更新トークン数 K0 = 96 は外部から与えるハイパーパラメータで、学習したものではありません。表 6b では LIBERO-Plus で最も高い値ですが、この既定値が同じ評価で選ばれたのかどうかは論文に書かれていません。
- 精緻化を止める「安全条件」は、読んだ本文では定義されていません。実機試験は一つのタスクを三つの条件で行ったもので、ハードウェアの安全性検証ではありません。
リンク
- Elastic-WAM: Adaptive Spatiotemporal Imagination for Efficient Robot Control(arXiv 2611.14257)
- 論文の HTML 全文
- フロンティア・レーダー|Forward Dynamics Models:未来予測が動作特徴を読み、動作は未来を読まない――推論時は未来生成を省略する
- フロンティア・レーダー|HWAM:人型ロボットの参照動作は実際の動きと一致しない――実行後の身体状態を動作と同時に生成する
- フィジカルAIラボ 3.2:世界モデル――Cosmos でデータをつくる。生成ごとの条件を書き出し、78.3% を人の評価に戻し、生成データの受け入れ基準を決める
- フィジカルAIラボ 2.6:エッジへ――遅延のログから制御周波数の上限を求め、量子化で減るのが容量か時間かを見分け、動作チャンクの長さを決める
- フィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求める
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座


