
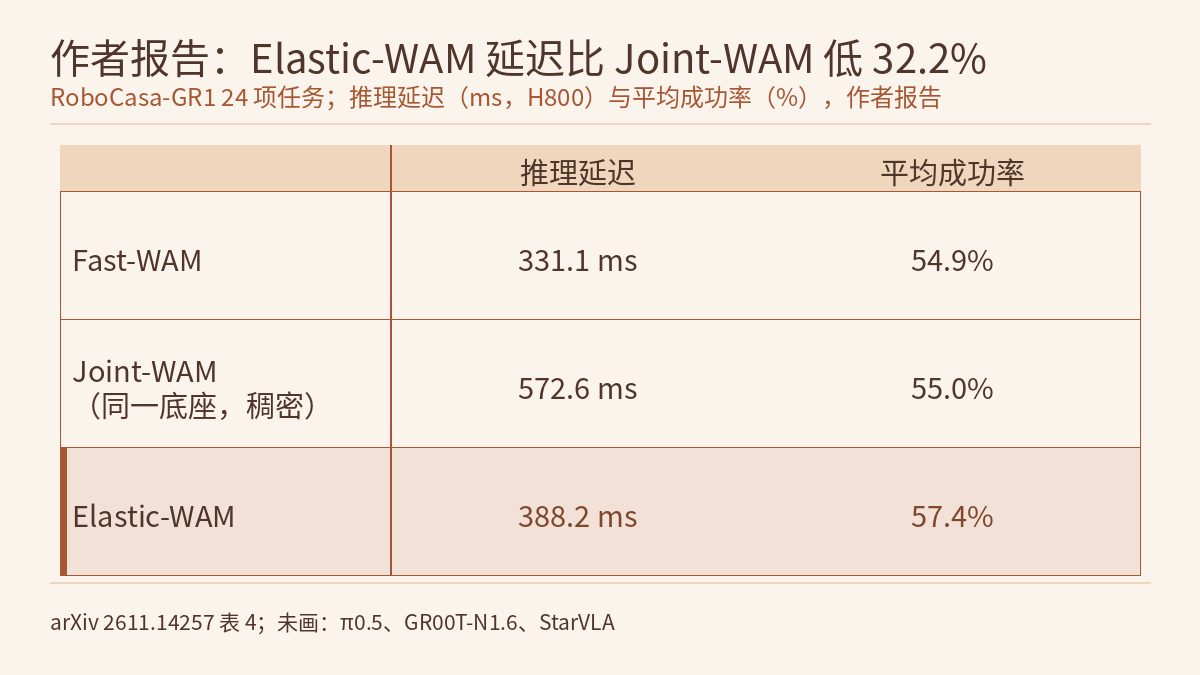
世界动作模型(World-Action Model,WAM)在生成机器人动作的同时预测未来画面,未来视频要一步步去噪,推理开销因此很大。已有的加速做法大多给未来细化定一个固定预算,不管当前任务和执行状态。新加坡国立大学与 RoboScience 等机构的 Haitian Li 等人在预印本 Elastic-WAM(arXiv 2611.14257,2026-11-10)里,让一个学出来的“细化需求场”按当前状态决定三件事:什么时候停止细化未来视频,下一步去噪推进多少,刷新哪些未来视频 token;底座 WAM 全程冻结。作者报告,在 RoboCasa-GR1 上平均成功率 57.4%,推理延迟 388.2 ms,比同一底座的 Joint-WAM(572.6 ms)低 32.2%。以下数字均为作者报告 [R],本站没有运行作者的代码。
做法:一个细化需求场管三件事
作者先在 LIBERO-Plus 中选了 10 个任务做观察:成功率最高时对应的去噪步数,在不同任务之间从 1 步到 4 步不等;同一任务内,不同状态偏好的细化深度也不同。动作对未来视频的注意力图还显示,动作生成对未来画面各区域的关注并不均匀。论文据此认为,细化计算应当同时在去噪时间和未来视频空间两个方向上按需分配。
具体做法是把 196 个未来视频 token 分成 64 个组,分组保持时间和相机视角的边界,每组含 1、2 或 4 个 token。每组有一条沿归一化去噪进度 z ∈ [0, 1] 的“剩余需求”曲线,写成幅值乘以一个 Beta 密度。由于所有未来 token 在底座 WAM 里走同一条去噪轨迹,作者让各组共享同一个时间基底 B0,只让幅值随组变化:每组幅值是 sigmoid(b0 + Δu_g),其中 b0 是全局偏置,Δu_g 是按 token 数加权去均值后的相对分数。所有组幅值按 token 数加权平均,得到总剩余需求 D(s)。这样拆开后,全局偏置只管“还要细化多少”,相对分数只管“先细化哪里”。三个决定由这个场读出:
- 何时停(WHEN):把每一步的 D 当作继续细化的条件概率,累积的“世界提交”(World Commit)概率是 1 减去各步 D 的连乘积;累积概率达到 0.5 时停止细化未来视频。
- 走多远(HOW FAR):取共享时间基底的众数 z_k,下一步的噪声降幅为 δmin + z_k(δmax − δmin),其中 δmin = 0.05,δmax = min(0.20, σ_k − σ_floor)。
- 刷哪里(WHERE):在恰好 K0 个 token 的预算下,选相对分数最高的组;默认每次稀疏更新刷新 K0 = 96 个 token。预算由外部指定,学出来的分数只决定选哪些区域。
训练与推理:冻结 WAM,只学这个场
底座是 FastWAM-Joint,论文说明它就是 Faster-WAM 论文里称为 Joint-WAM 的模型,所以对比表中的 Joint-WAM 就是未加这套机制的同一底座。训练分三段,每段只学一部分参数,其余冻结:
- 时间形状:从同一个循环状态出发,比较“立即提交”与几种不同去噪距离的“继续一步”,每种都走完动作去噪,再用终端动作误差 E = 0.6 E_seq + 0.4 E_Δ 打分(前者是动作序列误差,后者是相邻动作差的误差)。误差越低的候选在软目标里概率越高,用来监督 B0;同一组比较还训练出一个判断何时停的时间教师。
- 空间优先级:在同一去噪状态下,用不回传梯度的稠密更新当教师,可微的稀疏更新当学生;离散的定额掩码用 straight-through 近似求梯度。梯度穿过冻结的 WAM 计算图,只更新空间分数。
- 总需求:用时间教师的停止预测构造每一步的目标继续概率,换算成目标全局偏置 b0,并在完整的循环前缀上训练,约束累积停止概率和提交时机。
推理时,每个重规划周期先对全部未来 token 做一次稠密的联合去噪,建立循环状态和逐层的 key–value 缓存。之后每一步,观测和动作的 query 保持稠密,只有被选中的未来视频 query 重新计算,且仍能看到完整的逻辑 key–value 上下文;未被选中的 token 沿用缓存的隐状态、key、value 和上次刷新时的速度。累积提交概率达到阈值,或触发论文所说的“安全条件”时,停止细化未来视频,直接用当前的视频表示和缓存继续动作去噪,不需要再做一次视频预填充。所读正文没有说明这个安全条件具体是什么。
仿真结果与延迟
四个仿真基准分别是 LIBERO(4 个套件,每个任务 50 次 rollout,共 2,000 回合)、LIBERO-Plus(7 类扰动)、LIBERO-Pro(4 类泛化变化)和 RoboCasa-GR1(24 项任务,沿用 StarVLA 的评测设置)。LIBERO-Plus 和 LIBERO-Pro 直接评测在 LIBERO 上训练的策略,不做额外适配。平均成功率(%):
- LIBERO:Elastic-WAM 98.8,Joint-WAM 98.5,LingBot-VA 98.5,π0.5 96.9。作者强调 Long 套件上比 Joint-WAM 高(98.2 对 96.8),但 LingBot-VA 在这个套件上是 98.5。
- LIBERO-Pro:Elastic-WAM 54.1,π0.5 53.4,Joint-WAM 52.8。四类变化里 Position 一项所有方法都很低,Elastic-WAM 为 8.4,π0.5 为 20.8。
- LIBERO-Plus:Elastic-WAM 73.7,OpenVLA-OFT 69.6,LingBot-VA 69.5,Joint-WAM 66.3,Fast-WAM 49.1。
论文正文说 Elastic-WAM 在 LIBERO-Plus 的所有扰动类别上都更稳健。按论文自己的表 3,这句话对 Joint-WAM 成立,七类都更高;对其他基线不成立,有四类至少一个基线得分更高:相机视角,π0-Fast 65.1、OpenVLA-OFT 56.4,Elastic-WAM 52.1;机器人初始状态,LingBot-VA 83.0,Elastic-WAM 76.3;背景,OpenVLA-OFT 93.3、π0 81.4、UniVLA 81.0、π0-Fast 73.2,Elastic-WAM 60.0;传感器噪声,π0 79.0、OpenVLA-OFT 75.8、π0-Fast 74.4、LingBot-VA 64.4,Elastic-WAM 61.1。论文称提升“尤为明显”的是相机视角、机器人初始状态和传感器噪声三类,这三类都在上述四类之中。摘要里的“state-of-the-art”,引言也限定为“在没有大规模具身预训练的方法中”。
延迟只在 RoboCasa-GR1 上报告,单位 ms,在一块 NVIDIA H800 GPU 上测得。论文表 4 的三个 WAM 行如下:
| 方法 | 推理延迟(ms) | 平均成功率(%) |
|---|---|---|
| Fast-WAM | 331.1 | 54.9 |
| Joint-WAM | 572.6 | 55.0 |
| Elastic-WAM | 388.2 | 57.4 |
32.2% 是相对 Joint-WAM 的降幅,即(572.6 − 388.2)/ 572.6。Fast-WAM 在推理时去掉显式的未来视频生成,延迟比 Elastic-WAM 少 57.1 ms,成功率低 2.5 个百分点。同表中的三个 VLA 基线 π0.5、GR00T-N1.6 和 StarVLA 延迟为 77.0–82.0 ms,成功率为 37.0–48.8%;Elastic-WAM 的延迟约为它们的 4.7–5.0 倍(本站按表中数字计算)。所读正文没有说明一次延迟测量覆盖的范围,例如是否对应一个重规划周期,也没有给出动作块长度或控制频率。
消融与真机试验
消融都在冻结底座上做,每个单元格给出一个成功率,论文没有说明运行次数或随机种子数:
- 空间选择(RoboCasa-GR1,表 5):学出来的选择、每步 96 个 token 为 57.42%;同样预算随机选为 53.83%;全部激活、K = 128 为 55.17%;FirstKV,即沿用 Faster-WAM 的做法、复用初始视频缓存而不再细化,为 54.50%。
- 时间控制(LIBERO-Plus,表 6a,空间选择与预算固定):只有空间选择 71.71%,加上自适应提交但步长固定 72.31%,提交和步长都自适应 73.71%。
- 刷新预算(LIBERO-Plus,表 6b):K = 49 为 72.84%,K = 96 为 73.71%,K = 147 为 71.71%,K = 196(等于全部 196 个未来 token)为 70.92%。作者的结论是,刷新更多未来 token 不一定改善下游控制。
真机试验用两台 UFACTORY xArm 7 组成的双臂平台,任务是四段式泡茶:把白杯放到无盖茶壶上,用有盖茶壶给白杯倒茶,把白杯放回原位,再用无盖茶壶给黑杯倒茶并把茶壶放回。作者采集了 200 条示范,在三种条件下每种方法各试 20 次:常规、霓虹灯光照(Lighting OOD)、把白杯换成形状略有不同的银色杯(Object OOD)。SR 是四段全部完成的比例,PS 是平均完成段数占四段的比例。
- Elastic-WAM:SR 50.0 / 50.0 / 30.0,PS 57.5 / 52.5 / 47.5。
- Joint-WAM:SR 30.0 / 30.0 / 30.0,PS 37.5 / 35.0 / 35.0。
- Fast-WAM:三种条件下 SR 都是 0.0,PS 12.5 / 5.0 / 10.0。
换成次数,50.0% 是 20 次中的 10 次,30.0% 是 6 次。真机部分没有报告延迟。作者把长时程上的优势解释为一个假设:同时自适应时间推进和空间分配,可能帮助策略从视觉变化中分辨当前所处的阶段;作者称它与 LIBERO Long 套件和真机 PS 的结果一致,所读正文没有专门检验这个机制的实验。
怎样读这些数字
这篇论文的新意在于计算分配:它不改底座 WAM,只决定每个状态下未来视频细化多少、细化哪里。本站介绍过的 Forward Dynamics Models 走的是另一条路,推理时跳过未来生成;HWAM 也拿 Fast-WAM 做过基线。世界模型本身预测什么、以什么为条件,见 物理AI实验室 3.2。
读延迟时要注意三点。第一,32.2% 是与同一底座的稠密细化相比,不是与最快的方法相比;Fast-WAM 更快,VLA 基线快得多。第二,388.2 ms 是 H800 上的数字,换成机载硬件后会不同。第三,一次推理能支撑多高的控制频率,取决于每次推理执行多少步动作,论文没有给出这部分信息;从时延算控制频率上限的方法见 物理AI实验室 2.6。
读成功率时,论文没有给任何表报告置信区间、随机种子或重复次数。仿真里的几处差距只有 1 到 3 个百分点,例如 RoboCasa-GR1 上 57.4 对 55.0(相差 2.4 个百分点),消融中 73.71 对 72.31。真机每种条件只有 20 次:按 Wilson 方法粗算(本站计算),10/20 的 95% 区间约为 29.9%–70.1%,6/20 约为 14.5%–51.9%,两者大幅重叠。手算方法见 物理AI实验室 2.8,配对比较见 物理AI实验室 1.8。PS 在三种条件下都比 Joint-WAM 高,方向一致,但同样没有区间。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。所读正文没有说明是否发布代码或权重。
- 没有任何表报告区间或种子,仿真中 1–3 个百分点的差距和真机 20 次的差距都不宜读成确定的排序。
- 延迟只在 RoboCasa-GR1、单块 H800 上测量;真机试验没有报告延迟,也没有给出控制频率。
- 论文称 LIBERO-Plus 所有类别都更稳健,按其表 3 只对 Joint-WAM 成立。
- 每次稀疏更新刷新的 token 数 K0 = 96 是外部给定的超参数,不是学出来的。表 6b 中它在 LIBERO-Plus 上最高,论文没有说明这个默认值是否就是在同一评测上选定的。
- 停止细化的“安全条件”在所读正文中没有定义。真机试验是一项任务、三种条件,不是硬件安全验证。
链接
- Elastic-WAM: Adaptive Spatiotemporal Imagination for Efficient Robot Control(arXiv 2611.14257)
- 论文 HTML 全文
- 前沿雷达|Forward Dynamics Models:未来预测读取动作特征、动作不读未来,推理时跳过未来生成
- 前沿雷达|HWAM:人形机器人的参考动作不等于实际动作,把执行后的本体状态和动作一起生成
- 物理AI实验室 3.2:世界模型,用 Cosmos 造数据,写清每种生成以什么为条件,把 78.3% 放回人类评审,再给生成数据定验收规则
- 物理AI实验室 2.6:上边缘,从时延日志算出控制频率上限,分清量化省下的是体积还是时间,再给动作块定长度
- 物理AI实验室 2.8:可复现评测,手算 Wald 与 Wilson 区间,从 1/√n 定评测次数,再给零失败算出失败率上界
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程


