这一期装一个开源的机器人学习框架:LeRobot。我们用它在一个仿真的推 T 形方块(PushT)任务上训练策略,看两轮训练的评估结果,再看两段评估回放:一段成功,一段失败。这不是“学会了”的演示,它只是一次完整的流程。
本集是仿真演示,不是真机实验。所有数字来自两次训练的 train.log 和评估的 JSON。本页是图文版,由“物理AI开源实战”系列的第 1 期整理而成。
本集视频
配音由 AI 合成(Serena)。
为什么选它
LeRobot 是 Hugging Face 的机器人学习库,Apache-2.0 许可。我们用的是 v0.7.0,固定在提交 410c095e。它把数据、策略、训练和评估放在同一条命令链里。我们在沙箱里把训练和评估完整跑了一遍。
装环境
我们用 uv 装依赖,Python 版本不低于 3.12。依赖版本由仓库自带的锁文件固定,锁文件的 sha256 以 d569cc07 开头。
官方的装法是按官方安装文档安装 lerobot 本身,并带上 training、pusht、diffusion 三个额外依赖。这三组要一起装,缺任何一组,运行时会报 ImportError。
我们的沙箱出于隔离要求,另用锁文件导出依赖,并用 PYTHONPATH 指向源码目录运行。你不需要这样做,照官方方法装即可。
训练命令的三个要点
第一,push_to_hub 默认是开的,也就是训练配置要求把结果推送到 Hugging Face Hub。所以命令里必须写 --policy.push_to_hub=false。第二,--help 要先指定策略类型,才会列出完整的参数;我们先写 --policy.type=diffusion,再查参数名。第三,数据集要固定版本。lerobot/pusht 的修订号是 b1c3ecba,数据格式是 v3.0,共 206 个回合,25,650 帧。
策略和设置
策略是扩散策略(diffusion)。视觉部分用 ResNet-18,初始权重来自 ImageNet 预训练,其余部分在 PushT 数据上训练。我们没有从零训练视觉部分。两次运行的批大小都是 8,随机种子都是 1000,也就是说两次运行用的都是一个种子。
第一次:2000 步
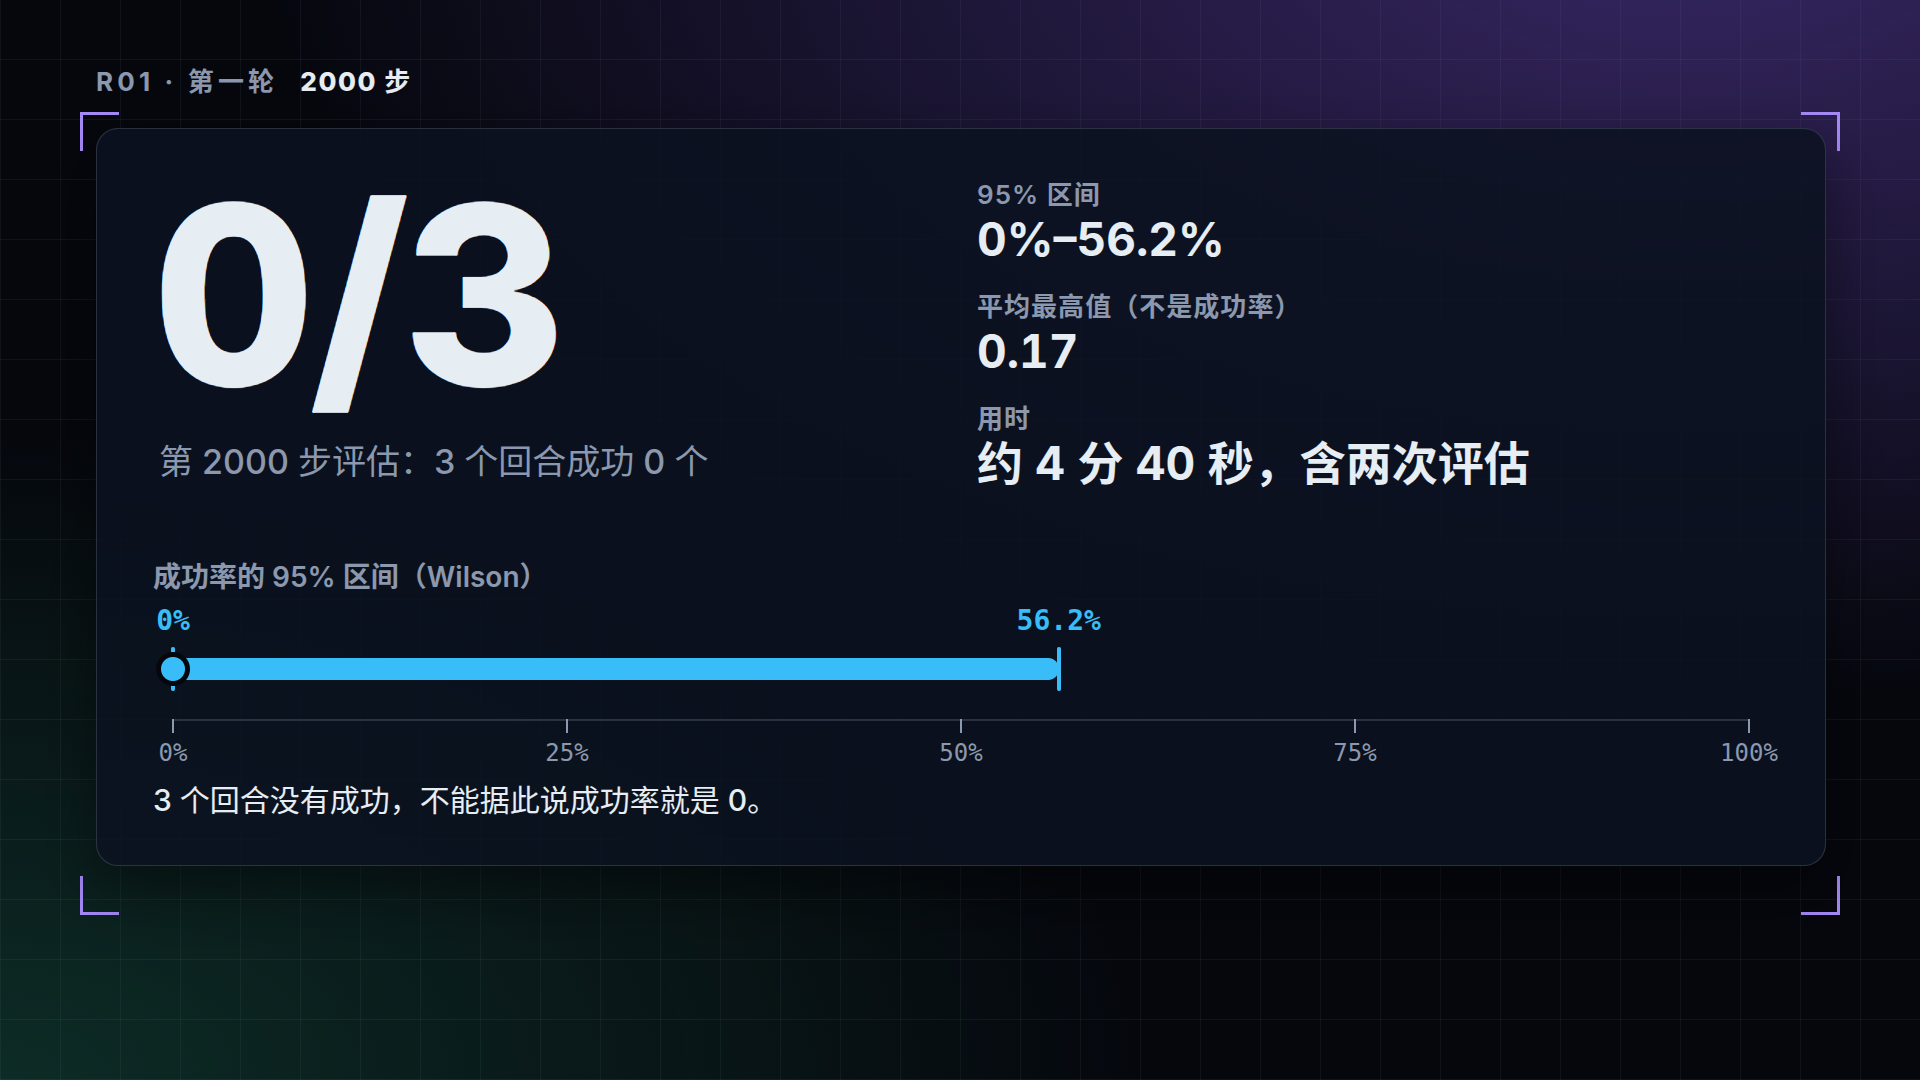
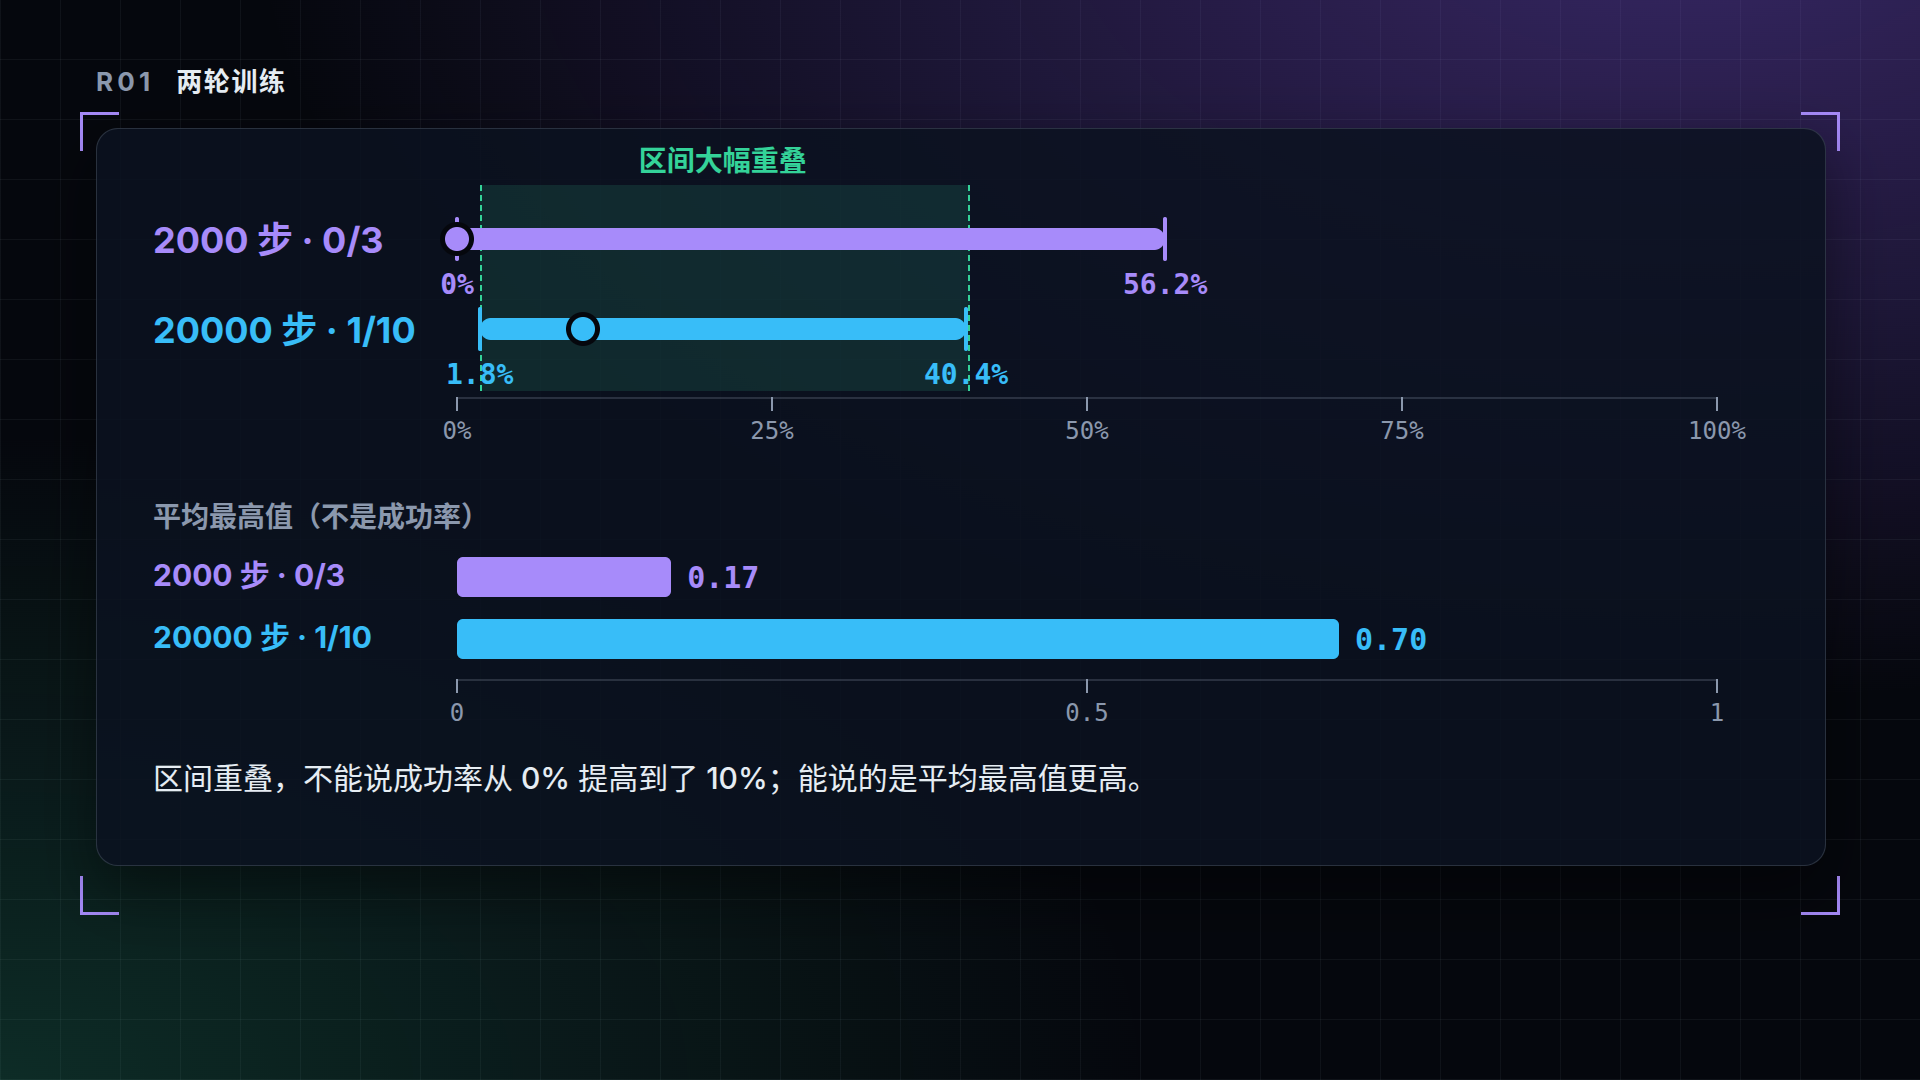
第一次训练 2000 步,用时约 4 分 40 秒,含两次评估(第 1000 步和第 2000 步)。第 2000 步评估 3 个回合,成功 0 个。按 95% 的 Wilson 区间,这个结果的范围是 0% 到 56.2%。3 个回合没有成功,不能据此说成功率就是 0。
第 1000 步的评估是 3 个回合,平均最高值是 0.053。第 2000 步的平均最高值是 0.17。
这个指标是“把方块推进目标区域的程度”的平均最高值。每一步的奖励是覆盖率除以 0.95,截断到 0 到 1 之间。覆盖率超过 95% 就算成功,回合立即结束。所以 1 表示成功,0.96 大约对应 91% 的覆盖率,还没有成功。它不是成功率。
第二次:20000 步
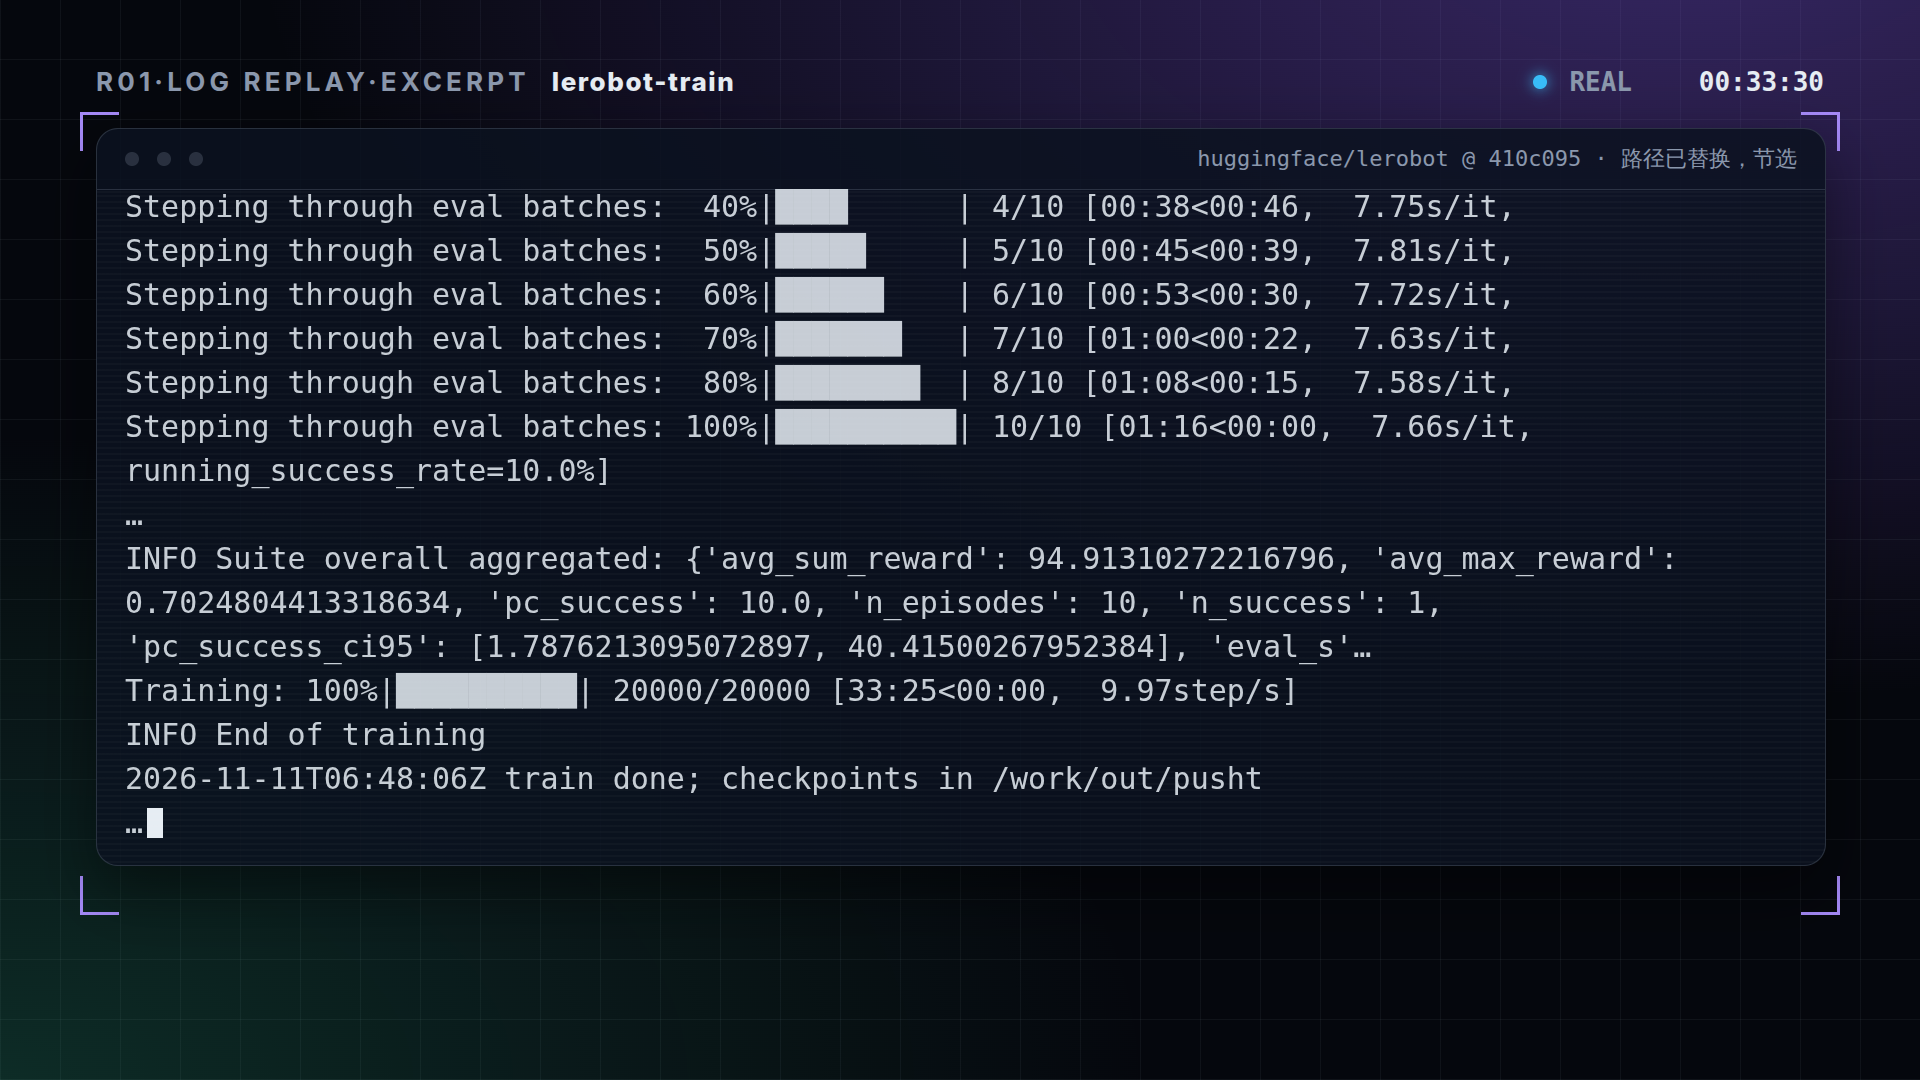
第二次训练 20000 步,训练约 32 分钟(不含最后一次评估;截图里进度条的 33 分 25 秒包含这次评估),在 L40S 上跑的。平均每秒约 10 步,这是我们按 20000 步除以约 1927 秒算的。
训练结束后评估 10 个回合:成功 1 个,成功率 10%,95% 区间是 1.8% 到 40.4%。平均最高值是 0.70。
| 训练步数 | 评估回合 | 成功 | 成功率 | 95% 区间(Wilson) | 平均最高值 |
|---|---|---|---|---|---|
| 2000 | 3 | 0 | 0% | 0% 到 56.2% | 0.17 |
| 20000 | 10 | 1 | 10% | 1.8% 到 40.4% | 0.70 |
两次的成功率区间大幅重叠,所以不能说“从 0% 提高到了 10%”。能说的是:平均最高值从 0.17 升到 0.70,策略把方块推到目标附近的程度更高了。这是这两次运行里观察到的,不能外推到其他步数或其他种子。
评估回放:一次成功,一次失败
评估录了 4 段视频。第 0 段是 10 个回合里唯一成功的一次,第 1 段失败。第 2、3 段也是失败的。上面的视频里放了第 0 段和第 1 段。
7 个坑
这一期踩了 7 个坑。公开的部分讲三个:push_to_hub 默认是开的;--help 要先指定策略类型;训练和扩散策略两组依赖要一起装。其余四个是:限制出网的环境里要放行的存储域名;隔离环境里 GPU 需要的设置;两个 opencv 包互相覆盖;并行下载被代理的连接上限卡住。这四个的具体修法放在知识星球的付费内容里。
局限 / 注意
两轮训练,一个种子,两轮评估共 13 个回合(第一轮 3 个,第二轮 10 个)。结论很小:流程能跑通,数字能对上日志,但策略还不可靠。要判断它好不好用,需要更多的步数、更多的回合和更多的种子。
页面上的终端截图是训练日志的回放节选,不是屏幕录制:文字取自日志原文,路径已替换为通用名称,日志行首的时间前缀已去掉(个别行里的日期属于日志内容本身),过长的行用省略号截断,中间删去了部分行。结果卡和对比图是用实测数字画的示意。
下一期换一个仓库,用同样的方式装、跑、看。
证据清单
片中每个数字的出处如下,欢迎核对。
- 0/3 第一次训练(2000 步):评估 3 个回合成功 0 个,95% Wilson 区间 0%–56.2%,平均最高值 0.17(第 1000 步为 0.053),用时约 4 分 40 秒,含两次评估(O · 官方一手)。来源:我们这次训练的日志(评估汇总行;日志未公开),2026-11-11
- 1/10 第二次训练(20000 步):评估 10 个回合成功 1 个,95% Wilson 区间 1.8%–40.4%,平均最高值 0.70,训练约 32 分钟(不含最后一次评估),按 20000 步除以约 1927 秒算,平均每秒约 10 步(O · 官方一手)。来源:我们这次训练的日志(评估汇总行;日志未公开),2026-11-11
- 410c095e LeRobot v0.7.0,提交 410c095eacc0011d998a73383eb94abed2715af0,Apache-2.0(O · 官方一手)。来源:huggingface/lerobot,2026-11-05
- b1c3ecba 数据集 lerobot/pusht,修订 b1c3ecbae7f244acc039a3dbc255a00dad1372b9(206 个回合,25,650 帧)(O · 官方一手)。来源:Hugging Face 数据集 lerobot/pusht,2026-01-29
- d569cc07 锁文件 sha256 的前 8 位(O · 官方一手)。来源:LeRobot v0.7.0 仓库自带的锁文件,2026-11-05
- 0.95 平均最高值的定义:每一步奖励 = 覆盖率 ÷ 0.95,截断到 0–1,覆盖率超过 95% 算成功(O · 官方一手)。来源:PushT 环境 gym-pusht 的源码,2026-10-12
- 8 · 1000 批大小 8,随机种子 1000(两次运行相同,只用一个种子)(O · 官方一手)。来源:我们这次训练的配置(train_config.json;未公开),2026-11-11
- 日志回放 片中终端是两次训练日志的节选回放,不是屏幕录制;路径已替换,时间按日志重建(O · 官方一手)。来源:本集制作说明,2026-11-13