この回の動画
ナレーションは AI 合成音声です。 動画の章・文字起こし・出典
文字起こし
文字起こし
知行の問い
あるロボットの方策が、成功率八十四パーセントと報告されてる。その数字、ほんとに信じられる?前回は、安全フィルターを作りました。今回の問いは、それが本当に効くと、どう証明するか。答えは、繰り返し実験と信頼区間です。
ひとつの成功率のウソ
まず実験をしましょう。すべて今回のノートブックでシミュレーションします。本当の成功率は、ちょうど七十パーセントだとします。走らせて、どんな報告が出るか見てみます。一回走らせて、何回成功したか数えます。計算すると、ちょうど七十パーセント。なかなか正確に見えます。まずはっきりさせておくと、成功率はただの比率です。成功した回数を、全体の回数で割ったもの。でも、単純な数ほど、誤解されやすいのです。では、もう一回走らせたら?乱数のシードを変えるだけで、数字が変わります。この回は、六十パーセントかもしれません。この方策を、すぐに責めないでください。本当に七十パーセントの実力があるのかもしれません。今回は、ちょっと運が悪かっただけです。もっと厄介なのが、都合のいいデータだけを選ぶことです。何回も走らせて、いちばん高い回だけを報告する。そんな成功率は、自分をだましているのと同じです。同じ方策を、十二回走らせます。高い回と低い回で、大きな差が出ます。ぜんぶ、運で揺れているのです。これは作り話ではなく、論文で確かめられています。同じ設定で、シードだけを変えて十回。二つのグループに分けると、結論が有意に違うことさえあります。一回走らせただけじゃ、見えてるのはただの運かもしれないんだ!コイン投げでたとえましょう。十回投げて、表五回、裏五回はよくあることです。でも、表七回、裏三回でも、少しも珍しくありません。ここに法則があります。サンプルが少ないほど、ランダムの気まぐれは大きくなります。サンプルが増えて、やっと落ち着いてくるのです。
成功率に区間をつける
だから、数をひとつだけ報告してはいけません。区間をつけましょう。本当の成功率が、だいたいどの範囲にあるのかを、はっきり言うのです。いちばんよく使われる方法は、ワルド区間です。教科書に出てくる、正規近似、つまり正規分布で近似する公式です。でも、そこには大きな欠点が隠れています。ある統計学の論文によると、ワルド区間のカバー率は、ずっと低すぎます。論文のすすめは、サンプルが少ないときは、ウィルソン区間を使うことです。ウィルソン区間はどう計算するのでしょう?観測した成功率を、真ん中のほうへ少しだけ引き寄せます。サンプルが少ないほど、強く引き寄せます。十回すべて成功したら、どれほどおかしくなるか。ワルド区間は、成功率は百パーセントだと言います。区間の幅は、なんとゼロです。これは明らかにおかしい。十回全部うまくいったからといって、一度も失敗しないと言えますか?ウィルソンは、そこまで甘くありません。なぜ低すぎるのでしょう?正規近似は、サンプルが少なく、比率が極端なときに、とくに不正確です。サンプルが少なくないときでも、カバー率は上下にぶれます。区間は、もうひとつのことも教えてくれます。二つの方策を比べるとき、区間が大きく重なっていれば、まだ勝ち負けは決められません。区間が完全に離れていれば、その差は信頼できます。だから、ランキングを見るときは、一位だけを見つめないでください。まず、区間がどれだけ重なっているかを見ましょう。厳密に比べるなら、差の区間を求めるか、検定をします。もうひとつ、汎用の方法があります。ブートストラップ法です。ある論文は、一万回リサンプリングして区間を求めています。いちばん簡単なやり方は、真ん中の部分を取ることです。ブートストラップ法のよいところは、分布も公式も仮定しなくていいことです。ただし、サンプルを母集団の身代わりとして扱います。サンプルが少なすぎたり、比率が極端だったりすると、これもうまくいきません。では、どれを信じればいいのか?成功率のサンプルが少ないなら、まずウィルソン。サンプルが多く、統計量が複雑なときに、ブートストラップ法です。区間って飾りじゃないんだ!その数がどれだけ不確かか、教えてくれてるんだね。
何回走らせればいい?
では、何回走らせればいいのでしょう?まず、ひとつの法則を見ます。区間の幅は、だいたいルートエヌに反比例して、ゆっくり縮んでいきます。この法則は、実はなかなか厳しいのです。不確かさを半分に減らしたいなら、サンプル数は四倍にしなければなりません。だから、八回や十回で足りるとは思わないでください。まともな区間がほしいなら、サンプル数は多めに見積もるべきです。実機の評価は、もっと貴重です。一回ごとに、本当にロボットを動かさなければなりません。だからサンプルは、たいてい悲しいほど少ないのです。見方を変えてみましょう。長く観察するほど、たしかにめったに失敗しない、と自信を持って言えるようになります。もうひとつ、直感に反する落とし穴を、このノートブックの例で見てみます。前回の安全フィルターを百回試して、一度も失敗しなかったとします。それでも、成功率が百パーセントだとは限りません。サンプルが少ないほど、この上限はゆるくなります。失敗ゼロは、まだ出くわしていないだけ。失敗しない、という意味ではありません。失敗ゼロでも、リスクゼロじゃないんだ!まだ試し足りないだけなんだね。だから成功率を報告するときは、三つをセットで報告します。何回やったか、どの区間か、区間の幅はどれくらいか。ひとつも欠かせません。乱数のシードも報告しましょう。そうすれば、ほかの人が、あなたの結果をそっくりそのまま再現できます。区間は、サンプルがもうじゅうぶんかどうかも教えてくれます。やみくもに走らせ続けないでください。いちばん忘れやすいのは、成功と失敗の定義です。まず、はっきり定義すること。判定の基準が変われば、数字はすべて変わります。評価の場面も、はっきりさせましょう。どこで評価したか、どれくらい難しいか、簡単なものを選んでいないか。場面が変われば、成功率も、まったく別物です。今回のノートブックを開いて、一緒にやってみましょう。同じ方策を、何回も繰り返し評価します。成功率が、どう散らばるかを見てください。次に、カバー率の曲線を描きます。ワルドの線は、はっきり九十五パーセントを下回ります。ウィルソンは、ほぼ沿っていて、ときどき少し下回ります。最後に、区間の半分の幅を、サンプル数に対してプロットします。ルートエヌに反比例して、ゆっくり狭まっていくのが、自分の目で見えるはずです。評価の正直さって、この区間の中にあるんだ!ふりかえりです。一つ、成功率をひとつの数だけで報告すると、誤解を招く。区間をつける。二つ、ワルド区間は使わない。サンプルが少なければ、ウィルソン。ブートストラップ法は、サンプルが多く、統計量が複雑なときに。三つ、サンプルが少ないほど区間は広い。そして、失敗がゼロでも、リスクはゼロではありません。評価は、見栄えのいい数字のためじゃない。自分がどれだけ確かなのかを知るためなんだ!成功率が、どれだけ確かなのかは、もう分かった。じゃあ、見て、考えて、動ける大規模モデルって、中身はどうなってるの?また次回!
根拠と出典
練習とセルフチェック
小テストは公開で、回答するとすぐ解説が出ます。読み物の練習問題の答えはログイン会員向けです。
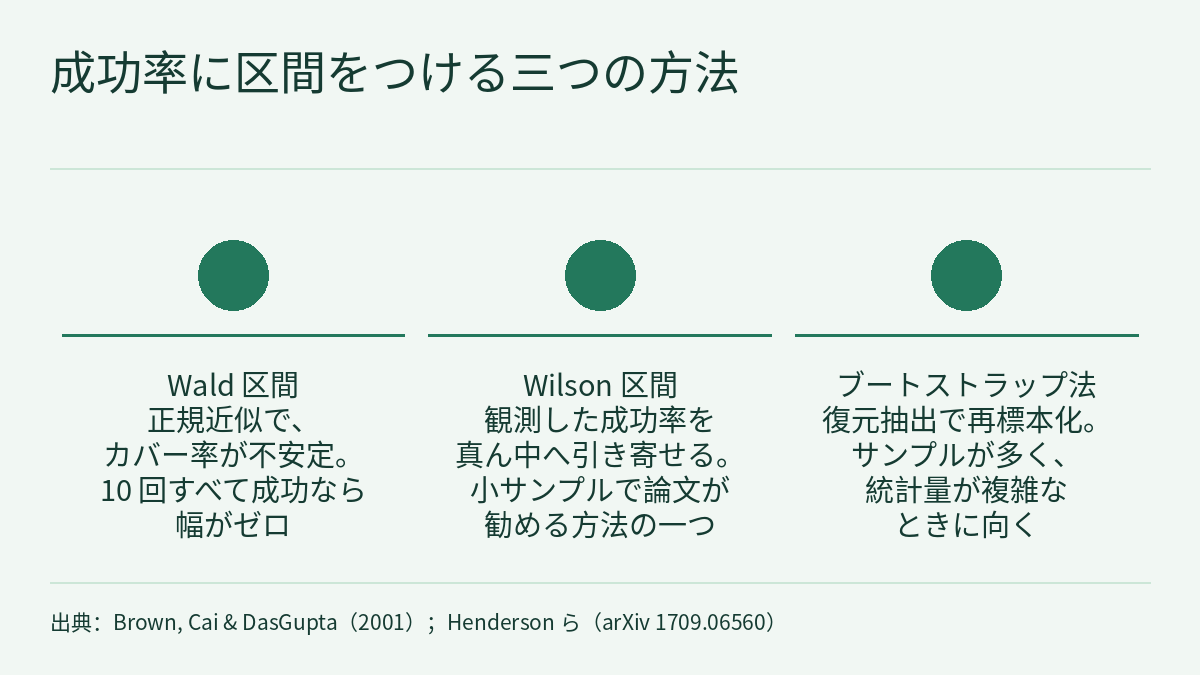
第 2.8 回の動画は、ある方策が「成功率 84%」と報告したとき、その数字を信じられるかを問います。動画は三つのことを説明します。成功率をひとつだけ報告すると誤解を招きます。乱数シードを変えるだけで数字が跳ねるので、区間をつける必要があります。教科書の Wald(正規近似)区間は使わず、小サンプルの成功率には Wilson 区間を使い、ブートストラップ法はサンプルが多く統計量が複雑なときに使います。区間の幅はおよそ 1/√n で縮み、失敗ゼロはリスクゼロを意味しません。動画の三枚の数字カードは、二つの公開資料から取られています。Henderson らの Deep Reinforcement Learning that Matters(arXiv 1709.06560)では、同じハイパーパラメータで乱数シードだけを変えて 10 回走らせ、5 回ずつ二組に分けると、結論が統計的に有意に違うことがあります。同じ論文は、いくつかの MuJoCo 環境の平均リターンについて、一万回のリサンプリングと pivotal 法でブートストラップの 95% 信頼限界を求めています。Brown、Cai、DasGupta の Interval Estimation for a Binomial Proportion(Statistical Science、2001)は、Wald 区間のカバー率の性質が混沌としていることを示し、小さな n には Wilson 区間を勧めています。このページはこの回の解説と練習です。文字起こしは繰り返さず、動画が結論だけを示した三つのことを計算します。架空の 20 回の評価で Wald 区間と Wilson 区間を手で計算し、Wald が 100% を超えたり、すべて成功したときに幅がゼロになったりする理由を確かめます。1/√n の法則で評価の回数を決め、失敗ゼロのあとの失敗率の上限の求め方を導きます。最後に Henderson らの表 3 の実際の数字を読み、区間を比較にどう使うか、サンプルがごく少ないときにブートストラップ法がなぜうまくいかないかを見ます。全体を通じたルールは一つです。区間は、それ自身の試行の回数、判定基準、場面についてだけのもので、報告では回数、区間の種類、幅をそろえて書きます。
この回の動画、文字起こし、出典はこのページの上部にあります。シーズン全体の構成は講座の概要をご覧ください。前回のフィジカルAIラボ 2.7:安全フィルター――制御バリア関数による修正を一歩手で計算し、入れるループと残すべき安全の余裕を求めるは、最後に「この仕組みが本当に効くと、どうやって分かるのか」と問いかけました。この回はその答えです。Henderson らの「シードだけを変えて 10 回走らせ、二組に分ける」の原文と実験の条件、そして成功率の対応づけ方や失敗の分類のしかたは、フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめるですでに扱い、練習もしました。この回ではそれらを繰り返さず、この回で新しく加わった部分だけを扱います。区間の計算のしかた、必要な回数、失敗ゼロの報告のしかた、そしてブートストラップ法を使える範囲です。次回 3.1 からは L3 に入り、VLA の視覚エンコーダ、言語バックボーン、動作ヘッドを分解します。
公開小テストの 5 問には詳しい解説が付いています。ログインすると、三つの練習に取り組めます。架空の三つの評価について Wald 区間と Wilson 区間、失敗ゼロのあとの失敗率の上限を手で計算し、報告の文を書く。架空の実機での評価の回数と時間の予算を決め、走らせたあと Wilson 区間で確かめる。ブートストラップ法、区間、停止のルールを誤って使った架空の評価報告を審査し、書き直す。いずれにも段階的な解答例、よくある誤り、20 点満点の採点基準が付いています。
1. 二つの資料はそれぞれ何を述べているか
Henderson ら、Deep Reinforcement Learning that Matters(arXiv 1709.06560。この回が読んだのは HTML v1、2017-09-19 投稿)。著者は McGill University と Microsoft Maluuba の所属です。論文は、強化学習の結果がなぜ再現しにくいかを調べたもので、対象は MuJoCo の連続制御タスクでの方策勾配法(TRPO、DDPG、PPO、ACKTR)です。この講座の区分では R レベルで、以下はすべて著者の報告です。本サイトは再現していません。動画の「10 回」の数字カードは、「Random Seeds and Trials」の節の二文に当たります。それぞれ独立に抜き出します。
We perform 10 experiment trials, for the same hyperparameter configuration, only varying the random seed across all 10 trials. We then split the trials into two sets of 5 and average these two groupings together.
この実験の条件と論文による読み方は、1.8 で扱いました。この回に関係するのは、同じ節のほかの二点です。論文によると、最近報告された結果では、何回かの試行から上位 N 回を選んだり、ごく少ない回数(N < 5)だけを平均したりするやり方が珍しくなく、論文はこれが誤解を招きうると考えています。また論文は、推奨できる具体的な試行回数は示せないとも述べています。動画の第 1 章の「都合のいいデータだけを選ぶ」は、こうしたやり方を指しています。
動画の「10,000 回」の数字カードは、表 3 の説明に当たります。
Bootstrap mean and 95% confidence bounds for a subset of environment experiments. 10k bootstrap iterations and the pivotal method were used.
表 3 は四つのアルゴリズムの四つの環境での平均リターンを示し、各セルはブートストラップの平均、括弧内は 95% 信頼限界です。論文の実験の節の共通の設定は、評価ごとに 5 回の試行を、それぞれ異なるあらかじめ決めた乱数シードで走らせ、すべての実験で同じシードの組を使うというものです。表 3 の説明は、各セルに何回の試行を使ったかを別に書いていません。第 4 節で次の表を使うので、ここに元の数字を挙げます。
| 環境 | DDPG | ACKTR | TRPO | PPO |
|---|---|---|---|---|
| HalfCheetah-v1 | 5037 (3664, 6574) | 3888 (2288, 5131) | 1254.5 (999, 1464) | 3043 (1920, 4165) |
| Hopper-v1 | 1632.1 (607, 2370) | 2546 (1875, 3217) | 2965 (2854, 3076) | 2715 (2589, 2847) |
| Walker2d-v1 | 1582 (901, 2174) | 2285 (1246, 3235) | 3072 (2957, 3183) | 2926 (2514, 3361) |
| Swimmer-v1 | 31 (21, 46) | 50 (42, 55) | 214 (141, 287) | 107 (101, 118) |
Brown、Cai、DasGupta、Interval Estimation for a Binomial Proportion(Statistical Science 16(2)、2001)。統計学の学術誌の論文で、この講座の区分では R レベルです。この回が読んだのは要旨です。二項比率とは「n 回のうち何回成功したか」という形のデータの比率で、成功率はまさに二項比率です。動画の「Wald→Wilson」の数字カードは、要旨の二文に当たります。それぞれ独立に抜き出します。
We begin by showing that the chaotic coverage properties of the Wald interval are far more persistent than is appreciated. Furthermore, common textbook prescriptions regarding its safety are misleading and defective in several respects and cannot be trusted.
Based on this analysis, we recommend the Wilson interval or the equal-tailed Jeffreys prior interval for small n and the interval suggested in Agresti and Coull for larger n.
「カバー率」とは、同じ方法で評価と区間の計算を何度も繰り返したとき、区間が本当の成功率を含む割合のことです。名目 95% の区間なら、カバー率は 95% に近いはずです。要旨は、Wald 区間のカバー率の性質が混沌としていて、それが思われているよりずっと根強いこと、そして教科書にある「いつなら安全か」の経験則は信頼できないことを述べています。
| 動画の数字 | 出典 | 原文の条件 | 原文が述べていないこと | レベル |
|---|---|---|---|---|
| 10 回 | Henderson ら、Random Seeds and Trials の節 | 同じハイパーパラメータで乱数シードだけを変えて 10 回走らせ、5 回ずつ二組に分けて平均。対象は強化学習の学習結果 | ロボットの成功率の評価ではない。論文は、推奨できる具体的な回数は示せないとしている | R(著者の報告) |
| 10,000 回 | Henderson ら、表 3 の説明 | 一部の環境実験の平均リターンについて、ブートストラップの平均と 95% 信頼限界。10k 回のブートストラップ反復、pivotal 法 | 対象はリターンで、成功率ではない。読んだ部分は pivotal 法を定義しておらず、表 3 の説明は各セルの試行回数を書いていない | R(著者の報告) |
| Wald→Wilson | Brown、Cai、DasGupta、要旨 | 二項比率の区間推定。Wald のカバー率の性質は混沌としている。小さな n には Wilson か等裾の Jeffreys 区間、大きな n には Agresti と Coull の区間を推奨 | 要旨は「小さな n」の境目を示しておらず、各区間の式も書いていない | R(学術誌の論文) |
この表を読むときの注意です。Henderson らが調べたのは学習の偶然性で、扱う数はリターンです。Brown らが調べたのは二項比率の区間で、扱う数は成功率のような比率です。動画が二つを同じ回に入れたのは、どちらも「ひとつの数の裏にどれだけの不確かさがあるか」という同じ問いに答えているからです。二つの資料の数字は、互いに換算できません。
ログインすると、このレッスンの続きと確認問題、解答を読めます。
制約と注意点
- Henderson ら(arXiv 1709.06560、HTML v1、2017-09-19 投稿)は R レベルのプレプリントです。この回が読んだのは、要旨、序論、実験の設定、ハイパーパラメータの節の表 1、表 2、表 3、そして「Random Seeds and Trials」の節の図 5 の説明の冒頭までです。10 回を二組に分ける実験、10k 回の pivotal 法のブートストラップ、表 3 の数字は著者の報告で、本サイトは再現していません。読んだ部分は pivotal 法を定義しておらず、表 3 の説明は各セルの試行回数を書いていません。
- Brown、Cai、DasGupta(Statistical Science 16(2)、2001)は R レベルで、この回は要旨だけを読みました。Wald と Wilson の式はこの回が使う標準的な形で、要旨には書かれていません。要旨は「小さな n」の境目も示していません。
- 次はこの回の導出、読み方、助言です。Wilson の中心を「真ん中へ引き寄せる」と読む式の読み方。すべて成功したときの Wilson の下限 n/(n + z²)。計画の式 n ≈ z²·p(1−p)/E²。失敗ゼロの上限 1 − 0.05^(1/n) と 3/n の近似。独立な二つの推定値の差の半幅。10/10 と 9/10 のときのブートストラップの分位点の導出。「まとめた区間はシードどうしの違いを含まない」「結論で止めるのはデータの選り好みの変形」などの判断。走らせる前に判定基準、場面、シード、回数を書いて決めておくという助言。
- 第 2〜5 節の方策 X、Y、A、B、C、N、ロボットアーム M、チーム Q、そしてすべての回数、成功回数、時間、作業時間、シードごとの結果は架空です。0.640、0.722、9.5% などの本文の例の数字や、練習で計算するすべての値は、これらの仮定のもとでだけ成り立ち、論文やどのシステムのデータでもありません。
- この回は動画の Notebook を実行しておらず、そのカバー率の曲線、半幅の曲線、100 回で失敗ゼロの例に表示される数字を確かめていません。
- 区間の重なりは大まかな読み方にすぎず、動画もそれが厳密な「差がない」判定ではないと説明しています。厳密に比べるには差の区間か検定が必要で、この回は具体的な検定の方法には立ち入っていません。
- 区間が表すのは、評価した場面、判定基準、回数のもとでの不確かさだけです。失敗ゼロのあとの上限は安全の証明ではなく、区間の計算とシミュレーションの結果は、ハードウェアの安全性の検証ではありません。
リンク
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)
- フィジカルAIラボ 2.7:安全フィルター――制御バリア関数による修正を一歩手で計算し、入れるループと残すべき安全の余裕を求める
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- Henderson ら:Deep Reinforcement Learning that Matters(arXiv 1709.06560、HTML v1)
- Brown、Cai、DasGupta:Interval Estimation for a Binomial Proportion(Statistical Science 16(2)、2001)