
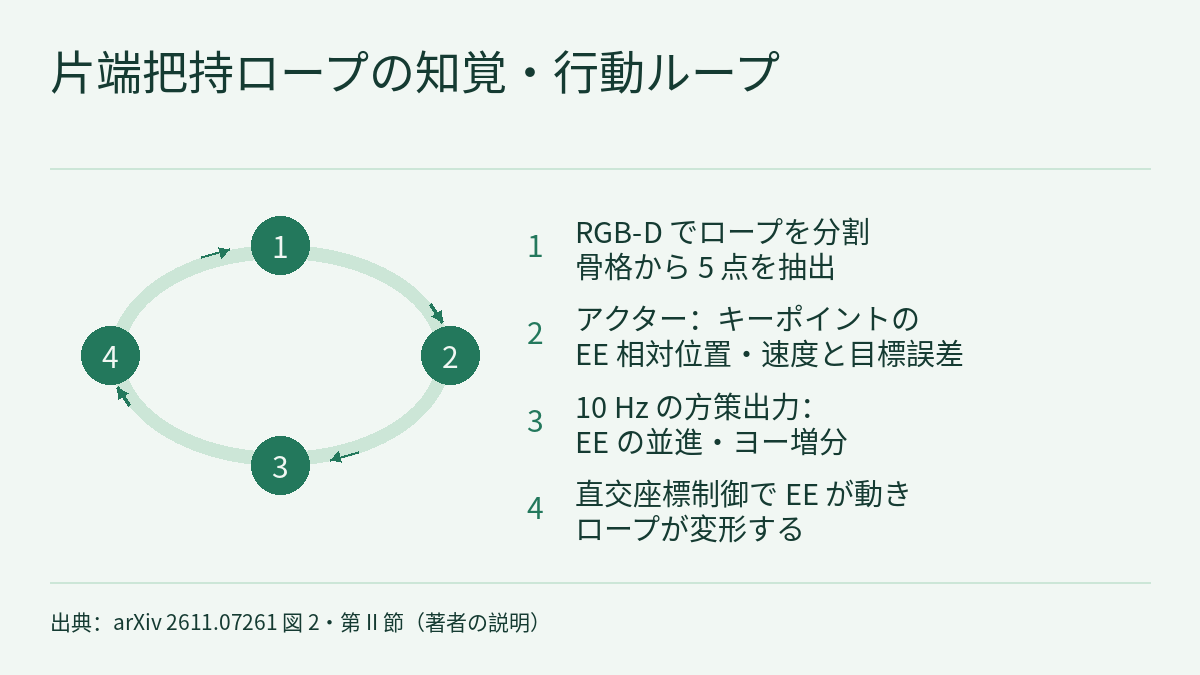
プレプリント An Empirical Study of Reinforcement Learning for Keypoint Positioning of Deformable Linear Objects(arXiv 2611.07261、2026-11-05、イタリア技術研究所 IIT の HRII ラボ)は、狭いながらもよくある問題を扱います。ロボットがロープやホースのような変形線状物体(DLO)の一端を把持し、テーブル上でその上の指定点を目標位置へ動かす問題です。論文は実証研究で、PPO を使って学習スタック、観測設計、ロバスト化学習、実機への移行を一つずつ検証しています。著者の報告では、実機でのファインチューニングなしに、マーカーレスの RGB-D キーポイント推定を用いて、単一点追従、外乱からの回復、2 点追従でそれぞれ 9/10、10/10、8/10 回成功しました。以下の数値はすべて著者の報告 [R] で、本サイトでは再現していません。
タスク:片端把持、平面内、低速
ロープの一端は Franka Emika Panda のエンドエフェクタ(EE)に固定され、もう一端は自由です。直交座標コントローラは、EE の動きを xy 平面内の並進と z 軸まわりの回転に限定します。論文は動作を低速の平面運動に限り、制御のレベルでは準静的として扱い、動的効果を無視しています。方策は毎ステップ、2 つの並進増分と 1 つのヨー増分からなる正規化された 3 次元の行動を出力し、固定のスケール係数を掛けます。方策は 10 Hz、物理シミュレーションは 1 kHz で積分され、学習エピソードは最大 200 制御ステップ(20 s)です。
タスクは 2 つあります。単一点追従ではロープの自由端のキーポイントを目標へ運びます。2 点追従ではさらに、EE に固定された側のキーポイントもそれぞれの目標へ運びます。到達の判定は距離 ε = 0.03 m 以内です。2 点タスクの報酬は段階的です。自由端の誤差は常に罰せられ、EE 側キーポイントの誤差は自由端が目標領域に入ってから初めて罰せられます。自由端が目標領域を出ると、報酬は再び自由端の回復を優先します。この設計は、後で述べる失敗の類型と直接関係します。
学習スタック:学習器の高速化より並列シミュレーションが効いた
論文は 3 つの完全な PPO 学習スタックを比較しています。PyTorch の Stable-Baselines3 と CPU 上の MuJoCo(SB3+mj、並列環境 4)、シミュレーションはそのままで学習器だけを JAX の Stable-Baselines Jax に替えたもの(SBX+mj)、そして JAX の PPO と JAX ネイティブの MJX シミュレータを GPU 上でまとめて動かし、1024 環境を並列にする MuJoCo Playground(MP)です。各スタックは Optuna で個別に調整し(各試行は 3 つの調整用シード、8 CPU コアと A100 80 GB 1 基)、調整に使っていない 5 つのシードでゼロから学習しました。以降の実験はすべて 8 CPU コアと V100 32 GB 1 基を使っています。
| 学習スタック | 最終成功率 | 成功率曲線の下の面積 |
|---|---|---|
| SB3+mj | 0.860 ± 0.108 | 0.529 ± 0.048 |
| SBX+mj | 0.880 ± 0.110 | 0.532 ± 0.069 |
| MP | 0.950 ± 0.032 | 0.735 ± 0.077 |
約 240 分の共通の実時間予算の中で、MP は平均成功率 0.95 に達し、CPU の 2 スタックは中程度の成功にとどまったと著者は報告しています。同じ時間で MP が集めた環境との相互作用は約 13 倍でした。学習器だけを替えた SBX+mj は SB3+mj とほとんど差がなく、著者は DLO の物理シミュレーションが依然としてボトルネックだったためと説明しています。環境数の差は 256 倍(1024 対 4、本サイトの計算)なのに相互作用の差は約 13 倍なので、「環境をいくつ開いたか」をそのままスループットとみなすことはできません。著者も、3 つのスタックは学習フレームワーク、シミュレーションのバックエンド、並列度、ハードウェアが同時に異なり、これはシステム全体の比較であって、個々のアルゴリズムやシミュレータの統制された比較ではないと明記しています。
観測設計:相対キーポイントと非対称 actor–critic
展開時に方策が得られるのは視覚で推定したキーポイントだけなので、アクターは 5 点のキーポイントだけを見ます。クリティックは学習中に 12 点のキーポイントと、シミュレータだけが持つ特権情報(指令のクリッピング量、ロボットの作業空間や作業領域からの逸脱を示す量)を受け取ります。キーポイントは EE に対する相対位置と相対速度で表し、これに自由端のロボットベース座標系での絶対位置を加えます。論文の式 (1)、(3) から、2 点タスクのアクター観測は 37 次元、クリティック観測は 70 次元です(本サイトの計算)。
アブレーションは単一点タスクで行い、4 つの組み合わせをそれぞれ約 2000 万ステップ、2 シードで学習しました。著者の報告では、EE 相対の表現はロボットベース座標系の表現より学習がよく、非対称 actor–critic は対称のものより優れ、「相対 + 非対称」が全体として最もよい結果でした。そのため以降のシミュレーションと実機実験ではすべてこの構成を使っています。本文はこのアブレーションについて学習曲線の図だけを示し、数値は示していません。
ロバスト性:1 つの成功率より、対応づけた比較と失敗の分解が多くを語る
ロバスト化学習(N+DR)では、アクターが観測する位置、速度、ヨー、ヨー角速度に毎ステップ平均 0 のガウスノイズを加え、最大 1 制御ステップのランダムな遅延も入れます。エピソードごとに、ロープとテーブルの間の滑り摩擦係数 μ ∈ [0.5, 0.8] と、関節剛性、アクチュエータ減衰、受動減衰のスケール係数(それぞれ 0.95〜1.05)をランダム化します。外乱回復の学習では、さらにランダムな時刻に外力を加えます。曲げ剛性とねじり剛性はランダム化していません。使用した MP のプラグインが実行時の変更に対応していないためです。各条件は 250 エピソード(評価シード 5 × 50 エピソード)で評価しています。
| タスク | 条件 | 成功 / 250 | 成功率 |
|---|---|---|---|
| 単一点 | Basic | 249 | 99.6% |
| 単一点 | N+DR | 241 | 96.4% |
| 単一点(外乱回復) | N+DR+D | 245 | 98.0% |
| 2 点 | Basic | 231 | 92.4% |
| 2 点 | N+DR | 222 | 88.8% |
外乱を加えたほうがわずかに高いことを、著者は外乱が有益だという証拠とはみなしていません。2 つの条件は同じ目標と初期状態を使うので、エピソードごとに対応づけられます。結果が変わらなかったのが 238 エピソード、失敗から成功に変わったのが 8、成功から失敗に変わったのが 4 でした。著者は、学習中に外力がときどき自由端を目標の方へ押したことが差を部分的に説明する可能性があると述べ、結論を「ロバスト性は保たれている」に限定しています。2 点タスクも同様に対応づけられ、両条件で成功が 213 組、Basic だけで成功が 18 組、N+DR だけで成功が 9 組、両方で失敗が 10 組でした。したがって N+DR がもたらしたのは小幅な正味の低下で、一様な能力の低下ではありません。
N+DR での 2 点タスクの失敗 28 回はすべてタイムアウトです。類型別では、自由端が一度も目標に届かなかったもの(Type-1)が 19 回で 67.9%、自由端は届いたが EE 側キーポイントが届かなかったもの(Type-2)が 2 回で 7.1%、自由端が一度届いたが終了時には離れていたもの(Type-3)が 7 回で 25.0% でした。失敗は作業空間の縁に集中しています。どちらかの目標が許容領域の境界から 0.05 m 以内にある「周縁」の目標ペアは 250 エピソードの 44.4% ですが、失敗の 78.6% を占めます。周縁と内側の失敗率はそれぞれ 19.8% と 4.3% です。目標間の距離が大きいほど難しく、0.10 m 未満、0.10〜0.20 m、0.20 m 以上での成功率はそれぞれ 92.7%、90.9%、83.1% でした。著者はこれを記述的な関連と呼んでいます。
これとは別に、0.300、0.375、0.450 m の 3 種類のロープ長で同時に学習した単一点方策は、各長さで 84.4%、86.0%、86.4% の成功率でした。3 種類とも学習に含まれているので、これは分布内でのロバスト性の測定で、見たことのない長さへの外挿ではありません。本文にはこの評価の条件が書かれていないため、本サイトでは固定長の方策の 96.4% と直接は比較しません。
実機:ファインチューニングなしの 30 試行
作業空間の上に取り付けた Intel RealSense D435i が 30 Hz で画像を供給します。カメラは ArUco による外部パラメータ校正でロボットベース座標系に合わせ、知覚と制御のパイプライン全体は ROS で統合しています。ファインチューニングした YOLO26-seg でロープを分割し、マスクを骨格化して中心線に沿ってほぼ等間隔に 5 点のキーポイントを取り、テーブル面に投影します。著者は分割について、マスクの適合率 98.81%、再現率 99.13%、F1 98.97%、mAP@0.5 99.48%、mAP@0.5:0.95 79.30%、推論 29.8 FPS と報告しています。方策はネットワークを変えず、実機でのファインチューニングもせず、10 Hz のまま動かしました。
主評価は直径 0.004 m のシリコン製カテーテルを使い、3 つのタスクを各 10 回行い、すべての試行を結果に含めています。
| タスク | 成功 | 成功試行の完了時間の中央値 [IQR] | 失敗の類型 |
|---|---|---|---|
| 単一点追従 | 9/10 | 9.30 s [6.70, 14.40] | Type-1 |
| 外乱回復 | 10/10 | 6.55 s [4.85, 8.32] | — |
| 2 点追従 | 8/10 | 自由端の到達 8.55 s [7.19, 12.30]、タスク完了 9.05 s [7.80, 12.47] | Type-3 |
2 点タスクでは、自由端が到達してから目標全体を達成するまでの追加時間は中央値わずか 0.56 s [IQR 0.17〜2.02 s] でした。2 回の失敗はどちらも自由端が目標に届いてから離れたもので、シミュレーションの Type-3 と同じ仕組みです。著者は実機での失敗の原因を 3 つにまとめています。ロボット自身がロープを隠すことがあり、短い遮蔽なら目標付近で有効な観測が戻ると回復できましたが、長い遮蔽では誤った行動につながりました。カテーテルは非常に柔らかく、ときどき急に曲がって蓄えた弾性エネルギーを放出し、目標同士が近い 2 点の配置で突然はね返りました。知覚の遅延で方策が目標を行き過ぎることもありましたが、ノイズと遅延を入れた学習でこれが軽減され、いくつかの試行では回復できたと著者は述べています。
本サイトの講座との関係
フィジカルAIラボ 0.4 と 1.4 では、GPU 並列シミュレーションの高速化の数字と、どの倍率にも比較対象を書く必要があることを扱いました。この論文は変形物体での例を加えます。学習器だけを速くしてもほとんど効果がなく、シミュレーションまで並列化して初めて差が開きました。しかも報告しているのは、同じ実時間予算での成功率と相互作用の量で、単一の高速化倍率ではありません。
フィジカルAIラボ 2.5 では、ドメインランダム化ではモデルのどの量をどの範囲で変えるかを明記すべきだと述べました。この論文は摩擦の範囲、剛性と減衰のスケール、観測ノイズと遅延を書き、曲げ剛性とねじり剛性はランダム化できなかったことも明記しています。実機でカテーテルが急に曲がってはね返った失敗は、この点と並べて読めます。ただしこれは本サイトの読み方で、論文はこの失敗をランダム化されなかった剛性に帰してはいません。10 Hz での最大 1 制御ステップの遅延は 0.1 s に相当します(本サイトの換算)。遅延と制御周波数の関係は 2.6 を参照してください。
フィジカルAIラボ 1.8 では「差し引き」を対応表に分解する練習をしました。この論文の 8 対 4、18 対 9 はまさにその読み方です。全体の成功率が数ポイントしか違わないときは、まず実際に結果が変わったエピソードがいくつあり、どちらの方向に変わったかを見ます。段階的な報酬が行動をどう形づくるかは 1.7 と照らし合わせてください。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者の報告 [R] です。本サイトでは再現していません。本サイトが読んだ本文には、コードやデータセットのリンクはありません。
- 実機は各タスク 10 試行のみで、シリコン製カテーテル 1 本だけを使っています。論文は実機結果の信頼区間を示しておらず、本サイトが読んだ本文にはカテーテルの長さも書かれていません。シミュレーションの既定のロープ長は 0.30 m です。
- タスクは平面内、低速、片端把持に限られ、準静的として扱われています。著者は形状制御、3 次元操作、見たことのない DLO・環境・タスク設定への汎化を今後の課題に挙げています。
- 学習スタックの比較は学習フレームワーク、シミュレーションのバックエンド、並列度、ハードウェアを同時に変えており、著者は単一の構成要素の統制された比較ではないと明言しています。観測のアブレーションは 2 シードだけで、本文には曲線だけがあり数値はありません。
- 方策はタスクごとに学習されています。観測の次元は追従点の数 M によって変わるため、M ごとに別の方策を用意します。可変長の実験は学習で見た 3 種類の長さだけを対象にしています。
- 分割の指標を測ったテストセットの規模と分け方は、本サイトが読んだ本文には書かれていません。
- 実機試行が検証したのはタスクの成功で、安全性の検証ではありません。シミュレーションの成功率は実機テストの代わりになりません。
リンク
- An Empirical Study of Reinforcement Learning for Keypoint Positioning of Deformable Linear Objects(arXiv 2611.07261)
- 論文の HTML 全文
- フィジカルAIラボ 0.4:仮想の世界で一万回練習――シミュレーションの 3 つの数字に実験条件を戻す
- フィジカルAIラボ 1.4:シミュレータの地図――刻み幅のコストを数え、接触で軌道が分かれる点を読み、3 つの高速化の比較対象を確かめる
- フィジカルAIラボ 1.7:強化学習――1 回分の収益を手で計算して報酬の抜け道を見つけ、論文の地形カリキュラムとタイムアウト時のリセットを読む
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フィジカルAIラボ 2.5:sim2real のドメインランダム化とシステム同定――二本の論文の数字を元の設定に戻し、コップを押した一本の軌跡から摩擦を手で求める
- フィジカルAIラボ 2.6:エッジへ――遅延のログから制御周波数の上限を求め、量子化で減るのが容量か時間かを見分け、動作チャンクの長さを決める
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)


