
プレプリント Failure Prediction and Classification in Vision-Language-Action Models via Calibrated Latent Probing(arXiv 2611.08425、2026-11-05、著者は University of Texas at Austin、Tufts University、University of Texas at Dallas の所属)は VLA-Tug を提案しています。VLA のバックボーンの潜在層の埋め込みに 6.6M パラメータの小さなプローブを付け、失敗が起きる前に警報を出し、起こりそうな失敗の種類を示し、しきい値を誤報率と「早期検出率」の両方を同時に抑えるよう較正します。注目すべきは評価の方法です。警報が「間に合った」かどうかを注釈付きの失敗時刻に照らして判定し、較正は目標を満たせないときに棄権できます。要旨の百分率を読むときは注意が必要です。30% と 44% はどちらも相対的な改善で、86% の分母は較正が棄権しなかった実行だけです。以下の数値はすべて著者の報告 [R] で、本サイトでは再現していません。
実行時モニターが答えるべき 3 つの問い
論文は失敗検知器をいくつかの一般的な概念に分けています。各制御ステップ t に失敗スコア s_t(厳密な意味での確率である必要はありません)としきい値 h⋆ があります。検知時刻 t_det はスコアが初めてしきい値を超えた時刻です。失敗時刻 t_fail(著者は failure onset とも呼びます)は、方策が明らかな誤りを犯すか、人や別の仕組みが介入しなければならないほど進行が止まる時刻で、この定義は SAFE(Gu ら、2025)に従っています。失敗モードは、把持の失敗、配置の失敗、進行なしといった高レベルの意味的なカテゴリーです。著者が求めるのは t_det ≤ t_fail、つまり失敗の前に警報を出すことです。
著者は既存手法に 3 つの不足があると見ています。第一に、AUROC やバランス精度は固定の時点で評価されることが多く、警報が実際の失敗時刻より前に出たかを確かめていません。第二に、ほとんどの手法はスカラーのリスクスコアしか出さず、どの種類の失敗かを示さないため、原因に合わせた補正ができません。第三に、較正は通常 1 つの基準しか制御しません。誤報率(FPR、成功したロールアウトを失敗と誤判定する割合)は保証しても、真陽性率(TPR、失敗を検出できた割合)は保証しません。著者は、1 回の失敗で人がけがをしたり設備が壊れたりしうる場面では、後者も少なくとも同じくらい重要だと主張します。論文の表 1 は SAFE、ActProbe、STAC、FailureSpot と 7 つの VLA ステアリング手法を項目ごとに比べ、著者の整理では、FPR と TPR の形式的保証、失敗時刻に基づく評価、失敗モードの予測をすべて備えるのは VLA-Tug だけです。
プローブ:どの層を読み、失敗ロールアウトにどうラベルを付けるか
入力は VLA バックボーンの潜在埋め込みです。π0.5 では第 18 層(正規化の後)、GR00T-N1.7 では第 16 層を使い、分析の中心は後者です。各方策ステップで 3 つのモダリティ(エージェントカメラ、手首カメラ、指示文)のトークンをそれぞれ平均し、3 つの 2048 次元ベクトルを連結して 1 つの 6144 次元の埋め込みにします。隠れユニット 256 の単層 LSTM がこれらの埋め込みを順に読み、それぞれ 64 個の ReLU ユニットの隠れ層を 1 つ持つ 3 つの MLP ヘッドが同じ隠れ状態を読みます。失敗スコアのヘッド、10 種類の失敗モードの分布を出すヘッド、そして隠れ状態を現在の動作の説明の CLIP テキスト埋め込みにそろえる補助ヘッドです。著者は、推論時にはこの補助ヘッドは 64 次元の出力にすぎず、CLIP エンコーダーは動かないと明記しています。
中心となる仮説は、失敗後の埋め込みで学習すると、プローブは「すでに失敗した軌道がどう見えるか」を学び、「これから失敗する軌道がどう見えるか」は学ばない、というものです。著者は失敗ロールアウトの 4 通りのラベル付けを比べています(成功ロールアウトはすべてのステップが 0)。
- pre-onset:t_fail より前のすべてのステップを 1 とし、その後のステップは損失から除外します。VLA-Tug が採用する方式です。
- onset:t_fail の直前の幅 w の窓だけを 1、それより前を 0 とし、その後は除外します。
- post-onset:t_fail − w 以降をすべて 1、それより前を 0 とし、失敗後のステップも残します。
- trajectory:失敗ロールアウトのすべてのステップを 1 とします。SAFE のラベル付けです。
最初の 2 つは失敗後のステップを 0 とせずに失敗時刻で打ち切ります。それらの埋め込みはすでに失敗したロールアウトのものであり、成功とラベル付けすると矛盾した学習信号になるからです。窓 w は 2.4 s です(LIBERO の GR00T では 6 方策ステップ、実機では 20 ステップ、π0.5 では 10 ステップで 2.5 s)。著者は付録でラベルのアブレーションを行い、ほかの 3 方式に替えると LIBERO-X での早期検知が下がると報告しています。
データは π0.5 と GR00T-N1.7 の 2 つの方策のロールアウトで、3 つのシミュレーション・ベンチマーク(LIBERO、LIBERO-Occ、LIBERO-X)と実機タスクから集めています。論文によれば、シミュレーションのタスクは 2 つのシミュレーション環境で計 228 種類、実機タスクは 8 種類です。ラベルは Gemini(gemini-3.5-flash)がロールアウトの動画から生成します。すべてのロールアウトに 3 秒の窓ごとのキーワードによるタイムラインが付き、失敗ロールアウトにはさらに失敗モード(10 種類のいずれか)と失敗時刻が付きます。著者によると、ラベル付けの費用は失敗エピソード 1 件あたり約 1 セント、全注釈で 50 ドル未満(この総額には本論文で使っていない問い合わせも含まれます)で、3,180 エピソード、288,000 件を超えるバックボーン埋め込みのデータセットを公開しています。本文には、これらの自動ラベルと人手の注釈の一致率は報告されていません(少なくとも本サイトが読んだ範囲にはありません)。
早期検知:「30%」は相対的な改善
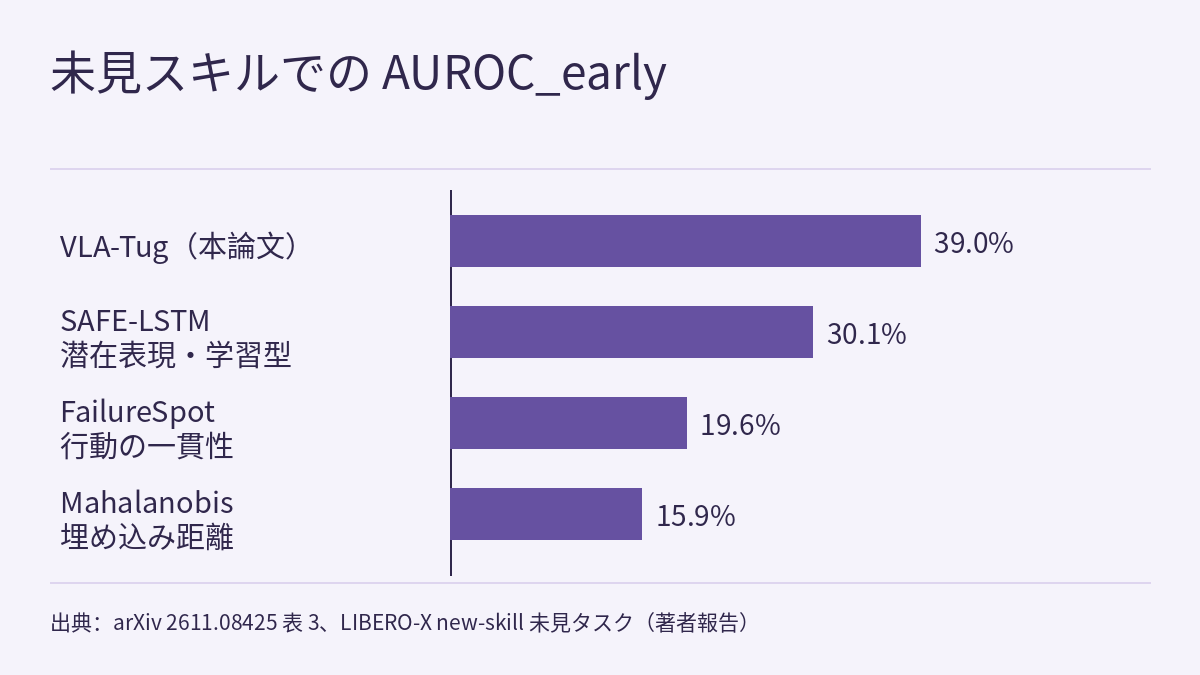
評価指標は著者が定義した AUROC_early です。TPR_early(t_fail の時点またはそれ以前に警報が出た失敗の割合)を FPR に対してプロットし、FPR が 0 から 0.4 の範囲の面積を 0.4 で割って百分率で表します。著者の理由は、成功ロールアウトの 40% を超えて誤報を出す検知器は配備できない、というものです。タスクは「既知」と「未見」に分けられます。LIBERO-X の 3 つの分割は順に分布シフトが大きくなります。new-task は個々のタスクを、new-signature はスキル・対象・関係などの要素の組み合わせを、new-skill はスキル 1 種類をまるごと評価用に残します。下の表は論文の表 3 の「未見タスク」の列から抜き出したもので、表にある 9 手法のうち 5 手法だけを載せ、STAC、ActProbe、Euclidean、PCA-KMeans は省いています。各セルはその設定の分割の平均です。
| 手法(種類) | LIBERO-10 π0.5 | LIBERO-10 GR00T | LIBERO-X new-task | LIBERO-X new-signature | LIBERO-X new-skill | 実機 |
|---|---|---|---|---|---|---|
| VLA-Tug(本論文) | 47.9 | 47.4 | 40.2 | 47.0 | 39.0 | 25.8 |
| SAFE-LSTM(潜在表現・学習型) | 34.9 | 51.2 | 40.4 | 41.2 | 30.1 | 25.1 |
| SAFE-MLP(潜在表現・学習型) | 39.9 | 39.2 | 42.3 | 46.2 | 23.5 | 20.2 |
| FailureSpot(行動の一貫性) | 36.2 | 44.7 | 20.4 | 26.2 | 19.6 | – |
| Mahalanobis(埋め込み距離) | 40.2 | 29.2 | 30.6 | 22.3 | 15.9 | 19.6 |
要旨の「最大 30% の改善」は new-skill の列に対応します。39.0 対 SAFE-LSTM の 30.1 で、本サイトで計算すると約 1.30 倍、絶対差は 8.9 ポイントです。著者は、最も強い学習型ベースラインである SAFE-LSTM との差がシフトの拡大とともに広がると報告しています。new-task で −1%、new-signature で +14%、new-skill で +30% です。表からはさらに 2 点が読み取れます。new-signature では VLA-Tug が最良ですが、SAFE-MLP との差は 0.8 ポイントにすぎません。new-task で最良なのは SAFE-MLP です。著者自身も、実機での差は小さいこと、LIBERO-10 の GR00T では VLA-Tug が首位でないこと、既知タスクでの結果はまちまちであることを書いています。もう 1 つ目立つのは、Mahalanobis が LIBERO-10 π0.5 の既知タスクで 85.7 なのに未見タスクでは 40.2 に下がる点で、既知と未見の差は大きくなりえます。表にはシード間のばらつきは示されていません。
較正:誤報と見逃しを同時に抑え、できなければ棄権する
VLA-Tug は Learn-then-Test(LTT、Angelopoulos ら、2022)でしきい値を選びます。利用者が誤報の上限 α と早期検出の下限 β を決め、LTT は較正セット上で各候補しきい値を検定します。残ったしきい値はいずれも、少なくとも 1 − δ の確率で FPR ≤ α と TPR_early ≥ β を同時に満たし、その中から TPR_early が最も高いものを選びます。付録によれば、2 つの損失はどちらも 2 値なので p 値は厳密な二項分布の裾確率で計算し、候補しきい値は 181 個、開始点 40 の多開始点の固定順序検定を使い、δ = 0.1 です。どのしきい値も通らなければ LTT は棄権します。比較対象の max-conformal(MC)と functional conformal(FC)はどちらも FPR だけを保証し、論文によれば MC は常にしきい値を返します。
実験は LIBERO-X の 14 回の実行(new-task のシード 3 個、new-signature のシード 3 個、new-skill の 8 分割)で行い、FPR の目標は 10% から 50% までの 7 通りで、それぞれに TPR_early の目標を組み合わせています。著者の報告は次のとおりです。
- 既知タスクでは、LTT の 2 つの目標は認証されたすべての実行で成り立ちました。MC が FPR の目標を満たしたのは実行の 57–71% だけでした。
- 未見タスクでは、FPR の目標が認証済みの実行の 40–86% で成り立ちました。TPR_early の目標は未見タスクの実行の 57–90% で成り立ちました(論文 6.2 節の表現)。MC は最大で 21% です(貢献の一覧ではベースラインについて 0–21% と書かれています)。
- LTT は目標に応じて 14 回中 4–7 回で棄権しました(FPR の目標 15–50%)。著者はこれを、配備の前に、要求された率をこのモデルでは支えられないと利用者に伝えるものと解釈しています。
分母に注意が必要です。本サイトの読みでは、「認証済みの実行」には LTT が棄権した 4–7 回が含まれず、MC は棄権しないので、86% と 21% は同じ実行の集合に対する割合ではありません。棄権はそれ自体が有用な情報ですが、その設定では使えるしきい値が得られないことを意味します。著者はまた、未見タスクのサンプルは較正セットと交換可能ではないため、保証は経験的にしか成り立たず、それは 3 手法とも同じだと明記しています。これらの割合は 14 回の実行から得た傾向で、精密な率ではありません。
TPR に下限があれば、警報が本当の失敗を意味する確率、すなわち陽性的中率(PPV)に保守的な下限を与えられます。論文はベイズの定理から PPV ≥ π·β / (π·β + (1 − π)·α) を導いています。π は失敗の事前の割合で、下限は π とともに大きくなるので、π の下限の見積もりがあれば十分です。著者は、この PPV の下限が完全な表の各 FPR 目標で 58–71% であり、既知タスクでは認証済みのすべての実行で、未見タスクでは実行の 70–100% で成り立ったと報告しています。本サイトが読んだ本文には、ここで使った π の値は書かれていません。本サイトが仮定した数値で π の影響を見てみます。α = 0.1、β = 0.8 のとき、π = 0.3 なら下限は約 77% ですが、失敗がもっとまれな π = 0.05 では約 30% にとどまります。同じプローブ、同じしきい値でも、警報の意味は配備先で失敗がどれだけ起こるかによって変わります。
失敗の種類、コスト、ステアリングのデモ
失敗モード。失敗のクラスは大きく偏っているため、著者はバランス精度を報告し、常に最も多いクラスを答える多数派ベースラインと比べています(既存のベースラインはどれも失敗モードを予測しません)。LIBERO-X では、top-1 精度が多数派ベースラインに対して既知タスクで最大 149%、未見タスクで最大 79% 改善し、top-3 はそれより小さいものの一貫した改善です。要旨では、未見タスクでの top-3 の改善を最大 44% としています。実機では top-1 が既知タスクで 171%、未見タスクで 8% 改善しました。いずれも相対的な改善で、本サイトが読んだ本文には精度の絶対値はありません。著者は、失敗を 3 つの候補クラスに絞り、その中で最もリスクの高いクラスに合わせて停止、再試行、人への引き継ぎを選ぶ使い方を勧めています。
コスト。著者の報告では、RTX 4090 1 枚での学習は 6.8 s(SAFE-LSTM は 43.5 s)、パラメータは 6.6M で 26.5 MB、VLA の約 0.2% です。較正は目標の組 1 つあたり CPU で 2 ms 未満です。LIBERO-X では VLA は 1 回の呼び出しで 8 個の動作を出力して 20 Hz で実行するので、1 方策ステップは 400 ms です。プローブが加える時間は 1 ステップあたり GPU で 0.12 ms(GR00T の 54 ms の方策呼び出しの 0.2%)、4 つの CPU スレッドで 0.9 ms です。比較として、表 3 では STAC が GPU で 1 ステップ 21.30 ms かかり、Mahalanobis と Euclidean のスコア計算用の状態はそれぞれ 302.0 MB と 3056 MB です。
ステアリング。論文は 2 つの例を示しています。シミュレーションの「最も大きなボウルを水切りかごの左の区画に入れる」では、ボウルが右の区画に置かれる前にプローブが警報を出し、エンドエフェクターを左へ寄せてから方策を再開するとロールアウトは成功します。実機の「マッシュルームを皿に置く」では、プローブが把持の失敗が迫っていると予測し、VLA を一時停止して、エキスパートモデルが軌道を成功するものに移してから VLA を再開します。シミュレーションでの補正ツールは、失敗モードごとのヒューリスティックです。著者は、ステアリングの部分はヒューリスティックであり本論文の評価範囲外だと明言しており、2 つの例は概念実証です。要旨の「タスク成功率を高める軽量なステアリングを支える」という一文について、本文に成功率の統計はありません。
本サイトの講座やレーダー記事との関係
フィジカルAIラボ 2.8:再現できる評価 では、二項比率の区間と、失敗ゼロのあとの失敗率の上限の求め方を扱いました。ここで LTT がしているのも同じ種類のことです。較正セットの「見逃した失敗」と「成功への誤報」をそれぞれ二項分布の件数として扱い、厳密な裾確率でしきい値を認証できるかを決めます。違いは、LTT が 2 つの比率について同時に結論を出し、根拠が足りなければしきい値を出さないことです。2.8 では、区間はその試行の回数・判定基準・条件だけを表すと強調しました。ここではそれが交換可能性の仮定として直接現れ、未見タスクに移ると保証は経験的な意味しか持ちません。
フィジカルAIラボ 1.8:評価 では失敗へのラベル付けを練習しました。VLA-Tug の結論は t_fail と失敗モードという 2 種類のラベルに依存し、どちらも動画モデルが自動で生成しています。ラベルの定義が変われば、AUROC_early も TPR_early も変わります。
フィジカルAIラボ 2.7:安全フィルター が扱うのは別の層です。CBF フィルターは最も速い制御ループに置かれ、ステップごとに動作を修正し、その保証はモデルに対して成り立ちます。VLA-Tug は方策ステップの周期(ここでは 1 ステップ 400 ms)で動き、「失敗しそうで、おそらくこの種類」という情報を出します。決めるのはいつ一時停止するか、誰に引き継ぐかであり、動作を直接制約するものではありません。両者は別の問いに答えており、互いに代わりにはなりません。
以前レーダーで取り上げた RESETTLE は、凍結した方策の 2 つの動作サンプルが食い違い続けるかどうかで回復を起動します。論文の関連研究とベースラインの節でいう「行動の一貫性」に属する信号です。VLA-Tug はその代わりにバックボーンの埋め込みを読み、しきい値の較正と失敗時刻に基づく評価を論文の中心に据えています。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者の報告 [R] です。本サイトでは再現していません。本サイトが読んだ HTML 本文は付録 A.3 で途切れており、付録 D の完全な較正表とアブレーションは読めていません。
- 著者が挙げる制約:較正の保証は較正エピソードとテストエピソードの交換可能性に依存し、分布シフトが大きくなるほど弱まります(著者によれば経験的には劣化は緩やか)。どのバックボーン層を使うかは体系的に分析していません。ステアリングの部分はヒューリスティックで、評価していません。
- 30%、44%、149% などは相対的な改善で、86% の分母は棄権を除いた認証済みの実行です。引用するときは、ベースライン、設定、分母を併記してください。
- 失敗時刻と失敗モードのラベルは Gemini による動画の自動注釈で、失敗時刻の定義には「人の操作者がいつ介入するか」という判断が含まれます。
- 主な分析対象は GR00T-N1.7 の第 16 層です。実機は 8 タスクだけで、実機の列に数値があるのは学習型と埋め込み距離型の手法だけです。
- 要旨によればデータセットは著者のプロジェクトページ vla-tug.github.io で公開されていますが、本サイトはそのページもデータセットの中身も開いて確認していません。
- どの結果もハードウェアの安全性検証ではありません。失敗予測器が与えるのは一時停止や引き継ぎのタイミングであり、制御層の安全制約や現場の非常停止の代わりにはなりません。
リンク
- Failure Prediction and Classification in Vision-Language-Action Models via Calibrated Latent Probing(arXiv 2611.08425)
- 論文の HTML 全文
- フィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求める
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フィジカルAIラボ 2.7:安全フィルター――制御バリア関数による修正を一歩手で計算し、入れるループと残すべき安全の余裕を求める
- フロンティア・レーダー|RESETTLE:凍結した方策の 2 つの動作サンプルが食い違い続けたときだけ介入し、デモを参照して補正動作を 1 回だけ実行する
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)


