
预印本 Failure Prediction and Classification in Vision-Language-Action Models via Calibrated Latent Probing(arXiv 2611.08425,2026-11-05,作者来自 University of Texas at Austin、Tufts University 与 University of Texas at Dallas)提出 VLA-Tug:在 VLA 骨干网络的潜层嵌入上挂一个 6.6M 参数的小探针,目标是在失败发生之前报警,同时给出可能的失败类型,并把阈值校准成同时约束误报率和“提前检出率”。它值得细读的地方在于评测口径:作者按标注的失败时刻判断报警是否“及时”,校准时允许“做不到就弃权”。读摘要里的几个百分比时要注意,30%、44% 都是相对提升,86% 的分母只包含校准没有弃权的运行。以下数字均为作者报告 [R],本站未复现。
运行时监测器要回答的三个问题
论文把一个失败检测器拆成几个通用概念:每个控制步 t 有一个失败分数 s_t(不必是严格意义上的概率);阈值 h⋆;检测时刻 t_det 是分数第一次越过阈值的时刻;失败时刻 t_fail(作者也叫 failure onset)是策略犯下明显错误、或进展停滞到需要人或其他机制接管的时刻,这个定义沿用 SAFE(Gu 等,2025);失败模式是一个高层语义类别,比如抓取失败、放置失败、没有进展。作者要的是 t_det ≤ t_fail,也就是在失败之前报警。
作者认为,已有方法在三处不够。第一,常用 AUROC 或平衡准确率在固定时间点评估,不检查报警是否早于真实的失败时刻。第二,大多只输出一个标量风险分,不说是哪类失败,后续纠正无从对症。第三,校准通常只控制一个指标:保证误报率(FPR,成功的回合被误判为失败的比例),不保证真阳性率(TPR,失败被检出的比例)。作者的论点是,在一次失败就可能伤人或损坏设备的场合,后者至少同样重要。论文的表 1 把 SAFE、ActProbe、STAC、FailureSpot 和七种 VLA 转向(steering)方法逐项对比,按作者的整理,只有 VLA-Tug 同时具备 FPR 与 TPR 的形式保证、按失败时刻评测和失败模式预测。
探针:读哪一层,失败回合怎样标注
输入是 VLA 骨干的潜层嵌入:π0.5 取第 18 层(归一化之后),GR00T-N1.7 取第 16 层,论文主要分析后者。每个策略步把三种模态(agent 相机、腕部相机、指令)各自的 token 取平均,三个 2048 维向量拼成一个 6144 维的嵌入。一个 256 个隐藏单元的单层 LSTM 依次读入这些嵌入,三个各带一层 64 个 ReLU 单元的 MLP 头读取同一个隐状态:失败分数头、10 类失败模式的分布头,以及一个辅助头,把隐状态对齐到当前动作描述的 CLIP 文本嵌入。作者写明,推理时这个辅助头只是一个 64 维输出,不运行 CLIP 编码器。
核心假设是:用失败之后的嵌入训练,探针学到的是“已经失败的轨迹长什么样”,而不是“即将失败的轨迹长什么样”。作者比较了失败回合的四种标注法(成功回合所有步都标 0):
- pre-onset:t_fail 之前所有步标 1,之后的步不进入损失。这是 VLA-Tug 采用的做法。
- onset:只把 t_fail 之前宽度为 w 的窗口标 1,更早的标 0,之后的不进入损失。
- post-onset:从 t_fail − w 起全部标 1,之前标 0,保留失败后的步。
- trajectory:失败回合的每一步都标 1,这是 SAFE 的标注法。
前两种在失败时刻截断,而不是把失败后的步标成 0,理由是那些嵌入已经属于一个失败的回合,标成成功会给出矛盾的训练信号。窗口 w 为 2.4 s(GR00T 在 LIBERO 上为 6 个策略步,真机为 20 步;π0.5 为 10 步,即 2.5 s)。作者在附录做了标注消融,称换成其他三种会降低 LIBERO-X 上的早期检测。
数据来自 π0.5 与 GR00T-N1.7 两个策略在 LIBERO、LIBERO-Occ、LIBERO-X 三个仿真基准上的回合,加上真机任务;论文称共 228 个不同的仿真任务(两个仿真环境)和 8 个真机任务。标签由 Gemini(gemini-3.5-flash)从回合视频生成:每个回合一条按 3 秒窗口写的关键词时间线,失败回合另有失败模式(10 类)和失败时刻。作者称每个失败回合的标注成本约 1 美分,全部标注不到 50 美元(这一总额也包括本文没有用到的查询),并公开了 3,180 个回合、超过 288,000 条骨干嵌入的数据集。论文正文没有报告这些自动标签与人工标注的一致率(本站读到的部分没有)。
早期检测:“30%”是相对提升
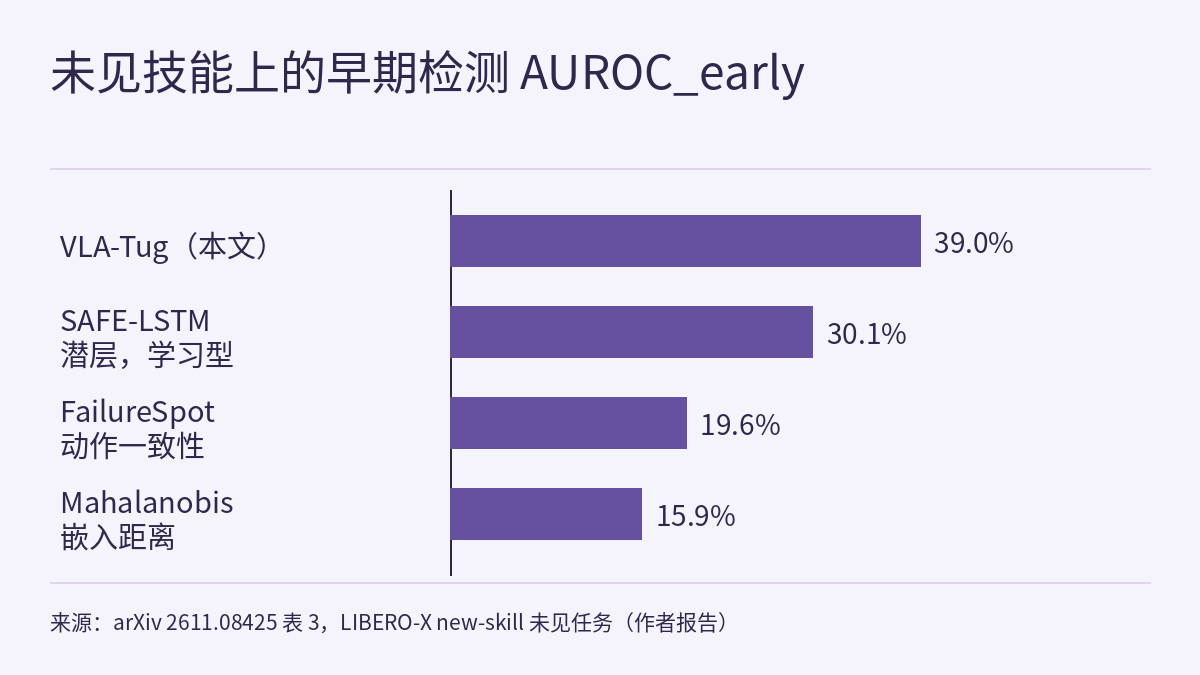
评测指标是作者定义的 AUROC_early:以 TPR_early(在 t_fail 当时或之前就报警的失败所占比例)对 FPR 作曲线,只取 FPR 在 0 到 0.4 之间的面积,再除以 0.4,以百分数表示。作者的理由是,在 40% 以上的成功回合里误报的检测器无法部署。数据按任务划分“见过”和“未见”:LIBERO-X 的三种划分依次加大分布偏移,new-task 留出单个任务,new-signature 留出某种技能、目标、关系等要素的组合,new-skill 留出一整类技能。下表摘自论文表 3 的“未见任务”列,只列出表中 9 种方法里的 5 种,略去了 STAC、ActProbe、Euclidean 和 PCA-KMeans;每格是该设置各划分的平均:
| 方法(类型) | LIBERO-10 π0.5 | LIBERO-10 GR00T | LIBERO-X new-task | LIBERO-X new-signature | LIBERO-X new-skill | 真机 |
|---|---|---|---|---|---|---|
| VLA-Tug(本文) | 47.9 | 47.4 | 40.2 | 47.0 | 39.0 | 25.8 |
| SAFE-LSTM(潜层,学习型) | 34.9 | 51.2 | 40.4 | 41.2 | 30.1 | 25.1 |
| SAFE-MLP(潜层,学习型) | 39.9 | 39.2 | 42.3 | 46.2 | 23.5 | 20.2 |
| FailureSpot(动作一致性) | 36.2 | 44.7 | 20.4 | 26.2 | 19.6 | – |
| Mahalanobis(嵌入距离) | 40.2 | 29.2 | 30.6 | 22.3 | 15.9 | 19.6 |
摘要里的“提高最多 30%”对应 new-skill 这一列:39.0 对 SAFE-LSTM 的 30.1,按本站换算是约 1.30 倍,绝对差 8.9 个百分点。作者报告,相对最强学习基线 SAFE-LSTM 的差距随偏移加大而扩大:new-task 为 −1%,new-signature 为 +14%,new-skill 为 +30%。表里还能读出两点。new-signature 上 VLA-Tug 是最好的方法,但它对 SAFE-MLP 的领先只有 0.8 个百分点;new-task 上最好的是 SAFE-MLP。作者自己写明,真机上领先很小,在 LIBERO-10 的 GR00T 设置上 VLA-Tug 不领先,见过任务上的结果有好有坏。另一个值得注意的现象:Mahalanobis 在 LIBERO-10 π0.5 的见过任务上是 85.7,未见任务上降到 40.2,见过与未见的差距可以很大。表中没有给出跨种子的离散度。
校准:同时约束误报与漏报,做不到就弃权
VLA-Tug 用 Learn-then-Test(LTT,Angelopoulos 等,2022)选阈值:用户给定误报上限 α 和提前检出下限 β,LTT 在校准集上检验每个候选阈值,留下的阈值集合以至少 1 − δ 的概率同时满足 FPR ≤ α 与 TPR_early ≥ β,再从中选 TPR_early 最高的那个。附录写明,两个损失都是二元的,p 值用精确二项尾概率算,181 个候选阈值,40 个起点的多起点固定序列检验,δ = 0.1。没有阈值通过时,LTT 弃权。对照的 max-conformal(MC)和 functional conformal(FC)都只保证 FPR;论文写明 MC 总会返回一个阈值。
实验在 14 次 LIBERO-X 运行上做(new-task 3 个种子,new-signature 3 个种子,new-skill 8 折),7 个 FPR 目标从 10% 到 50%,每个都配一个 TPR_early 目标。作者报告:
- 见过任务上,LTT 的两个目标在每一次通过认证的运行里都成立;MC 只有 57–71% 的运行满足 FPR 目标。
- 未见任务上,FPR 目标在 40–86% 的已认证运行中成立;TPR_early 目标在 57–90% 的未见任务运行中成立(论文 6.2 节的说法);MC 最多 21%(贡献列表写作基线 0–21%)。
- LTT 在 14 次运行中弃权 4–7 次,取决于目标(FPR 目标 15–50%)。作者把这解读为部署前就告诉使用者:这个模型撑不起所要求的指标。
读这组数字要注意分母。按本站的理解,“已认证运行”不含 LTT 弃权的那 4–7 次,而 MC 从不弃权,所以 86% 与 21% 不是同一组运行上的比例。弃权本身是有用的信息,但它意味着在这些设置下系统拿不到可用阈值。作者也写明,未见任务的样本与校准集不可交换,这时的保证只在经验上成立,三种方法都一样;这些比例来自 14 次运行,是趋势,不是精确的比率。
有了 TPR 的下界,就能给“报警时真的会失败”的概率,即阳性预测值(PPV),算一个保守下界。论文由贝叶斯公式推出 PPV ≥ π·β / (π·β + (1 − π)·α),其中 π 是失败的先验比例;这个下界随 π 增大,所以给 π 一个下界估计就够了。作者报告这个 PPV 下界在其完整表格的各 FPR 目标下为 58–71%,见过任务上每次已认证运行都成立,未见任务上 70–100% 的运行成立;本站读到的正文没有写这里用的 π 取值。用一组本站假设的数字看 π 的影响:α = 0.1、β = 0.8 时,若 π = 0.3,下界约为 77%;若失败更少见,π = 0.05,下界只有约 30%。同一个探针、同一个阈值,报警的含义取决于部署场景里失败有多常见。
失败类型、开销与转向演示
失败模式。失败类别严重不平衡,作者报告平衡准确率,并与“总猜最常见类别”的多数类基线比较(已有基线都不预测失败模式)。在 LIBERO-X 上,top-1 准确率相对多数类基线最多提高 149%(见过任务)和 79%(未见任务),top-3 提高幅度更小但稳定,摘要给出的未见任务 top-3 相对提升最多为 44%;真机上 top-1 在见过和未见任务上分别提高 171% 和 8%。这些都是相对提升,本站读到的正文没有给出绝对准确率。作者的用法建议是把失败缩小到三个候选类别,再按其中风险最高的一类选择停止、重试或交给人。
开销。作者报告:在一块 RTX 4090 上训练 6.8 s(SAFE-LSTM 为 43.5 s);6.6M 参数、26.5 MB,约为 VLA 的 0.2%;校准每对目标在 CPU 上不到 2 ms。LIBERO-X 上 VLA 每次调用输出 8 个动作、按 20 Hz 执行,一个策略步 400 ms;探针每步在 GPU 上加 0.12 ms(GR00T 一次 54 ms 策略调用的 0.2%),在四个 CPU 线程上 0.9 ms。作为对比,表 3 里 STAC 在 GPU 上每步 21.30 ms,Mahalanobis 和 Euclidean 的评分状态分别为 302.0 MB 和 3056 MB。
转向。论文展示了两个例子:仿真里“把最大的碗放进沥碗架左格”,探针在碗被放进右格之前报警,把末端执行器往左推后恢复策略,回合成功;真机上“把蘑菇放到盘子里”,探针预测到抓取即将失败,暂停 VLA,由专家模型把轨迹移到能成功的一条再恢复。仿真里的纠正工具是按失败模式写的启发式规则。作者明确说,转向部分是启发式的,不在本文的评估范围内,这两个例子是概念验证。摘要里“支持能提高任务成功率的轻量转向”这句话,正文没有给出成功率统计。
和本站课程、雷达的关系
物理AI实验室 2.8:可复现评测 讲了二项比例的区间,以及零失败之后失败率上界的算法。LTT 在这里做的是同一类事:把校准集里“漏检的失败”和“误报的成功”分别看作二项计数,用精确尾概率决定一个阈值能否被认证。区别是 LTT 同时对两个比例下结论,并在证据不足时拒绝给阈值。2.8 强调一个区间只描述它那组试验的次数、判据和场景,这一点在这里直接体现为可交换性假设:换到未见任务,保证就只剩经验意义。
物理AI实验室 1.8:评测 练过给失败打标签。VLA-Tug 的结论依赖 t_fail 和失败模式这两种标签,而它们由一个视频模型自动生成;标签的口径一变,AUROC_early 和 TPR_early 都会跟着变。
物理AI实验室 2.7:安全过滤器 讲的是另一层:CBF 过滤器挂在最快的控制回路上,逐步修正动作,保证相对模型成立。VLA-Tug 工作在策略步的节奏上(这里是 400 ms 一步),输出的是“可能要失败、可能是哪一类”,决定的是何时暂停或交给谁,并不直接约束动作。两者回答的是不同的问题,不能互相替代。
雷达此前写过的 RESETTLE 用冻结策略两次动作采样是否持续分歧来触发恢复,属于论文相关工作和基线部分所说的“动作一致性”这一类信号。VLA-Tug 换成读骨干嵌入,并把触发阈值的校准和失败时刻评测单独做成了论文的重点。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。本站读到的 HTML 正文在附录 A.3 处截断,附录 D 的完整校准表和消融没有读到。
- 作者列出的局限:校准保证依赖校准回合与测试回合可交换,分布偏移越大越弱(作者称经验上是逐步退化);没有系统分析该取骨干的哪一层;转向部分是启发式的,没有评估。
- 30%、44%、149% 等都是相对提升;86% 的分母是已认证运行,不含弃权。引用时应连同基线、设置和分母一起写。
- 失败时刻与失败模式标签来自 Gemini 对视频的自动标注,失败时刻的定义含有“人类操作员会在何时接管”的判断成分。
- 主要分析对象是 GR00T-N1.7 的第 16 层;真机只有 8 个任务,真机列只有学习型和嵌入距离类方法有数字。
- 摘要提到数据集发布在作者的项目页 vla-tug.github.io;本站没有打开或核对该页面及数据集内容。
- 所有结果都不是硬件安全验证。一个失败预测器提供的是暂停或交接的时机,不能替代控制层的安全约束和现场的急停机制。
链接
- Failure Prediction and Classification in Vision-Language-Action Models via Calibrated Latent Probing(arXiv 2611.08425)
- 论文 HTML 全文
- 物理AI实验室 2.8:可复现评测,手算 Wald 与 Wilson 区间,从 1/√n 定评测次数,再给零失败算出失败率上界
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 物理AI实验室 2.7:安全过滤器,手算一步控制障碍函数修正,再算清它该挂在哪条回路、要留多少余量
- 前沿雷达|RESETTLE:冻结策略的两次采样持续分歧才介入,按示范参考只执行一个纠正动作
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)


