
预印本 An Empirical Study of Reinforcement Learning for Keypoint Positioning of Deformable Linear Objects(arXiv 2611.07261,2026-11-05,意大利理工学院 IIT 的 HRII 实验室)研究一个很窄但常见的问题:机器人夹住绳子、软管一类可变形线状物体(DLO)的一端,在桌面上把绳上指定的点移到目标位置。论文是一项实证研究:用 PPO 把训练栈、观测设计、鲁棒性训练和真机迁移逐项测了一遍。作者报告,策略不经真机微调,靠无标记的 RGB-D 关键点估计,在单点跟踪、扰动恢复和两点跟踪上分别成功 9/10、10/10、8/10 次。以下数字均为作者报告 [R],本站没有复现。
任务:一端夹住、平面内、慢速
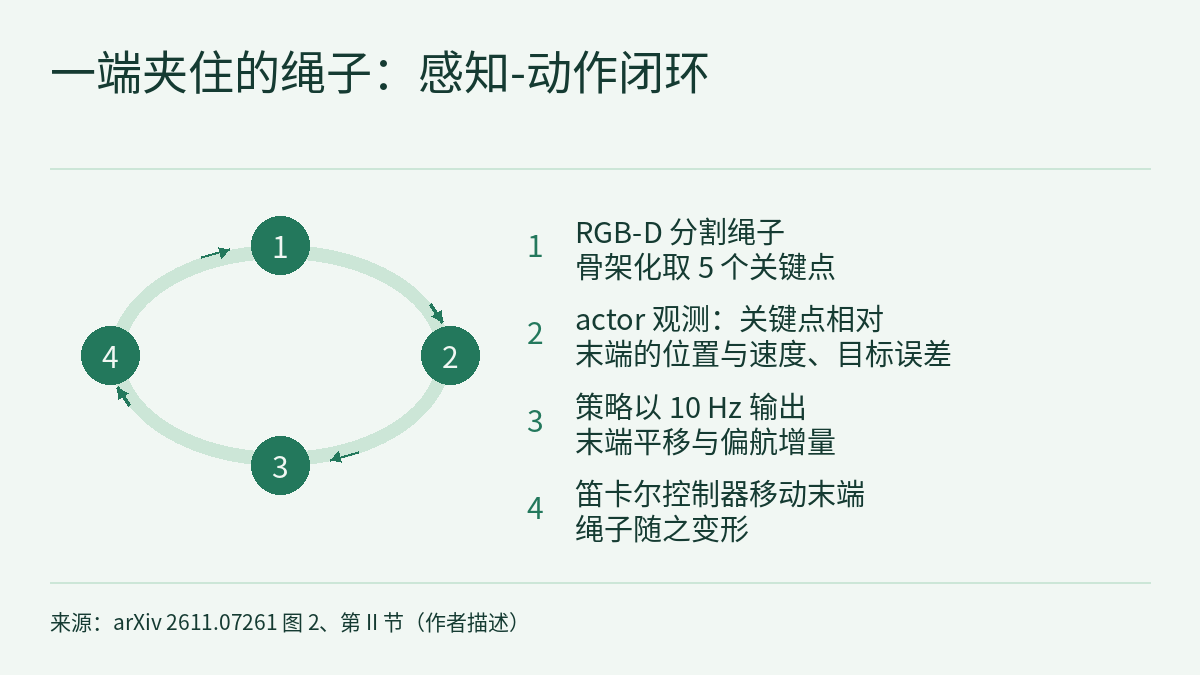
绳子的一端刚性固定在 Franka Emika Panda 的末端执行器(EE)上,另一端自由。笛卡尔控制器只允许末端在 xy 平面内平移、绕 z 轴转动;论文把运动限定为慢速平面运动,在控制层面按准静态处理,忽略动力学效应。策略每步输出一个三维归一化动作:两个平移增量和一个偏航增量,再乘固定的缩放系数。策略以 10 Hz 运行,仿真以 1 kHz 积分,每个训练回合最多 200 个控制步(20 s)。
两个任务:单点跟踪把绳子自由端那个关键点送到目标;两点跟踪还要把靠近末端的那个关键点送到它自己的目标。“到达”的判据是距离不超过 ε = 0.03 m。两点任务的奖励分阶段:自由端的误差全程计入,末端附近关键点的误差只在自由端进入目标区以后才计入;自由端一旦离开目标区,奖励重新优先拉回自由端。这个设计和后文的失败类型直接相关。
训练栈:并行仿真比换学习后端更管用
论文比较了三套完整的 PPO 训练栈:PyTorch 的 Stable-Baselines3 加 CPU 上的 MuJoCo(SB3+mj,4 个并行环境);只把学习后端换成 JAX 的 Stable-Baselines Jax(SBX+mj,仿真不变);以及 MuJoCo Playground(MP),它把 JAX 版 PPO 和 JAX 原生的 MJX 仿真一起放上 GPU,开 1024 个环境。每套栈先用 Optuna 单独调参(每次试验 3 个调参种子,硬件为 8 个 CPU 核和一块 A100 80 GB),再用 5 个未参与调参的种子从头训练;之后的实验都用 8 个 CPU 核和一块 V100 32 GB。
| 训练栈 | 最终成功率 | 成功率曲线下面积 |
|---|---|---|
| SB3+mj | 0.860 ± 0.108 | 0.529 ± 0.048 |
| SBX+mj | 0.880 ± 0.110 | 0.532 ± 0.069 |
| MP | 0.950 ± 0.032 | 0.735 ± 0.077 |
在约 240 分钟的共同墙钟预算内,作者报告 MP 的平均成功率达到 0.95,两套 CPU 栈只达到中等水平;同样时间里 MP 收集的环境交互约多 13 倍。只换学习后端的 SBX+mj 和 SB3+mj 差别很小,作者的解释是瓶颈仍在 DLO 的物理仿真。环境数相差 256 倍(1024 对 4,本站计算),交互量只多约 13 倍,所以“开了多少个环境”不能直接当成吞吐量。作者也写明,三套栈在学习框架、仿真后端、并行度和硬件上同时不同,这是整套系统的比较,不是对单个算法或仿真器的受控比较。
观测设计:相对关键点与非对称 actor–critic
部署时策略能拿到的只有视觉估计出的关键点,所以 actor 只看 5 个关键点,critic 在训练中看 12 个关键点,外加仿真器才有的特权信息(命令截断幅度、是否越出工作空间和工作区的指示量)。关键点以相对末端的位置和速度表示,再加上自由端在机器人基座系中的绝对位置。按论文式 (1)、(3),两点任务中 actor 观测为 37 维、critic 为 70 维(本站计算)。
消融在单点任务上做,四种组合各训练约 2000 万步、2 个种子。作者报告,相对末端的表示比基座系表示学得好,非对称 actor–critic 比对称的好,“相对 + 非对称”整体最好,之后的仿真和真机实验都用它。论文正文只给了曲线图,没有给出这组消融的数值。
鲁棒性:配对比较和失败分解比一个成功率更有信息
鲁棒训练(N+DR)在每步给 actor 能看到的位置、速度、偏航和偏航角速度加零均值高斯噪声,并加最多一个控制步的随机延迟;每回合随机化绳子与桌面的滑动摩擦系数 μ ∈ [0.5, 0.8],以及关节刚度、执行器阻尼和被动阻尼的缩放系数(各在 0.95–1.05 之间);扰动恢复训练再在随机时刻施加外力。弯曲和扭转刚度没有随机化,因为所用的 MP 插件不支持运行时修改。每种条件评测 250 个回合(5 个评测种子 × 50 回合):
| 任务 | 条件 | 成功 / 250 | 成功率 |
|---|---|---|---|
| 单点 | Basic | 249 | 99.6% |
| 单点 | N+DR | 241 | 96.4% |
| 单点(扰动恢复) | N+DR+D | 245 | 98.0% |
| 两点 | Basic | 231 | 92.4% |
| 两点 | N+DR | 222 | 88.8% |
加了扰动反而略高,作者没有把它当成扰动有益的证据。两种条件用同一批目标和初始状态,可以逐回合配对:238 个回合结果不变,8 个由失败变成功,4 个由成功变失败。作者称训练中外力偶尔把自由端推向目标,可能部分解释这个差别,并把结论限定为“鲁棒性得到保持”。两点任务同样配对:213 对两种条件都成功,18 对只在 Basic 下成功,9 对只在 N+DR 下成功,10 对都失败,所以 N+DR 带来的是小幅净下降,不是均匀的能力损失。
两点任务 N+DR 下的 28 次失败全部是超时,按类型分:自由端从未到达(Type-1)19 次,占 67.9%;自由端到了、末端附近关键点没到(Type-2)2 次,占 7.1%;自由端到过、结束时又离开(Type-3)7 次,占 25.0%。失败集中在工作空间边缘:任一目标距可行区边界不到 0.05 m 的“边缘”目标对占 250 个回合的 44.4%,却占失败的 78.6%;边缘与内部的失败率分别为 19.8% 和 4.3%。目标间距越大越难:间距小于 0.10 m、0.10–0.20 m、不小于 0.20 m 时,成功率分别为 92.7%、90.9%、83.1%,作者称这是描述性关联。
另一个单点策略在 0.300、0.375、0.450 m 三种绳长上联合训练,各长度的成功率为 84.4%、86.0%、86.4%。三种长度都在训练集中,测的是分布内的鲁棒性,不是对没见过长度的外推。正文没有写明这组评测的条件,本站不把它和定长策略的 96.4% 直接比较。
真机:零微调的 30 次试验
一台 Intel RealSense D435i 装在工作区上方,以 30 Hz 供图;相机用 ArUco 做外参标定,整套感知与控制经 ROS 集成。微调后的 YOLO26-seg 分割绳子,掩码骨架化后沿中心线取 5 个近似等距的关键点,投影到桌面。作者报告分割的掩码精确率 98.81%、召回率 99.13%、F1 98.97%、mAP@0.5 99.48%、mAP@0.5:0.95 79.30%,推理 29.8 FPS。策略不改网络、不在真机微调,仍以 10 Hz 运行。
主评测用一根直径 0.004 m 的硅胶导管,三项任务各 10 次,全部试验计入结果:
| 任务 | 成功 | 成功试验的完成时间中位数 [IQR] | 失败类型 |
|---|---|---|---|
| 单点跟踪 | 9/10 | 9.30 s [6.70, 14.40] | Type-1 |
| 扰动恢复 | 10/10 | 6.55 s [4.85, 8.32] | — |
| 两点跟踪 | 8/10 | 自由端到达 8.55 s [7.19, 12.30];完成 9.05 s [7.80, 12.47] | Type-3 |
两点任务里,自由端到达后再完成整个目标,中位数只多 0.56 s [IQR 0.17–2.02 s]。两次失败都是自由端到了目标又离开,和仿真里 Type-3 的机制一致。作者归纳的真机失败原因有三类:机械臂自身遮挡绳子,短暂遮挡后回到目标附近还能恢复,遮挡时间长就会做错动作;导管很软,有时急弯后释放弹性势能,在两个目标靠得近的构型里突然弹开;感知延迟有时让策略冲过目标,作者称带噪声和延迟的训练减轻了这一点,几次试验得以恢复。
和本站课程的关系
物理AI实验室 0.4 和 1.4 讲过 GPU 并行仿真的提速数字,以及每个倍数都要写清基线。这篇论文给了一个可变形物体上的例子:只加速学习后端几乎没有帮助,把仿真一起并行化才拉开差距;而且它报告的是同一墙钟预算下的成功率和交互量,不是单一的加速倍数。
物理AI实验室 2.5 讲域随机化要写清改的是模型里哪个量、范围多大。本文把摩擦、刚度阻尼缩放和观测噪声延迟都写了出来,也写明了没能随机化的弯曲和扭转刚度。真机里导管急弯后回弹的失败可以和这一条对照着读;这是本站的读法,论文没有把这类失败归因于未随机化的刚度。最多一个控制步的延迟在 10 Hz 下相当于 0.1 s(本站换算),时延与控制频率的关系见 2.6。
物理AI实验室 1.8 练过用配对表拆“净增”。本文的 8 对 4、18 对 9 正是这种读法:总成功率只差几个点时,先看有多少回合真的变了、往哪个方向变。分阶段奖励怎样塑造行为,可以对照 1.7。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。本站读到的正文里没有代码或数据集地址。
- 真机每项只有 10 次试验,只用一根硅胶导管;论文没有给真机结果的置信区间,本站读到的正文也没有写明导管长度。仿真默认绳长 0.30 m。
- 任务限定在平面、慢速、一端夹持,按准静态处理。作者把形状控制、三维操作和对没见过的 DLO、环境与任务的泛化列为未来工作。
- 训练栈比较同时改变了学习框架、仿真后端、并行度和硬件,作者明确说它不是对单个组件的受控比较。观测消融只有 2 个种子,正文只给曲线、没有数值。
- 策略是针对任务训练的:观测维度随跟踪点数 M 变化,每个 M 要单独实例化一个策略。变长度实验只覆盖训练中见过的三种长度。
- 分割指标的测试集规模和划分方式,本站读到的正文没有写明。
- 真机试验验证的是任务成功率,不是安全验证;仿真成功率也不能替代真机测试。
链接
- An Empirical Study of Reinforcement Learning for Keypoint Positioning of Deformable Linear Objects(arXiv 2611.07261)
- 论文 HTML 全文
- 物理AI实验室 0.4:在虚拟世界练一万遍,给三个仿真数字补上实验条件
- 物理AI实验室 1.4:仿真器地图,手算步长代价、找出接触分叉点,再给三个提速数字标清基线
- 物理AI实验室 1.7:强化学习,手算一局回报看奖励怎样被钻空子,再读论文里的地形课程与超时重置
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 物理AI实验室 2.5:sim2real 的域随机化与系统辨识,把两篇论文的数字放回原设定,再从一条推杯轨迹手算摩擦
- 物理AI实验室 2.6:上边缘,从时延日志算出控制频率上限,分清量化省下的是体积还是时间,再给动作块定长度
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)


