本节视频
配音由 AI 合成。 视频章节、文字稿与出处
文字稿
文字稿
知行问
推倒一摞积木,为什么要先在电脑里推?上一集留了个问题:机器人怎么在虚拟世界里练?这一集就讲清楚。仿真到底是什么,为什么非它不可。
仿真是什么
仿真,就是在电脑里造一个假的世界。里面有重力、有桌子、有积木,全照着真实的物理来算。你推一下积木,它会怎么倒、砸到哪,电脑一步步算给你看。这种程序,叫物理引擎。同一个场景,可以推倒、重来,再推倒、再重来。像 MuJoCo、Isaac 这些仿真器,就是干这个的。原来积木还没真倒,电脑里已经先倒过好多回了!
为什么在虚拟里练
第一个好处,是安全。真机摔一次,可能就坏了。虚拟世界里,摔多少次都不心疼。第二个好处,是快。真机一次只能练一遍。一篇论文里,好几千个机器人,在电脑里一块儿练。论文称,用这个办法,不到四分钟就能学会走路。练的是一台四足机器人,在平地上。一份技术报告称,仿真搬上显卡,比老办法快了成百上千倍。省下的,是大把大把的时间。原来在电脑里,练得比真机快太多了!
仿真够真吗
可是,仿真再像,也不是真的。真桌子有点滑、真积木有点歪,仿真里不一定有。所以在虚拟里练得再好,搬到真机上,常常还要再调一调。这一步,后面还会专门讲。回顾一下,三个要点。一,仿真是电脑里照物理算的假世界。二,好处是又安全又快,还能一起练。三,短板是它不完全等于真实。原来虚拟世界是练功房,可最后还得回真世界考试!都说人形机器人要来了。可演示、样机、量产,差在哪?下一集见!
证据与出处
数千个 · 在一块工作站显卡上,几千个机器人同时在仿真里训练(论文) [R] · arXiv 2109.11978 · Learning to Walk in Minutes
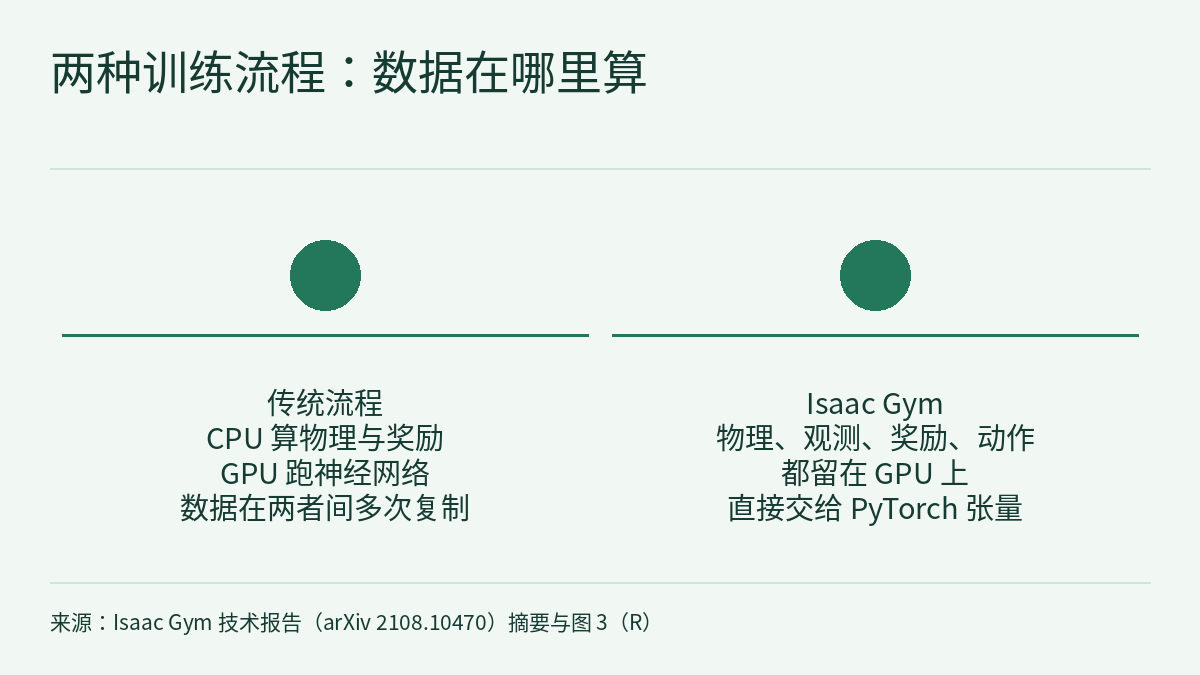
成百上千倍 · 把仿真与训练都放上单块显卡,比 CPU 仿真加 GPU 神经网络的传统训练流程快 2–3 个数量级(技术报告) [R] · arXiv 2108.10470 · Isaac Gym
动手与自测
小测公开,答案与解析在作答后显示;图文课里的练习答案需登录查看。
第 0.4 集的视频用推倒一摞积木的例子讲仿真:电脑里按物理规律算出的“假世界”,安全、快,还能很多个一起练,但不完全等于真实。片中出现了三个数字:几千个机器人一起练、不到四分钟学会走路、搬上显卡快成百上千倍。本篇是这一集的图文课与练习,不重复文字稿,而是把这三个数字放回各自论文的实验条件,讲清“搬上显卡”到底省掉了什么,再用一组假想数字手算一次并行训练的批量。贯穿全文的规则:一个数字只在给出它的那篇论文、那套硬件和那个任务里成立。
本节视频、文字稿与出处在本页上方,全季安排见课程大纲。上一课物理AI实验室 0.3:看-想-动,把三个频率放回各自的系统结尾问:只在真机上做实验又慢又贵,能不能先在虚拟世界里试?本课接着回答。
公开小测的 5 道题附完整解析;登录后可完成三项练习:在虚构约束下给一台虚构四足机器人选并行训练设置、把一份虚构训练日志里的三种时间分开记账并审四句转述、审一份把积木策略直接搬上真机的虚构方案,并对照分步解法、常见错误与 20 分评分标准。
一、三个数字,各自的条件
三个数字出自两篇 2021 年的 arXiv 文献,都是作者报告(R 级)。两篇的作者都有 NVIDIA 背景:Isaac Gym 技术报告的作者署名 NVIDIA,Learning to Walk in Minutes 的作者来自 ETH Zurich 和 NVIDIA。下表的“没说什么”一列同样重要。
| 片中说法 | 出处 | 原文的条件 | 原文没说什么 |
|---|---|---|---|
| 几千个机器人一起练 | Rudin 等,Learning to Walk in Minutes(arXiv 2109.11978,2021-09-24) | 在一块工作站 GPU 上,用 Isaac Gym 让“数千个”仿真机器人并行训练;论文图 3 画的是 4000 个机器人 | 摘要只说“数千个”,不是一个固定上限 |
| 不到四分钟学会走路 | 同上 | 四足机器人 ANYmal 的平地策略不到 4 分钟训练完成;不平地形约 20 分钟 | 这是仿真中的训练耗时,不是机器人在真实地面上学习的时间 |
| 快成百上千倍 | Makoviychuk 等,Isaac Gym(arXiv 2108.10470,2021-08-24) | 物理仿真与神经网络训练都放在单块 GPU 上,对比“CPU 仿真加 GPU 神经网络”的传统 RL 训练,快 2–3 个数量级;图 2 写作整个 RL 训练流程 100–1000 倍 | 不是每个任务都快这么多,也不是和真机训练比 |
同一台机器人,两个时间。Isaac Gym 报告也给了 ANYmal 的数字:在单块 NVIDIA A100 上“不到 2 分钟”达到良好的行走表现。Rudin 论文写的是在一块工作站 GPU 上平地“不到四分钟”。两句话的硬件、任务设定都不同,所给摘录也没有把两者放在同一条件下比较,所以不能得出“哪个更快”或“A100 快一倍”之类的结论。
登录后继续阅读本课其余各节、自测题与答案。
局限 / 注意
- Learning to Walk in Minutes(arXiv,2021-09-24)和 Isaac Gym(arXiv,2021-08-24)的数字都是作者报告,属 R 级。两篇文献都有 NVIDIA 作者:Isaac Gym 技术报告署名 NVIDIA,Learning to Walk in Minutes 的作者来自 ETH Zurich 和 NVIDIA;Isaac Gym 又是 NVIDIA 的产品。本站没有独立复现其中任何一项。
- 本课所依据的是两篇文献的摘要和正文前几节摘录,不含补充材料;真机迁移的效果没有出现在这些文字里。
- 第四节的 4000 个机器人、128 个环境、2000 秒、782 步都是练习用的假设或推算,不是任何系统的配置或性能;第 5 步的 30 倍和不到 3 倍是本课按报告数字做的除法,报告本身没有给出这两个倍数。
- 第六节的机器人 Q 与 P、团队 K、24 步下限、50 步上限、50,000–100,000 的批量范围、全部日志、摩擦系数、积木尺寸、相机偏差、质量和 98% 成功率都是练习用的虚构;算出的 1,966,080 秒、约 2185 倍等只在这些假设下成立。第六节的随机化范围和真机核对是教学建议,不是来源的结论;纸面计算和仿真结果都不是硬件安全验证。
- 视频里“推倒积木”“练功房与考试”是帮助理解的比方。积木推倒的例子不是两篇文献的实验。
链接
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)
- 物理AI实验室 0.3:看-想-动,把三个频率放回各自的系统
- 物理AI实验室 1.4:仿真器地图,手算步长代价、找出接触分叉点,再给三个提速数字标清基线(L1 中接着讲步长、接触与另一个提速数字)
- 前沿雷达|VLaRL:冻结 VLA,只在仿真里训练残差 RL,用 VLM 潜变量跨过视觉 sim-to-real 差距
- Learning to Walk in Minutes Using Massively Parallel Deep Reinforcement Learning(arXiv 2109.11978)
- Isaac Gym: High Performance GPU-Based Physics Simulation For Robot Learning(arXiv 2108.10470)