この回の動画
ナレーションは AI 合成音声です。 動画の章・文字起こし・出典
文字起こし
文字起こし
知行の問い
本物の世界で、何度も部品を壊すわけにはいかない。じゃあロボットは、どこで練習するの?答えの一つは、仮想の世界で練習することです。今回はエヌビディアのコスモス。世界をつくり出して、学習データを生成するしくみです。
世界モデルとは
まず、世界モデルとは何でしょうか。エヌビディアの論文は、はっきり言います。フィジカルAIは、まずデジタルの世界で学習させるべきだと。必要なデジタルツインは二つ。一つはロボット自身、もう一つはロボットがいる世界です。この世界のほうを、世界モデルと呼びます。世界モデルの仕事は一つ。過去の映像と、動作や指示を一つ与えます。すると、次の瞬間の様子を予測します。もう一つ、はっきりさせておきます。世界モデルは、レンダリングエンジンではありません。人が書いたルールではなく、映像から物理を学ぶのです。もう一つの大事な部品が、動画トークナイザーです。映像を、コンパクトな記号の列に圧縮します。こうして初めて、モデルが消化できるのです。こうしたモデルは、膨大な映像で育てられます。エヌビディアの論文によると、元の映像は二千万時間。そこから、およそ一億本のクリップを切り出しました。なぜそんなに必要なのでしょう。データの多様さが、この仮想世界が何種類の物理を見てきたかを決めるからです。多く見ているほど、現実に戸惑いにくくなります。目指すのは、物理世界の汎用シミュレーターです。どんなロボットも、まずその中でひと通りやってみる。やってみてから、実機に移ります。
Predict:未来を予測する
一つ目の武器は、コスモス・プレディクト。名前の通り、次に来る映像を予測します。これにも事前学習と事後学習があります。まず膨大な映像で、一般常識を学ぶ。次に少しの目的データで、専用に微調整します。ロボットとは、どうつなぐのでしょう。動作を条件として、モデルに与えます。その動作に合わせて、映像を予測させるのです。やり方は二つあります。エヌビディアの論文によると、まず拡散モデルの系統。七十億と百四十億、二つの規模がつくられました。もう一つの系統は、自己回帰です。言語モデルのように、一かたまりずつ先を当てていきます。二つの系統には、それぞれの長所があります。こうしたモデルは、一区切りずつ、自己回帰でつないでいけます。短いクリップが、長い映像になっていくのです。学習には、どれだけの計算力を使ったのでしょう。エヌビディアの論文によると、エイチひゃくを一万基使い、まる三か月かかりました。ロボットには、どう役立つのでしょう。エヌビディアによる人の評価では、微調整したモデルの全体の支持率は七十八点三パーセント、ベースラインは十三パーセントでした。比べたのは、ロボットの指示動画の予測です。論文は、ほかにも考えられる使い方を挙げています。たとえば計画。世界モデルにいくつかの動作を予行演習させ、いちばん良いものを選ぶのです。試験官にも、環境にもなれるかもしれません。方策をまずその中で評価し、学習させるのです。ただし論文は、これらの使い方の実験結果はまだ示していないと述べています。うまくいけば、想像の世界で、方策を練習して、試験もできるんだ!
Transfer:スタイル移し替えと sim2real
なぜトランスファーも必要なのでしょう。シミュレーションは安いけれど、見た目が嘘っぽい。現実は見栄えがいいけれど、高くて遅いのです。二つ目の武器は、コスモス・トランスファー。エヌビディアの論文によると、セグメンテーション、深度、エッジを与えると、それに合った本物らしい映像を生成します。その制御は、場所に合わせて変えられます。領域ごとに、制御の強さを変えられるのです。厳密にしたいところは、厳密に。何の役に立つのでしょう。シミュレーションの映像は、たいてい嘘っぽい。トランスファーは、それを本物らしく塗り替えられます。論文は、これを世界から世界への移し替えと呼びます。同じ場面を、スタイルや天気を変えて生成し直せます。論文は、自動運転のデータ拡充にも使っています。プレディクトに話を戻すと、論文は微調整で、カメラの指示に従わせています。ゲームのように、前に進む、後ろに下がる、左に曲がる、右に曲がる。こうして、生成した世界の中を歩けるのです。論文は、プレディクトを自動運転に関わるタスク向けにも微調整しています。生成するのは、走行中の映像です。どれくらい速いのでしょう。トランスファーの論文によると、最上位のGPUラックを、まるごと一台使えば、最高でリアルタイム生成ができます。エヌビディアは、ガードレールも付けました。有害な入力も出力も、止められます。公開前の、必修科目です。二つの武器をつなぐと、一本のデータパイプラインになります。シミュレーションが構造を出し、トランスファーが見た目を出す。プレディクトが未来を補います。生成データの良さは、安くて多様なことです。照明も置き方も、ほしいだけ生成できます。実機では、こんなに速くはできません。いつもの例に戻りましょう。コップをかごに入れる作業を、まず生成した世界で予行演習。置き方が変わっても、やり直せます。論文は、もう一つの使い方も考えています。世界モデルを、方策の出発点にするのです。まず世界の動き方を学び、それから手の動かし方を学ぶ。これも、実験結果はまだありません。まだ解けていないこと。映像がどれだけ本物らしくても、本物の物理とは限りません。論文自身も、世界モデルの問題はまだ解決にはほど遠いと述べています。初歩的な間違いもします。物が突然現れたり、突然消えたり。重力を無視して、机を突き抜けたりもします。世界モデルが良いかどうかは、どう判断するのでしょう。それ自体が難しい問題です。人が採点すると主観が入り、指標も合っているとは限りません。つまりコスモスがくれたのは二つ。プレディクトは未来を予測し、トランスファーはスタイルを変える。二つ合わせて、学習データをつくります。一つだけ覚えてください。これはデータの増幅器であって、正解の出どころではありません。実機は節約できても、確認は欠かせません。もっと先の使い方は、クローズドループです。方策が世界の中で試行錯誤し、フィードバックで自分を改善する。ちょうど次回の話につながります。ふりかえりです。ポイントは三つ。一つ、世界モデルは未来を予測する。二つ、プレディクトは生成、トランスファーは移し替え。三つ、本物らしさは、正しい物理と同じではない。想像の世界でくり返し練習して、また現実に戻る。これが世界をつくる意味なんだ!じゃあ、練習した方策は、試行錯誤でどう強くなっていくの?また次回!
根拠と出典
練習とセルフチェック
小テストは公開で、回答するとすぐ解説が出ます。読み物の練習問題の答えはログイン会員向けです。
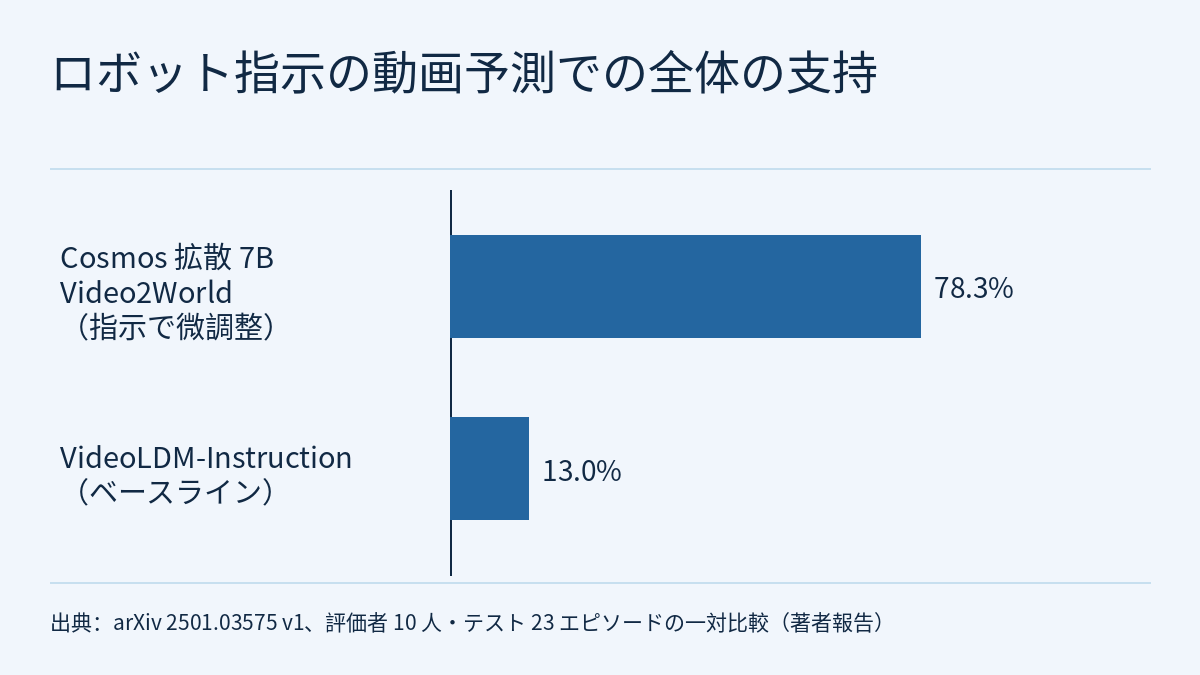
第 3.2 回の動画は、エヌビディアの Cosmos が世界モデルで学習データをつくるしくみを扱います。世界モデルは過去の映像に動作や指示を加えると、次の瞬間を予測します。Cosmos Predict は映像を先へ生成し、Cosmos Transfer はセグメンテーション、深度、エッジのような制御入力から本物らしい映像を生成します。映像がどれだけ本物らしくても、正しい物理と同じではありません。動画の数字カードは、NVIDIA の二本の arXiv 論文、Cosmos 世界基盤モデル・プラットフォーム(2501.03575)と Cosmos-Transfer1(2503.14492)から取っています。このページはこの回の解説と練習です。文字起こしは繰り返さず、動画が軽く触れただけの三つのことを行います。論文の定義を一つの式に書き、生成の種類ごとに何を条件とし、何を出力するかを書き出します。論文がロボットについて報告する二つの評価、つまり 78.3% という人の評価での支持と、Bridge データセットでの四つの映像指標を、それぞれのモデル、データ、採点方法に戻し、何を測り、何を測っていないかを見ます。そして、架空の生成したコップ置きデータについて受け入れ基準を決めます。全体を通す約束は、論文が挙げた使い方は論文が示した結果ではない、評価の数字はそれを報告したモデル、データセット、採点方法だけのものだ、ということです。
この回の動画、文字起こし、出典はこのページの上部にあります。シーズン全体の構成は講座の概要をご覧ください。前回のフィジカルAIラボ 3.1:VLA を分解する――コップを置く動作を 256 区間のトークンに直し、三つのモデルのパラメータ数と周波数の範囲を確かめるでは、方策モデルの中身を分解しました。この回は向きを変え、方策そのものには手を付けず、方策が練習する世界とデータをつくります。シミュレーションがなぜ安いのか、シミュレーションの数字にどんな実験条件を補うべきかは、フィジカルAIラボ 0.4:仮想の世界で一万回練習――シミュレーションの 3 つの数字に実験条件を戻すで扱いました。ドメインランダム化とシステム同定でシミュレーションと実機の差を縮める方法は、フィジカルAIラボ 2.5:sim2real のドメインランダム化とシステム同定――二本の論文の数字を元の設定に戻し、コップを押した一本の軌跡から摩擦を手で求めるで扱いました。Cosmos Transfer が扱うのはもう一つの面、シミュレーションの映像が嘘っぽいという問題です。4 節の受け入れ基準では対にした比較と区間を使います。これらはフィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめるとフィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求めるで計算したので、ここでは導き直しません。この回で読むのは Cosmos 1.0 のプラットフォーム論文と Cosmos-Transfer1 です。本サイトのレーダー記事フロンティア・レーダー|NVIDIA Cosmos 3 on AWS:1 回のフォワードパスで推論・動画・行動を出力、インスタンス選定に付いた検証条件が扱うのは Cosmos 3 で、別のバージョンです。両者の数字を互いに当てはめることはできません。次回 3.3 では、強化学習による事後学習と自己改善のループを扱います。
公開小テストの 5 問には詳しい解説が付いています。ログインすると、三つの練習に取り組めます。五つの架空の生成リクエストについて、過去の観測、条件、出力、論文の根拠の状態を書き出す。八本の架空の生成クリップを監査し、合格率と実機クリップでの誤検出率を求める。架空の結論メモを審査し、三つのシードを対にした結果から、生成データが本当に役立ったかを判定する。いずれにも段階的な解答例、よくある誤り、20 点満点の採点基準が付いています。
1. 一つの式と、いくつかの条件:論文は世界モデルをどう定義しているか
二本とも arXiv のプレプリントで、この講座の区分では R レベルです。どちらも NVIDIA が自社のモデルについて報告したものです。以下の構成と数字はすべて著者の報告で、本サイトはどのモデルも動かしていません。プラットフォーム論文の要旨は次の文で始まります。
Physical AI needs to be trained digitally first. It needs a digital twin of itself, the policy model, and a digital twin of the world, the world model.
論文の 2 節は、世界基盤モデルを一つの写像として書きます。モデル W は、時刻 0 から t までの過去の観測と現在の摂動から、時刻 t + 1 の観測を予測します。コード風の記法では x̂[t+1] = W(x[0:t], c[t]) です。論文によると、Cosmos では過去の観測は RGB 動画で、摂動はさまざまな形をとれます。
It can be an action taken by the Physical AI, a random perturbation, a text description of the perturbation, etc.
動画の「過去の映像に動作や指示を与える」は、この式のことです。論文のどのモデルを読むときも、まず二つを問います。x は何か、c は何か。下の表はこの回が読んだ箇所をまとめたもので、論文の表ではありません。
| モデルまたは事後学習 | 過去の観測 x | 条件 c | 出力 | 出典 |
|---|---|---|---|---|
| Cosmos-1.0-Diffusion-7B / 14B-Text2World | なし | テキストのプロンプト | 動画 | 5 節、表 10 |
| Cosmos-1.0-Diffusion-7B / 14B-Video2World | 入力動画(現在の観測) | テキストのプロンプト | 未来の動画 | 5 節 |
| Cosmos-1.0-Autoregressive-4B / 12B | 現在の動画 | なし(動画だけを見る) | 未来の動画 | 5 節 |
| Cosmos-1.0-Autoregressive-5B / 13B-Video2World | 過去の動画 | テキストのプロンプト(2.2 節の二段階の事前学習から推定) | 未来の動画 | 2.2 節、表 10 |
| カメラ制御の事後学習 | 読んだ箇所には書かれていない | カメラの姿勢 | 視点を動かして探索できる仮想世界 | 序論、6.1 節 |
| ロボットの指示に基づく動画予測 | 動画 | 言語による指示 | 未来の動画 | 6.2 節 |
| ロボットの動作を条件とする次フレーム予測 | 動画 | ロボットの動作 | 次のフレーム(自己回帰でつないで動画にする) | 6.2 節(Bridge) |
| 自動運転に関わるタスク | 読んだ箇所には書かれていない | 読んだ箇所には書かれていない | 読んだ箇所には書かれていない | 序論、6.3 節 |
| Cosmos-Transfer1 | 読んだ要旨には書かれていない | セグメンテーション、深度、エッジなど複数の空間的な制御入力。位置ごとに重みを変えられる | 世界のシミュレーション(動画) | 2503.14492 の要旨 |
拡散モデルも自己回帰モデルも、動画をトークンに変えてから扱います。拡散の系統は連続トークン(Cosmos-1.0-Tokenizer-CV8x8x8)、自己回帰の系統は離散トークン(Cosmos-1.0-Tokenizer-DV8x16x16)を使います。論文によると、これらのトークナイザーは因果的で、現在のフレームのトークンは未来の観測に依存しません。
プラットフォーム論文で、Transfer はまず構想として登場します。2.1 節は、世界モデルを深度や意味マップのようなレンダリングのメタデータを条件とするように微調整し、Sim2Real に使えると述べています。Cosmos-Transfer1 は、まさにそれを行った後の論文です。要旨にはこうあります。
We introduce Cosmos-Transfer, a conditional world generation model that can generate world simulations based on multiple spatial control inputs of various modalities such as segmentation, depth, and edge.
It allows weighting different conditional inputs differently at different spatial locations.
以下は架空の教材用の例です。ロボットアーム D がコップをかごに入れます。「同じ動作を別の照明で見たい」なら Transfer を使います。c はその動作のセグメンテーション画像と深度画像で、コップとかごのある領域は重みを大きくし、背景はゆるくします。出力は新しい本物らしい映像です。「グリッパーが 0.2 秒早く放したらどうなるか」を見たいなら、動作を条件とする Predict を使います。x は放す前の映像、c は書き換えた動作の列で、出力はその後に続く予測映像です。前者が変えるのは見た目、後者が変えるのは未来です。どちらも出てくるのは映像だけで、その中でコップが本当に物理どおりに落ちているかは、別に確かめる必要があります。
ログインすると、このレッスンの続きと確認問題、解答を読めます。
制約と注意点
- 二本とも NVIDIA の arXiv プレプリントで R レベルです。構成、規模、評価の数字は、著者が自社のモデルについて報告したものです。本サイトは再現しておらず、どのモデルも動かしていません。
- この回で読んだのは、プラットフォーム論文 HTML v1 の要旨、序論、2 節、3 節冒頭のデータセットの段落、5 節の冒頭と表 10、6.2 節のロボット評価の一部です。Cosmos-Transfer1 は要旨だけを読みました。読んだ箇所には、78.3% の比較の総数も区間もなく、Cosmos-1X データセットの説明もありません。
- 次はこの回のまとめ、計算、推論です。条件の表(そのうち Autoregressive-5B / 13B-Video2World がテキストを条件とすることは、2.2 節の二段階の事前学習から推定したもの)。78.3 と 13.0 を足して 91.3 になること。FVD の 68% と 27% の低下。学習データの構成とあなたの場面との関係。Transfer の重みを領域ごとに決めるやり方。4 節の受け入れ基準の全体。
- 1 節のグリッパーの例、そして練習のロボット D、チーム Q、リクエスト R1〜R6、クリップ G1〜G8、監査のしきい値、ピクセルの面積、実機クリップ、成功回数は架空のもので、どの論文やシステムのデータでもありません。
- この回の数字は Cosmos 1.0 のプラットフォーム論文と Cosmos-Transfer1 だけのものです。本サイトのレーダーで紹介した Cosmos 3 は別のバージョンです。
- 紙の上の計算、シミュレーション、生成映像の監査は、どれもハードウェアの安全性の検証ではありません。
リンク
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)
- フィジカルAIラボ 3.1:VLA を分解する――コップを置く動作を 256 区間のトークンに直し、三つのモデルのパラメータ数と周波数の範囲を確かめる
- フィジカルAIラボ 0.4:仮想の世界で一万回練習――シミュレーションの 3 つの数字に実験条件を戻す
- フィジカルAIラボ 2.5:sim2real のドメインランダム化とシステム同定――二本の論文の数字を元の設定に戻し、コップを押した一本の軌跡から摩擦を手で求める
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求める
- フロンティア・レーダー|NVIDIA Cosmos 3 on AWS:1 回のフォワードパスで推論・動画・行動を出力、インスタンス選定に付いた検証条件
- フロンティア・レーダー|WorldFailBench:世界モデルで方策を評価するなら、成功率に加えて失敗の原因・段階・境界を確かめる
- NVIDIA:Cosmos World Foundation Model Platform for Physical AI(arXiv 2501.03575、HTML v1)
- NVIDIA:Cosmos-Transfer1: Conditional World Generation with Adaptive Multimodal Control(arXiv 2503.14492)