
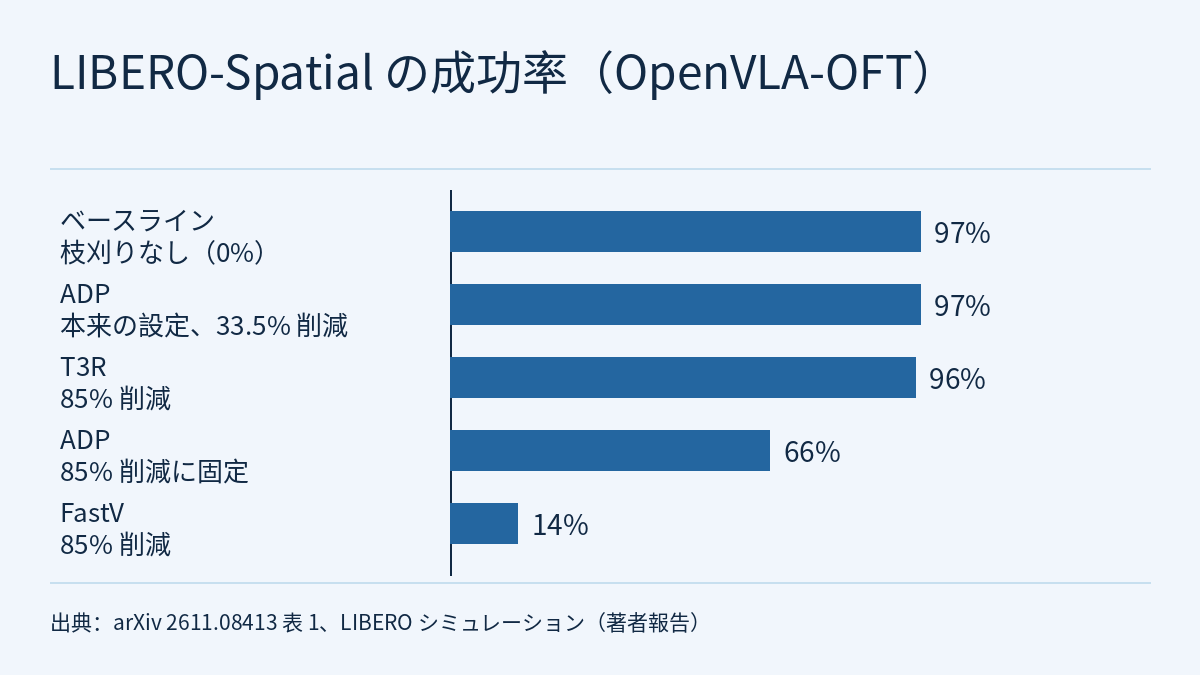
プレプリント T3R: Training-Free Two-Stage Token Refinement Towards Efficient and Robust VLA Models(arXiv 2611.08413、2026-11-05。著者の所属は UT Austin、Georgia Tech、UIUC、香港科技大学、UNC Chapel Hill。ページには ASP-DAC ’27 の論文と記載)は、VLA を再学習せず、推論時に 2 つの処理を加えます。まず、視覚トークンが言語バックボーンに入る前に、セグメンテーションマスクで指示と関係のない画像パッチを削ります。次に、中間層で行動トークンのアテンションにバイアスを加え、残した対象領域と指示の重要語へ注意を向けます。著者の報告では、LIBERO-Spatial で OpenVLA-OFT のシーンカメラのトークンを 85% 削っても成功率は 96%(枝刈りなしで 97%)で、1 回の呼び出しの遅延は 107.5 ms から 92.5 ms に下がりました。以下の数値はすべて著者の報告 [R] で、本サイトでは再現していません。実験はすべてシミュレーションです。
問題:視覚トークンは多いが、ほとんど注目されていない
論文は OpenVLA 型の構成を例にとります。224 × 224 の画像は SigLIP で 256 個のパッチに分けられ、1 パッチが 1 つの視覚トークンになります。OpenVLA-OFT は 2 台のカメラを使うので、1 回の呼び出しで視覚トークンは 512 個です。ここでの 256 は画像パッチの数で、フィジカルAIラボ 3.1 で扱った、OpenVLA が行動の各次元を 256 区間に離散化する話とは別物です。著者は、行動トークンのクエリが視覚トークンに向けるアテンションを集計しました(32 層、LIBERO-Spatial の 10 タスク、タスクごとに 3 時刻の平均)。視覚トークンの 93.9% は、それぞれ 0.2% 未満のアテンションしか受けていません。24〜31 層では、50〜75% のトークンが 0.1% を下回ります。著者は、これは大半のトークンがほぼ働いていないことを示すだけで、デコーダの入口で安全に削れるかどうかは、残す集合をうまく選べるかにかかっているとも述べています。
著者は冗長性を 2 種類に分けています。多くのトークンは空間的にタスクと無関係であり、残ったトークンの間でもアテンションの配分がずれていることが多い、というものです。枝刈りだけでは重要な手がかりを失い、アテンションの調整だけでは計算量もノイズの多い入力もそのまま残ります。そこで T3R は先に削り、残った系列の上でだけアテンションを調整します。本サイトが 10 月 28 日に取り上げた フロンティア・レーダー|TRIAGE はフレーム間の時間方向の冗長性(キャッシュが正確なうちは再利用)を扱いました。T3R は 1 フレーム内の空間方向の冗長性を扱い、論文自身も VLA-Cache のようなキャッシュ手法と補い合う関係だと述べています。
第 1 段階:セグメンテーションマスクで削り、元の位置番号を保つ
- スコア付け。SigLIP で指示の各単語と各画像パッチのコサイン類似度を計算し、品詞ごとの重みで平均します。名詞と形容詞の重みを高く、動詞と前置詞の重みを低くします。
- プロンプト点の選択。類似度はほぼ平坦なことが多く、上位 K 個をそのまま取ると不安定です。著者はまず上位 50 個のパッチを取り、グリッド座標を DBSCAN(ε = 2.0、パッチ単位)でクラスタリングして最大のクラスタだけを残します。その中のスコア上位 8 個を正のプロンプト点、スコア下位 3 個を負のプロンプト点にします。
- マスクの生成。EfficientTAM-S がこれらの点から物体マスクをつくります。マスクが画素の 30% 超を覆うパッチを残し、それ以外を削ります。セグメンテーションがあいまいなスイートでは、類似度が 75 パーセンタイルを超えるパッチも残せます。圧縮率を少し下げて再現率を取る設定です。
- 番号を振り直さない。枝刈り後に残ったトークンを順に振り直すと、後続のトークンが事前学習で見たことのない RoPE の位置に移り、著者の試験では成功率がほぼゼロまで落ちました。T3R は残した各パッチに元の位置番号をそのまま使わせます。論文が示す位置の並びによれば、2 台目のカメラの 256 トークン(位置 257〜512)はそのまま残り、報告されている削減率はシーンカメラ側だけを指します。
- 非同期の更新。SigLIP のテキスト埋め込みは指示ごとにキャッシュします。セグメンテーションは VLA の呼び出し 5 回ごとに非同期で更新され(1 回 54 ms)、行動推論は待たずに直近に完了したマスクを使います。
削る量はシーンによって変わります。まばらなシーンでは 9〜15 個のパッチ、散らかったシーンでは最大 121 個を残します。比較手法の TeamVLA は約 203〜233 個で一定です。論文の図 2 の例(“pick up the bowl between the plate and the ramekin”)では、T3R は 256 個のうち 13 個しか残していません。
第 2 段階:行動トークンのアテンションにバイアスをかける
枝刈りでは情報の欠落が避けられないため、第 2 段階で残った系列の中で補います。T3R は各タスクの開始時に、埋め込み層で指示に対する Integrated Gradients(積分勾配)を 1 回計算します(pad トークンを基準点として実際の入力まで 5 ステップで補間)。寄与の上位 30% の単語を重要語とし、結果をキャッシュしてそのタスクの全エピソードで使い回します。そのうえで、8〜23 層のアテンション logit に加算型のバイアス(強さ β = 2.0)を加えます。対象は行動トークンのクエリだけです。バイアスをかける位置は、重要語(積分勾配のスコアで重み付け)と残った画像パッチ(SigLIP 類似度に 0.5 を掛けて重み付け)です。前半と後半の層には加えません。前半の特徴抽出と後半の出力形式を乱さないため、というのが著者の説明です。
アブレーション(LIBERO-Spatial、10 タスク × 10 エピソード)で各段階の役割がわかります。枝刈りのみで 90%、バイアスのみで 98%、両方で 96%、枝刈りなしのベースラインは 97% です。バイアスは枝刈りで失った 6 ポイントを取り戻しています。バイアスのみがベースラインを上回ったことを、著者は枝刈りなしではアテンションが分散している証拠と読んでいます。中間層(8〜23)だけにかけると 98%、前半の層だけでは 95%、後半の層だけでは 92%、全層では 93% でした。
結果:同じ 85% 削減でも成功率は大きく違う
主な実験は OpenVLA-OFT(SigLIP ViT-SO400M + LLaMA-2-7B、LoRA ランク 32、行動チャンク長 8)で、タスクごとに 10 エピソード、NVIDIA L40S 1 枚で行われました。論文の表 1(LIBERO-Spatial)です。
| 手法 | シーンカメラのトークン削減率 | 成功率 | 1 回の呼び出しの遅延 |
|---|---|---|---|
| ベースライン(枝刈りなし) | 0% | 97% | 107.5 ms |
| TeamVLA | 約 15% | 94% | 102.6 ms |
| FastV(k = 1、r = 0.85) | 85% | 14% | 報告なし |
| ADP(85% に固定) | 85% | 66% | 報告なし |
| ADP(本来の動作点) | 33.5% | 97% | 報告なし |
| T3R | 85% | 96% | 92.5 ms |
ADP と FastV の 85% は、著者がこれらを T3R の高削減の領域まで無理に押し込んだ結果で、各手法の既定の設定ではありません。ADP は本来の動作点(33.5%)では 97% です。つまりこの表が示すのは、85% という強い削減では、デコーダの入口でマスクにもとづいて削る方法が他の 2 手法より成功率を保ったということです。各手法をそれぞれ本来の動作点で比べても T3R が上だ、ということは示していません。
LIBERO の 4 スイート(各 10 タスク × 10 エピソード)では、T3R は Spatial で 96%(ベースライン 97%)、Goal で 98%(同 99%)で、1 回の呼び出しは約 88〜93 ms(ベースラインは 105〜108 ms)でした。Object スイートは例外で 82% となり、TeamVLA の 86% を下回りました。著者によれば、これらのタスクは物体を視覚的に目立つ入れ物(たとえばかご)に入れるもので、類似度が両者に分かれ、セグメンテーションが違う領域を選んだり、マスクが狭すぎたりしました。
分布外テストでは、物体の配置にガウス分布の位置ノイズを加えました(0〜5 cm、21 段階、タスクごとに 10 エピソード)。小さな摂動では T3R はベースラインとの差が 1〜2 ポイントに収まり、2 cm 以上では同等以上で、4 cm では最大 7 ポイント、4 cm 以上の平均で 4.8 ポイント上回りました。5 cm では TeamVLA が 35%、T3R が 48% です。著者はこれを、枝刈りで紛らわしい背景が取り除かれ、アテンションの調整でタスクに関係する情報が強調されたためと説明しています。結果と矛盾しない説明ですが、論文はこの因果関係を別に検証してはいません。
遅延の内訳:実測と推計を分ける
- 224 px での実測。1 回の呼び出しで 107.5 → 92.5 ms、14% 減(1.16 倍)です。1 回の呼び出しは 8 個の行動からなるチャンクを出力し、1 環境ステップではありません。言語モデル部分だけでは 58.9 → 36.1 ms です。2 つの差を引き算すると 7.8 ms が残り、著者はこれを枝刈りとバイアスそのもののオーバーヘッドとしています。この分は 92.5 ms に含まれています。著者は、この計算は計測条件が同等であることを前提としており、各要素を個別に測ったものではないと注記しています。
- クリティカルパスの外にあるコスト。セグメンテーションは 1 回 54 ms で、5 回の呼び出しに 1 回、非同期で動きます。積分勾配はタスクごとに 1 回計算します。著者は 1 s のコストを 220 ステップのエピソード 10 回に割り振り、1 環境ステップあたり約 0.45 ms と換算しています。
- トークン数と時間。L40S で 11 通りのトークン数(8〜256 パッチ)を測ると、時間はほぼ線形でした。トークンあたり 0.040 ms + 53.3 ms(r = 0.97)です。トークンあたりの限界コストは系列長約 200 で 0.040 ms、約 500 で 0.064 ms に上がります。著者はこれを、アテンションがメモリ帯域律速から計算律速へ移る境目と読んでいます。
- 解像度を上げた場合。言語モデルの順伝播の実測では最大 3.3 倍速くなりました(768 px)。エンドツーエンドの数値は推計です。実測した言語モデルの時間に固定の 48.6 ms(言語モデル以外のコスト)を足すと、T3R は 384 / 512 / 768 px で 100 / 115 / 132 ms、ベースラインは 144 / 182 / 327 ms、ADP は 109 / 145 / 238 ms となり、768 px でベースライン比 2.47 倍(ADP は 1.37 倍)です。著者は、この推計では解像度ごとの枝刈りとバイアスのオーバーヘッドを別に測っていないと述べています。
224 px での実測の改善は 14% で、要旨にある 3.3 倍ではありません。3.3 倍は 768 px での言語モデルの順伝播だけに当てはまる数字です。フィジカルAIラボ 2.6 では「周波数の上限は 1 周の遅延の逆数」「容量が減っても時間が減るとは限らない」を練習しました。ここでも同じ区別が必要です。T3R が縮めるのは言語バックボーンの系列長ですが、セグメンテーションモデル、SigLIP によるスコア付け、積分勾配は別に用意する必要があり、本サイトが読んだ本文にはそれらのメモリ使用量の報告がありません。論文は L40S でしか遅延を測っておらず、消費エネルギーの測定もエッジデバイスでの試験もありません。
別のバックボーン、別のカメラ台数:カメラ 1 台では余地がほとんどない
著者は T3R を別の 2 つのバックボーンに移植しました。どちらもファインチューニング済みのチェックポイントを使わないゼロショット評価で、成功率の絶対値は低めです。
- CogACT / SIMPLER(第三者視点のカメラ 1 台)。Google Robot(11 タスク、手法ごとに 189 エピソード)では、ベースライン 73.2%、T3R(60% を保持)67.7% で、5.5 ポイント低くなりました。WidowX/Bridge(4 タスク、手法ごとに 96 エピソード)では両者とも 10.4% です。ここでは、より多くのトークンを残す ADP と FastV のほうが良い結果でした。視点が 1 つだとカメラ間の冗長性がほとんどなく、強く削ると方策がまだ必要とするトークンまで消してしまう、というのが著者の説明です。
- π0.5 / RoboTwin(カメラ 3 台)。手法と予算の組ごとに 5 タスク × 12 エピソード = 60 エピソードを実行しました。50% を保持すると T3R とベースラインはともに 33.3%、62.5% を保持すると T3R は 38.3% で、ベースラインを 5.0 ポイント、最良の比較手法を 10 ポイント上回りました。60 エピソードで換算すると、33.3% と 38.3% はそれぞれ成功 20 回と 23 回です(本サイトによる計算)。
著者はここから、複数カメラの重なり合う視覚情報が枝刈りの余地を広げると結論づけています。ただしこれは、バックボーン、ベンチマーク、カメラ台数が同時に変わる 3 つのシステムにまたがる傾向であり、カメラ台数だけを変えた対照実験ではありません。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者の報告 [R] です。本サイトはどれも再現していません。「デコーダ入口でシーンカメラのトークンを 85% 削り、成功率を枝刈りなしのベースラインから 1 ポイント以内に保った初の学習不要手法」というのは著者自身の位置づけです。謝辞には NVIDIA Academic Grant Program の支援を受けたと書かれています。本サイトが読んだ本文には、コード公開についての記述はありません。
- 実験はすべてシミュレーションです。著者は、実機での制御や、実際のセンサーとアクチュエータの遅延を伴う非同期実行はまだ検証していないと書いています。シミュレーションの結果はハードウェアの安全性検証ではありません。
- サンプルは小さめです。LIBERO の各スイートは 100 エピソードなので、96% と 97% の差はエピソード 1 回分です。主な成功率には信頼区間が付いていません。RoboTwin の各セルは 60 エピソードで、5 ポイントはエピソード 3 回分にあたります。試行回数とともに区間がどう狭まるかは フィジカルAIラボ 2.8 を参照してください。
- 「85%」はシーンカメラ側だけの数字で、論文の位置の並びによれば 2 台目のカメラのトークンはそのまま残ります。そうだとすると、T3R の 1 回の呼び出しで言語モデルに入る視覚トークンは約 37 + 256 = 293 個(著者によればシーン側で残るのは約 37 個)で、512 個の約 57% です。これは本サイトの推計です。
- 枝刈りは取り消せません。マスクの更新は 5 回の呼び出しに 1 回なので、各チャンクの 8 個の行動をすべて実行するなら、その間の約 40 環境ステップは古いマスクのままです(本サイトの推計)。著者が挙げる失敗例は次のとおりです。対象物体と視覚的に目立つ置き場所が類似度を奪い合う場合(Object スイート)。複数段階のタスクで途中から関係する領域が変わるのに、類似度は指示全体から計算され段階に合わせて変わらない場合(Long スイート)。結合した境界や粗い境界でセグメンテーションがもともと失敗しやすいこと。遮蔽や照明の変化でセグメンテーションが有用なパッチを捨てうること。著者はこれらの影響を個別には測っておらず、他のセグメンテーション手法との比較もしていません。
- 積分勾配にはタスクごとに 1 回のコストがかかり、ごく短いタスクや初期化の時間制約が厳しい場合には元が取れないことがあります。ハイパーパラメータは 1 組で全タスクに使われています。バイアスの強さ、かける層、重要語の比率、枝刈りのしきい値を振ると、成功率は 1〜6 ポイント変わりました。
リンク
- T3R: Training-Free Two-Stage Token Refinement Towards Efficient and Robust VLA Models(arXiv 2611.08413)
- 論文の HTML 全文
- フロンティア・レーダー|TRIAGE:VLA が再計算しない視覚 token は、キャッシュが正確なうちは再利用し、古くなったら枝刈りし、固定の再計算予算でプレフィル遅延を一定に保つ
- フィジカルAIラボ 3.1:VLA を分解する――コップを置く動作を 256 区間のトークンに直し、三つのモデルのパラメータ数と周波数の範囲を確かめる
- フィジカルAIラボ 2.6:エッジへ――遅延のログから制御周波数の上限を求め、量子化で減るのが容量か時間かを見分け、動作チャンクの長さを決める
- フィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求める
- フロンティア・レーダー特集|エッジとリアルタイム性:VLA と世界行動モデルのレイテンシ予算はどこに使われているか


