
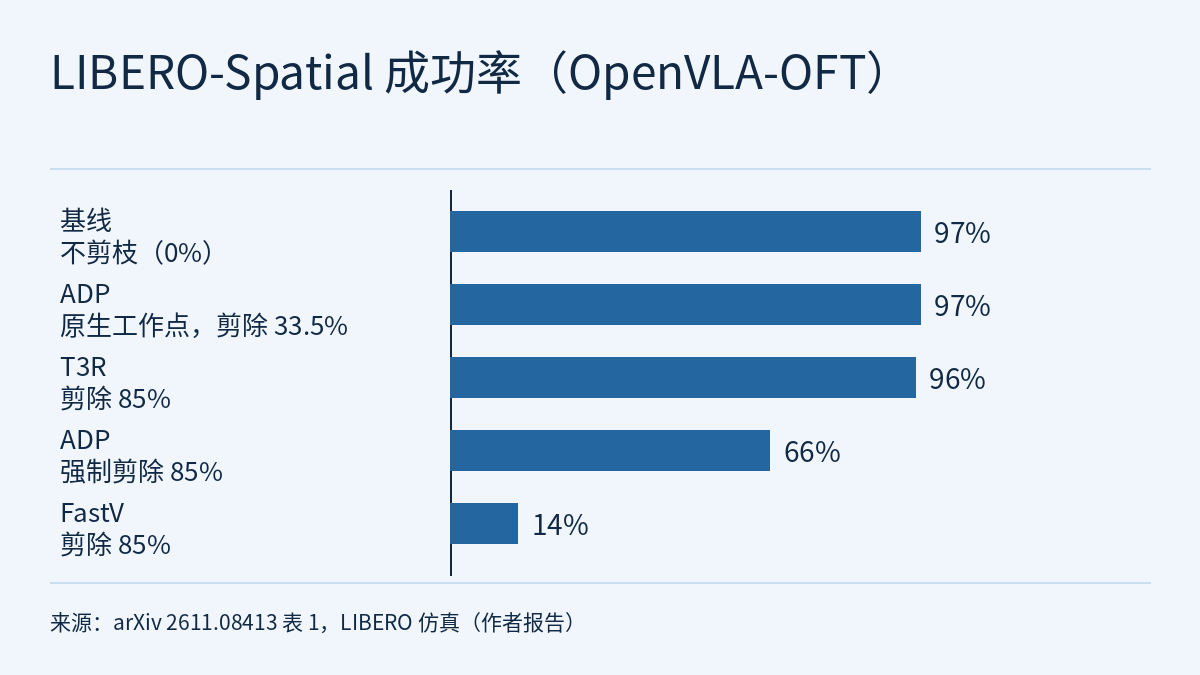
预印本 T3R: Training-Free Two-Stage Token Refinement Towards Efficient and Robust VLA Models(arXiv 2611.08413,2026-11-05,作者来自 UT Austin、Georgia Tech、UIUC、香港科技大学和 UNC Chapel Hill;页面标注为 ASP-DAC ’27 论文)不重训 VLA,在推理时做两件事:先用分割掩码在视觉 token 进入语言骨干之前剪掉与指令无关的图像块,再在中间层给动作 token 的注意力加一个偏置,把注意力引向留下的目标区域和指令里的关键词。作者报告,在 LIBERO-Spatial 上,OpenVLA-OFT 场景相机的 token 剪掉 85%,成功率 96%(不剪枝为 97%),每次调用延迟从 107.5 ms 降到 92.5 ms。以下数字均为作者报告 [R],本站未复现;全部实验都在仿真中完成。
问题:视觉 token 多,但大多没人看
论文以 OpenVLA 式设置为例:一张 224 × 224 的图像经 SigLIP 切成 256 个图像块,每块一个视觉 token;OpenVLA-OFT 用两路相机,每次调用共 512 个视觉 token。注意这里的 256 是图像块数,与 物理AI实验室 3.1 里 OpenVLA 把每个动作维度切成 256 个区间不是一回事。作者统计了动作 token 的查询对视觉 token 的注意力(32 层、10 个 LIBERO-Spatial 任务、每个任务 3 个时间步取平均):93.9% 的视觉 token 各自分到的注意力不到 0.2%;在 24–31 层,50–75% 的 token 低于 0.1%。作者同时提醒,这只说明多数 token 近乎闲置,能不能在解码器入口安全地删掉,仍取决于留下的集合选得好不好。
作者把冗余分成两种:很多 token 在空间上与任务无关;剩下的 token 之间,注意力又常常分配不当。只剪枝会删掉关键线索,只调注意力则保留了全部计算和噪声输入,所以 T3R 先剪、再只在剩下的序列上调注意力。本站 10 月 28 日的 前沿雷达|TRIAGE 处理的是跨帧的时间冗余(缓存还准就复用);T3R 处理的是同一帧里的空间冗余,论文自己也说它与 VLA-Cache 这类缓存方法互补。
第一阶段:按分割掩码剪枝,保留原始位置编号
- 打分。SigLIP 计算指令里每个词与每个图像块的余弦相似度,按词性加权求平均:名词和形容词权重高,动词和介词权重低。
- 选提示点。相似度往往很平,直接取前 K 个不稳定。作者先取得分最高的 50 个图像块,用 DBSCAN(ε = 2.0,单位是图像块)在网格坐标上聚类,只留最大的一簇,从中取 8 个最高分块作正提示点,再取 3 个最低分块作负提示点。
- 出掩码。EfficientTAM-S 按这些点生成物体掩码;掩码覆盖超过 30% 像素的图像块保留,其余删掉。分割难以判断的套件,可再保留相似度高于第 75 百分位的图像块,用一点压缩率换召回。
- 不重新编号。剪枝后如果把剩下的 token 重新按顺序编号,下游 token 会落到预训练时没见过的 RoPE 位置,作者测试中成功率几乎降到零。T3R 让每个保留的图像块沿用原来的位置编号。按论文给出的位置序列,第二路相机的 256 个 token(位置 257–512)原样保留,报告里的剪除比例只指场景相机那一路。
- 异步更新。指令的 SigLIP 文本嵌入按指令缓存;分割每 5 次 VLA 调用异步更新一次(每次 54 ms),动作推理直接用最近一次完成的掩码,不等待。
剪掉多少随场景变化:稀疏场景保留 9–15 个图像块,杂乱场景最多 121 个;对照方法 TeamVLA 固定保留约 203–233 个。论文图 2 的例子(“pick up the bowl between the plate and the ramekin”)里,T3R 只留下 256 块中的 13 块。
第二阶段:给动作 token 的注意力加偏置
剪枝难免丢信息,第二阶段在剩下的序列里补偿。每个任务开始时,T3R 在嵌入层上对指令计算一次积分梯度(Integrated Gradients,从 pad token 基线到实际输入,5 步插值),得分前 30% 的词视为显著词,结果缓存后在该任务的所有回合里复用。然后在第 8–23 层的注意力 logit 上加一个可加偏置(强度 β = 2.0),只作用于动作 token 的查询;偏置的位置包括显著词(按积分梯度得分加权)和保留下来的图像块(按 SigLIP 相似度乘 0.5 加权)。早期层和后期层不加,作者的理由是避免扰乱早期的特征提取和后期的输出格式。
消融(LIBERO-Spatial,10 个任务 × 10 个回合)给出两阶段各自的作用:只剪枝 90%,只加偏置 98%,两者合用 96%,不剪枝基线 97%。偏置把剪枝损失的 6 个百分点补了回来;只加偏置就高于基线,作者认为说明不剪枝时注意力是分散的。只在中间层(8–23)加偏置为 98%,只在早期层 95%,只在后期层 92%,所有层 93%。
结果:同为剪掉 85%,成功率差别很大
主实验用 OpenVLA-OFT(SigLIP ViT-SO400M + LLaMA-2-7B,LoRA 秩 32,动作块长度 8),每个任务 10 个回合,单块 NVIDIA L40S。论文表 1(LIBERO-Spatial):
| 方法 | 场景相机 token 剪除比例 | 成功率 | 每次调用延迟 |
|---|---|---|---|
| 基线(不剪枝) | 0% | 97% | 107.5 ms |
| TeamVLA | 约 15% | 94% | 102.6 ms |
| FastV(k = 1,r = 0.85) | 85% | 14% | 未报告 |
| ADP(强制到 85%) | 85% | 66% | 未报告 |
| ADP(原生工作点) | 33.5% | 97% | 未报告 |
| T3R | 85% | 96% | 92.5 ms |
ADP 和 FastV 的 85% 是作者把它们强制推到 T3R 的高压缩区间得到的,不是它们的默认设置;ADP 在自己的原生工作点(33.5%)上成功率是 97%。所以这张表说明的是:剪到 85% 这么狠时,在解码器入口按掩码剪比另外两种方法保住了更多成功率;它不说明 T3R 在各方法各自的工作点上都更好。
四个 LIBERO 套件(各 10 个任务 × 10 个回合)中,T3R 在 Spatial 上为 96% 对基线 97%,在 Goal 上为 98% 对 99%,每次调用约 88–93 ms,基线为 105–108 ms。Object 套件是例外:82%,低于 TeamVLA 的 86%。作者的解释是这些任务要把物体放进一个视觉上更显眼的容器(比如篮子),相似度在两者之间分裂,分割选错了区域或掩码太窄。
分布外测试给物体摆放加高斯位置噪声(0–5 cm,21 个噪声级,每个任务 10 个回合):小扰动下 T3R 与基线相差 1–2 个百分点;2 cm 以上持平或更高,4 cm 处最多高 7 个百分点,4 cm 以上平均高 4.8 个百分点;5 cm 时 TeamVLA 为 35%,T3R 为 48%。作者把这解释为剪枝去掉了误导性的背景、注意力调整突出了与任务相关的证据,是与结果相符的解释,论文没有单独验证这一因果。
延迟账:哪些是实测,哪些是推算
- 224 px 实测。每次调用 107.5 → 92.5 ms,降 14%(1.16 倍)。每次调用产出 8 个动作的动作块,不是一个环境步。只看语言模型部分是 58.9 → 36.1 ms;两个差值相减剩 7.8 ms,作者把它归为剪枝和偏置本身的开销,已含在 92.5 ms 里。作者注明这笔账假设计时条件可比,没有逐项单独测量。
- 不在关键路径上的开销。分割每次 54 ms,每 5 次调用一次,异步运行。积分梯度每个任务算一次;作者按 1 s 的成本、10 个 220 步回合折算,约每个环境步 0.45 ms。
- token 数与耗时。在 L40S 上测 11 个 token 数(8–256 个图像块),耗时近似线性:每 token 0.040 ms + 53.3 ms(r = 0.97)。序列长约 200 时边际成本是每 token 0.040 ms,约 500 时升到 0.064 ms;作者认为这是注意力从带宽受限转为计算受限。
- 分辨率升高后。语言模型前向的实测最多快 3.3 倍(768 px)。端到端数字是推算:用实测的语言模型耗时加固定 48.6 ms 的非语言模型开销,T3R 在 384 / 512 / 768 px 下为 100 / 115 / 132 ms,基线为 144 / 182 / 327 ms,ADP 为 109 / 145 / 238 ms,768 px 时相对基线快 2.47 倍(ADP 为 1.37 倍)。作者说明,这些推算没有在每个分辨率下单独测剪枝与偏置的开销。
在 224 px 下,实测收益是 14%,不是摘要里的 3.3 倍;3.3 倍只属于 768 px 下的语言模型前向。物理AI实验室 2.6 练过“频率上限是单圈时延的倒数”和“省体积不等于省时间”;这里同样要分清:T3R 省的是语言骨干的序列长度,多出来的分割模型、SigLIP 打分和积分梯度要另外部署,本站读到的正文没有报告它们的显存占用。论文只在 L40S 上测了时延,没有测能耗,也没有在边缘设备上测试。
换骨干、换相机数:单路相机几乎没有余量
作者把 T3R 移植到另外两个骨干上,两组都是零样本评测,没有微调过的检查点,绝对成功率很低:
- CogACT / SIMPLER(单路第三人称相机)。Google Robot(11 个任务,每种方法 189 个回合)上,基线 73.2%,T3R(保留 60%)67.7%,低 5.5 个百分点;WidowX/Bridge(4 个任务,每种方法 96 个回合)上两者都是 10.4%。保留更多 token 的 ADP 和 FastV 在这里表现更好。作者的解释是单路视角没什么跨相机冗余,剪狠了会删掉策略还需要的 token。
- π0.5 / RoboTwin(三路相机)。每种方法、每个预算跑 5 个任务 × 12 个回合 = 60 个回合。保留 50% 时 T3R 与基线同为 33.3%;保留 62.5% 时 T3R 为 38.3%,比基线高 5.0 个百分点,比最好的对照剪枝方法高 10 个百分点。按 60 个回合换算,33.3% 和 38.3% 分别是 20 次和 23 次成功(本站的算术)。
作者据此认为,多路相机重叠的视觉证据给剪枝留下了更多余量。这是三套系统上的趋势,三组的骨干、基准和相机数同时在变,不是只改相机数的对照实验。
局限 / 注意
- arXiv 预印本,全部数字为作者报告 [R],本站没有复现。“首个在解码器入口剪掉 85% 场景相机 token、成功率仍在基线 1 个百分点以内的免训练方法”是作者自己的定位。致谢写明研究得到 NVIDIA Academic Grant Program 支持。本站读到的正文没有提到代码发布。
- 所有实验都在仿真中完成;作者写明,真机控制、带真实传感器和执行延迟的异步执行都还没有验证。仿真结果不是硬件安全验证。
- 样本量小:LIBERO 每个套件 100 个回合,96% 对 97% 只差 1 个回合;主实验的成功率没有附置信区间。RoboTwin 每格 60 个回合,5 个百分点相当于 3 个回合。区间怎样随次数收窄,见 物理AI实验室 2.8。
- “85%”只指场景相机一路;按论文的位置序列,第二路相机的 token 原样保留。若如此,T3R 每次调用进入语言模型的视觉 token 约为 37 + 256 = 293 个(作者称场景 token 约保留 37 个),约为 512 个的 57%,这是本站的推算。
- 剪枝不可逆:掩码每 5 次调用更新一次,若每个动作块的 8 个动作都执行,中间约有 40 个环境步沿用旧掩码(本站的推算)。作者列出的失败情形包括:源物体与显眼的目标容器争夺相似度(Object 套件);多阶段任务里相关区域中途改变,而相似度按整条指令计算、不随阶段调整(Long 套件);分割在合并或粗糙边界上的固有失败;遮挡和光照变化可能让分割删掉有用的图像块,作者没有单独测量这些影响,也没有比较其他分割器。
- 积分梯度每个任务有一次性开销,任务很短或初始化时限很紧时可能摊不平。超参数一套用于全部任务;扫描偏置强度、作用层、显著词比例和剪枝阈值时,成功率变化 1–6 个百分点。
链接
- T3R: Training-Free Two-Stage Token Refinement Towards Efficient and Robust VLA Models(arXiv 2611.08413)
- 论文 HTML 全文
- 前沿雷达|TRIAGE:VLA 不重算的视觉 token,缓存还准就复用、过时就剪掉,用固定重算预算定住预填充延迟
- 物理AI实验室 3.1:VLA 拆解,把一个放杯动作编成 256 个区间的词元,再给三个模型的参数量与频率标清口径
- 物理AI实验室 2.6:上边缘,从时延日志算出控制频率上限,分清量化省下的是体积还是时间,再给动作块定长度
- 物理AI实验室 2.8:可复现评测,手算 Wald 与 Wilson 区间,从 1/√n 定评测次数,再给零失败算出失败率上界
- 前沿雷达专题|边缘与实时性:VLA 与世界动作模型的延迟预算花在哪里


