本节视频
配音由 AI 合成。 视频章节、文字稿与出处
文字稿
文字稿
知行问
网上能下载人形机器人大模型。可它没见过你的机器人,怎么听你的?这一集有个目标。把开放的 GR00T 模型,微调到一台新机器人上。从数据到部署,走一遍。
先认识 GR00T
GR00T 是英伟达开放的人形机器人大模型。看图、听指令,直接输出动作。一个模型,管一整套技能。它不挑一种机器人。同一个模型,能迁到不同的本体上。这就是所谓跨本体。它还开放权重。你能拿去改,装进自己的产品。据英伟达介绍,它的参数有三十亿个。英伟达还说,它的许可证允许商用。它内部有两块。一块负责想,一块负责实时生成动作。这一快一慢,就是双系统。微调之所以省力,是因为它预训练时学了很多。不用从一张白纸开始。起点高,练得快。打个比方。它像个见多识广的学徒。你只要教它你家的规矩。据英伟达介绍,它预训练用了两万多小时录像。主要是人戴着相机,从第一视角拍下的干活画面。更关键的是一条规律。据英伟达介绍,人类视频从一千小时加到两万小时。平均完成率,翻了一倍多。原来英伟达说,一千小时到两万小时,看人干活越多,手越巧!据英伟达介绍,好处很具体。二十二个自由度的灵巧手,也能做精细活。
准备你的数据
微调第一件事,是把你的数据,做成 GR00T 要求的格式。它用的是 LeRobot 格式。这样模型才读得懂。格式最好别从零造。动手前,先查仓库说明,有没有转换脚本和示例。有,就照着改,省得从头折腾。每段数据要有画面、机器人状态、动作,还有任务指令。少一样,模型就对不上。全部对齐,才算一段好数据。还有个小文件,叫 modality。它说清楚,动作里每个数,对应机器人的哪个关节。它就像一张接线图。配置要是写错,训练照样能跑。但学出来的动作会对不上。所以先核一遍。先用示例数据练手,就几段录像。一只机械臂,把方块放进碗里。任务简单,适合上手。数据一齐,就能开练了。可训练要多大的机器?
一条命令开练
好消息是,微调不必从头训练。你只要在自己的数据上,接着往下练一小段。省时间,也省数据。命令就一行。指定基座模型和你的数据。再给上机器人标签和 modality 配置。参数不多,但每一个都要对。基座、数据、标签、配置,缺一不可。错一个,就白跑一场。单卡就能跑。用哪种显卡、要多少显存,以仓库说明为准。动手前,先查清楚。剩下的,就是等它把损失降下来。训练时看一眼曲线,别让它跑飞。稳稳往下,就对了。练一会儿,权重就存下来了。这份权重,就是你机器人的专属大脑。从头训练要很久,接着练一小段就行,省太多了!
评测与部署
练完怎么知道好不好?先做开环评测。开环,就是拿录好的数据。让模型预测动作,再和真实动作比一比。差多少,一目了然。把两组动作画成曲线。示意图里,一条是预测,一条是真实。两条线越贴近,越说明学到了,这最直观。差多少,可以用均方误差来量。它对大偏差特别敏感,能揪出那些离谱的预测。别只看一个数字。多测几段、换几个种子,再下结论。数字要经得起重复。但开环只是必要条件。预测得准,不等于真机上能把活干成。这点必须说清楚。要真的确认,得把它接到机器人上,跑闭环。在仿真里先跑,安全些。稳了,再上真机。部署也简单。起一个策略服务,机器人一端发画面、收动作。接口很干净。想更快,还能上 TensorRT。或者把它放到边缘设备上跑。看你部署在哪。还有一点要老实说。同一份数据跑两次,结果会有点抖动。别把噪声当提升。
动手:跑通示例
跟着做一遍。先把仓库连子模块一起克隆下来。漏了子模块,后面会报错。装好环境,登录 Hugging Face。再按仓库说明,申请所需权限。权限不全,加载会失败。然后用示例数据,跑微调用的那条命令。机器人标签选新本体那一档。训练时开着日志,盯住损失和吞吐。要是跑飞了,早点停。练完,跑一次开环评测。把预测和真实画在一起,看两条线贴不贴。一眼就能看出来。复现算不算成功?看两条线是不是明显更贴。也看它比没微调前,好多少。还没解决的是,开环好,不保证闭环稳。真机上,误差会一步步累积。回顾一下,三个要点。一,GR00T 是开放、可商用的人形大模型。二,微调要先备好 LeRobot 格式数据。三,一条命令接着练,再用开环评测把关。看懂它、备好数据、一条命令,你也能把大模型调成自己的!可这些成功率、这些改进,怎么判断是真的,还是被夸大了?下一集见!
证据与出处
30 亿 · GR00T N1.7 是 30 亿参数的开放视觉-语言-动作模型(看图、听指令、输出连续动作) [O] · NVIDIA · Hugging Face 博客《GR00T N1.7》
可商用 · 英伟达称 GR00T N1.7 是开放、带商用许可的模型 [O] · NVIDIA · Hugging Face 博客《GR00T N1.7》
22 自由度 · 这条灵巧度规律,让 22 个自由度的灵巧手也能完成接触密集的精细任务 [O] · NVIDIA · Hugging Face 博客《GR00T N1.7》
动手与自测
小测公开,答案与解析在作答后显示;图文课里的练习答案需登录查看。
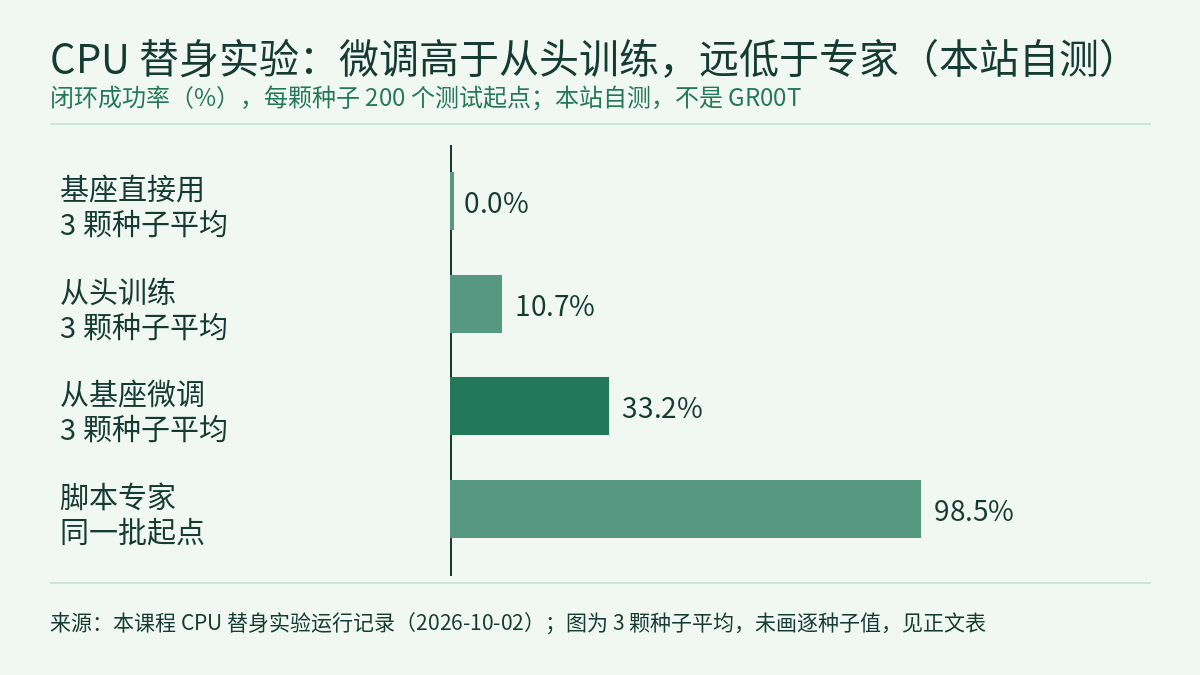
第 3.5 集的视频把开放的 GR00T N1.7 微调到一台新机器人上:先认识这个模型,再把数据做成 LeRobot 格式、写好 modality 配置,然后用一条命令在预训练的基础上接着练一小段,最后用开环评测把关,并提醒开环好不等于真机闭环稳。片中的数字卡都出自 NVIDIA 在 Hugging Face 上发布的 GR00T N1.7 博客。本篇是这一集的图文课与练习,不重复文字稿,只做视频点到、没有展开的三件事:把博客里那条微调命令逐个参数分清“博客写了什么、你要提供什么、要查仓库说明什么”;把 modality 配置当作接线图,在训练前用录制范围核对它,在评测时按维度报误差;再用本课程自己在 CPU 上跑的一个替身实验,看清训练集、验证集、测试集上的开环误差和闭环成功率各说明什么。贯穿全文的规则:开环误差和闭环成功率是两个量,要分开报告;一个数字只属于测出它的那个模型、数据和设置,替身实验的数字不能当成 GR00T 的结果。
本节视频、文字稿与出处在本页上方,全季安排见课程大纲。上一课物理AI实验室 3.4:长程任务,手算单步与整条链的成功率,看进度记忆改变了哪一项,再审一次只换高层的路由消融结尾问:低层那个策略,怎么调到你自己的机器人上?本课接着回答。GR00T N1 的双系统结构和参数,物理AI实验室 3.1:VLA 拆解,把一个放杯动作编成 256 个区间的词元,再给三个模型的参数量与频率标清口径拆过;LeRobot 数据集元数据怎样对到模型输入、步数与批量怎样分开记账,物理AI实验室 2.2:用 LeRobot 训练 ACT,把数据集元数据对到模型输入,再逐项核对训练与评测命令讲过;从开源基座微调一个 VLA 的命令和数字口径,物理AI实验室 2.3:微调 SmolVLA,为一句指令配好示范数据,核对每个数字的口径,再给异步动作队列算时间账讲过;配对表和区间,分别在物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账和物理AI实验室 2.8:可复现评测,手算 Wald 与 Wilson 区间,从 1/√n 定评测次数,再给零失败算出失败率上界里算过。本课不再重复这些,只讲 GR00T N1.7 博客给出的微调入口、modality 配置的核对,以及开环与闭环之间差多远。下一集 3.6 讲怎么读论文、复核数字。
公开小测的 5 道题附完整解析;登录后可完成三项练习:照博客命令为一台虚构机械臂写一份微调运行单,算出样本次数并按整段划分数据;按一份虚构的录制范围审 modality 配置草稿,再算逐维开环误差;用本课程替身实验的记录审一份虚构的评测备忘录,并改写它的结论。每项都附分步解法、常见错误与 20 分评分标准。
一、GR00T N1.7 博客写了什么,没写什么
这篇博客是 NVIDIA 对自家模型的介绍,2026 年 4 月 17 日发布,按本课程的分级属 O 级。下面的结构、数字和用途都是厂商报告,本站没有下载或运行 GR00T N1.7。博客开头写明这次发布的是 Early Access 版本,并称它是一个开放、带商用许可的人形机器人 VLA,原文是:
open, commercially licensed
片中“30 亿参数”的数字卡对应这一句:
GR00T N1.7 is a 3B-parameter open reasoning Vision-Language-Action (VLA) model that maps visual observations and natural language instructions to continuous robot actions.
博客说它用双系统设计:System 2 是以 Cosmos-Reason2-2B 为骨干的视觉-语言模型,System 1 是一个 32 层的扩散 transformer,接收 VLM 的输出和实时的机器人状态,去噪成电机指令(System 2 的原句 3.4 已经引过)。对微调最有用的是博客写明的输入和输出:
Inputs: RGB image frames (any resolution) + language instruction + robot proprioceptive state (joint positions, velocities, EEF poses)
Outputs: Continuous-value action vectors mapped to the robot’s degrees of freedom
按这两句,你的每段数据要能提供画面、指令和本体状态,模型输出的动作向量要能一维一维对到机器人的自由度。视频把说清这件事的文件叫 modality 配置;博客没有解释这个文件的格式。微调入口也只有一句:
N1.7 supports fine-tuning on custom embodiments using the LeRobot dataset format.
博客还说,模型在 Unitree G1、Bimanual Manipulator YAM 和 AGIBot Genie 1 上验证过,支持 NVIDIA Ampere、Hopper、Lovelace、Blackwell 和 Jetson 平台;预训练用了 20,854 小时的人类第一视角视频,人类视频从 1k 小时加到 20k 小时,平均任务完成率翻倍以上。这些都是 NVIDIA 的报告,博客没有给出任务清单和试验次数。
对动手的人来说,博客没写的同样重要:显存要求,2000 步微调要多长时间,微调后在任何机器人上的成功率,新本体该用哪个标签名,modality 配置的文件格式。推理性能只给了一个“4 步去噪、单相机视角”的链接,正文里没有数字。这些都要去仓库说明里查,不能从博客推出来。
登录后继续阅读本课其余各节、自测题与答案。
局限 / 注意
- GR00T N1.7 博客是 NVIDIA 对自家模型的介绍,属 O 级。参数量、验证平台、20,854 小时预训练视频、“翻倍以上”的完成率和“drop-in swap”都是厂商报告。本站没有下载或运行 GR00T N1.7,文中的命令照录博客,没有运行。
- 博客没有给出显存要求、微调时长、微调后的成功率、新本体的标签名和 modality 配置格式;这些以仓库说明为准。视频里“单卡就能跑”对应的是博客命令的
--num-gpus 1,本站没有核实。 - 博客的安装步骤克隆仓库默认分支,没有固定版本。参数名可能随仓库更新而变化,这是本课的推断。
- 第四节的替身实验是本课程自己的 CPU 运行(2026-10-02,本站自测):平面三关节臂、小 MLP 策略、没有视觉输入,不是 GR00T,也不是真机。本文正文只转录了运行记录中的汇总数字,没有转录运行脚本和逐种子的 Wilson 区间。
- 以下是本课的计算、整理或建议:三颗种子的平均值和比值,第二节的参数表,第三节的核对顺序,任务三第 4 项的下一步。
- 臂 R、它的数据、限位、配置草稿、逐维误差、同事 Q 的备忘录和各迁移练习的数字都是虚构的。纸面计算、替身实验和仿真结果都不是硬件安全验证。
链接
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)
- 物理AI实验室 3.4:长程任务,手算单步与整条链的成功率,看进度记忆改变了哪一项,再审一次只换高层的路由消融
- 物理AI实验室 3.1:VLA 拆解,把一个放杯动作编成 256 个区间的词元,再给三个模型的参数量与频率标清口径
- 物理AI实验室 2.2:用 LeRobot 训练 ACT,把数据集元数据对到模型输入,再逐项核对训练与评测命令
- 物理AI实验室 2.3:微调 SmolVLA,为一句指令配好示范数据,核对每个数字的口径,再给异步动作队列算时间账
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 物理AI实验室 2.8:可复现评测,手算 Wald 与 Wilson 区间,从 1/√n 定评测次数,再给零失败算出失败率上界
- NVIDIA Isaac GR00T N1.7: Open Reasoning VLA Model for Humanoid Robots(Hugging Face 博客)