
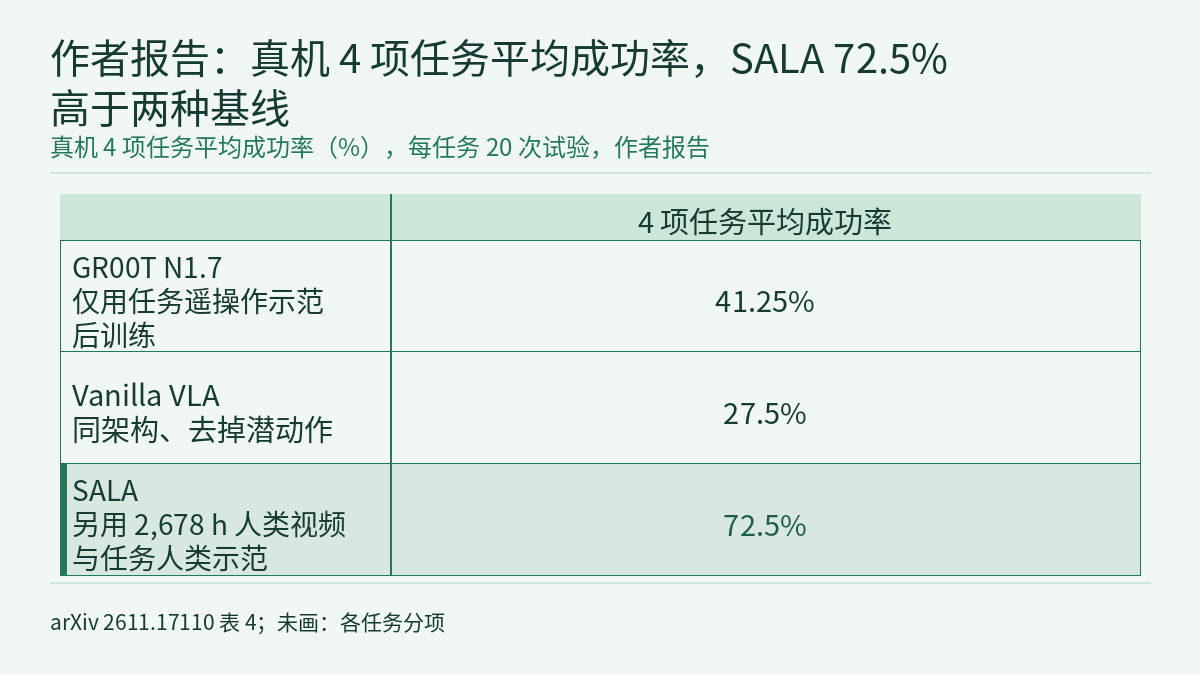
用第一视角人类视频训练机器人策略,常见做法之一是潜动作模型(LAM):先从相邻两帧推断一个“潜动作”,再让策略预测它。arXiv 2611.17110(2026-11-12)的作者指出,只靠视频重建学到的潜动作容易按场景外观聚类,同一个“抓杯子”在人手和机械手上未必落在一起。他们提出的 SALA 用原子动作的文字描述给不配对的人类片段和机器人片段估计语义相似度,再拿它监督潜空间。作者报告:在一台 63 维动作空间的真机上,4 项任务平均成功率 72.5%,同架构去掉潜动作的基线为 27.5%(SALA 另用了人类视频预训练和任务人类示范)。下文数字均为作者报告 [R],本站没有运行代码,也没有独立复现。
只靠重建学到的潜动作会按场景聚类
LAM 的基本结构是一对逆、正动力学:编码器从相隔 k 步的观测 o_t 和 o_(t+k) 推出潜动作 z,经过信息瓶颈压缩后,解码器用 o_t 和压缩码重建 o_(t+k)。训练目标只要求每个潜动作解释自己那段片段里的变化,并不要求人和机器人做同一件事时得到相近的潜动作。作者认为,这样的潜变量会更多地编码场景,而不是动作本身。
与世界动作模型(WAM)相比,LAM 在策略学习时不预测像素。作者把这一点当作 LAM 训练效率更高的理由,并称推理成本可能更低;论文正文没有给出训练或推理耗时的测量。
用文字描述给不配对的片段定“软邻居”
SALA 的分词器在人类数据集和另行采集的机器人数据集上一起训练,两边共用视觉编码器、量化器和视觉解码器,损失由三部分组成:
- 视觉重建:人类与机器人片段都参与,目标是冻结的 DINOv2 对未来观测的特征。
- 动作重建:只有机器人片段有动作标签,一个机器人专用的动作解码器从潜码和初始状态重建动作块,让机器人潜动作直接对应控制。
- 语义对齐:每个片段都标有原子动作描述(如 “grasp the cup”),用冻结的文本编码器算出人类片段与同批机器人片段之间的文字相似度,经 softmax 得到软邻域 P;再用潜动作的余弦相似度得到 Q,以交叉熵让 Q 逼近 P。
对齐里有两处设计。其一,对机器人潜动作做 stop-gradient,只让人类潜动作向机器人一侧移动,因为只有机器人潜动作受过动作监督。其二,量化器用 SoftVQ 而不是硬 VQ:每个词元是码本上的一个分布,能随 z 平滑变化,表达“抓杯子更接近抓瓶子、离放杯子更远”这类分级关系。作者报告,用硬 VQ 时对齐损失几乎停在均匀预测的水平,两者的视觉重建损失则相近。
实现上,每个片段编成 8 个潜词元,码本 256 个码;文本编码器在仿真中是 CLIP ViT-B/32,在真机实验中是 Qwen3-Embedding-4B。本站此前介绍过的 EgoJEPA 以手部动作差分为条件学潜动作;SALA 把跨本体对应关系交给文字描述,不需要人与机器人的配对数据。
分词器冻结后给视频打标签
分词器训练完即冻结,作为“老师”给人类和机器人片段标出潜动作分布 y。未来帧只在打标签时使用,策略本身只看当前观测,部署时不需要老师。策略沿用 π0 式结构:Qwen3-VL-4B 作 VLM,另有一个 0.6B 参数的动作专家用流匹配生成动作块。作者在动作专家里加了可学习的潜动作查询,用 KL 散度拟合老师给出的分布,加噪动作词元会关注这些查询。人类视频没有状态和动作,只走潜动作这一路,但训练的是同一个 VLM 和同一个动作专家。VLA 的这类结构可对照 物理AI实验室 3.1。
训练分三段:预训练只用人类视频和潜动作损失,打标签只需视频帧,不要动作标签,也不要文字描述;中训练在目标机器人遥操作数据上同时用流匹配和潜动作损失;可选的后训练把某项任务的遥操作示范和人类示范放在一起训练。文字描述只在训练分词器时使用,所以真机实验只标注了 983 小时的人类视频子集和机器人数据。
仿真:RoboTwin 2.0 上的对比
仿真实验里没有人类视频,而是用另一种机械臂 ARX-X5 的视频(27,000 条轨迹,68.0 小时)代替,目标机器人 Aloha-AgileX 只有 2,500 条干净场景轨迹(9.2 小时)。评测覆盖 50 项双臂任务,每项 100 次,分干净场景(Clean)和域随机化场景(Random)。WAM 和 LAM 基线也用同样的视频额外训练;π0.5 和 X-VLA 只用目标机器人数据。部分结果(成功率 %):
| 方法 | 类别 | 机器人数据预训练检查点 | Clean | Random | 平均 |
|---|---|---|---|---|---|
| π0.5 | VLA | 是 | 70.7 | 46.6 | 58.7 |
| LingBot-VA | WAM | 是 | 75.8 | 38.4 | 57.1 |
| FastWAM | WAM | 否 | 79.4 | 3.2 | 41.3 |
| OpenWAM | WAM | 否 | 86.8 | 3.9 | 45.4 |
| RotVLA | LAM | 是 | 74.4 | 28.0 | 51.2 |
| SALA | LAM | 否 | 80.2 | 48.6 | 64.4 |
SALA 的 Random 和平均值最高,Clean 低于 OpenWAM。FastWAM 和 OpenWAM 在 Clean 下与 SALA 相当或更高,到 Random 降到 3.2 和 3.9;作者的解释是视频预测还要建模场景外观,而外观正是域随机化改变的东西。消融中,去掉对齐损失后为 75.5 / 36.8,去掉 stop-gradient(双向对齐)后为 73.5 / 46.8。作者还报告,加入对齐后,ARX-X5 潜动作方差中由动作解释的比例中位数从 0.41 升到 0.67,由场景解释的从 0.14 降到 0.04。论文没有给出这些成功率的区间或多种子结果。本站介绍过的 SWAM 也在 RoboTwin 上报告过数字,但训练数据和设定不同,不宜与上表直接比较。
真机:人类视频的两条扩展轴
真机平台是 Sharpa North 轮式人形机器人,带两只 22 自由度的 Sharpa Wave 灵巧手,关节空间动作共 63 维,覆盖手臂、手、躯干和颈部。数据包括 2,678 等效小时的第一视角人类视频(71,582 条)和 888 小时的机器人遥操作数据。四项下游任务各有一份遥操作示范和一份人类示范,例如齿轮装配为 1,466 条遥操作(9.0 小时)和 2,715 条人类示范(12.0 小时)。每种方法每项任务试 20 次,成功率(%)如下:
| 方法 | 齿轮装配 | 双手倒水 | 插花 | 勺子舀取 | 平均 |
|---|---|---|---|---|---|
| GR00T N1.7 | 45 | 50 | 30 | 40 | 41.25 |
| Vanilla VLA | 40 | 25 | 20 | 25 | 27.5 |
| SALA | 75 | 80 | 55 | 80 | 72.5 |
三者都在相同的任务遥操作示范上后训练。Vanilla VLA 与 SALA 同架构但去掉潜动作,只能用遥操作数据;SALA 另外用了人类视频预训练和任务人类示范。因此作者说,两者的差距衡量的是潜动作及其带来的人类视频合起来的贡献,这个对比没有把两者分开。
两条扩展轴分别是:
- 预训练轴:人类视频预算取 0、473、1,103、2,678 等效小时,中训练和后训练数据不变。作者报告,留出遥操作示范上的验证 L1 误差(只计各任务用到的关节)随预算每次增加都下降,0 小时版本也低于 Vanilla VLA。这是离线误差,不是成功率,每个设置只跑了一次。
- 后训练轴:从 2,678 小时预训练的模型出发,遥操作示范固定,任务人类示范用 10%、50%、100%,平均成功率从 53.75% 升到 72.5%。
论文没有给出真机成功率的区间。按 物理AI实验室 2.8 的 Wilson 95% 区间粗算(本站推算,把每种方法 4 项任务共 80 次当作独立试验,忽略任务间差异):72.5% 即 58/80,约 61.9%–81.1%;27.5% 即 22/80,约 18.9%–38.1%;41.25% 即 33/80,约 31.1%–52.2%。SALA 与两种基线的区间不重叠。后训练轴的 53.75% 若同样是 80 次(论文没有单独写明这组的试验次数),即 43/80,约 42.9%–64.3%,与 72.5% 的区间有重叠,这条趋势在当前样本量下还不够确定。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],没有独立复现;论文没有给出成功率的区间或多种子结果,上文的 Wilson 区间是本站按计数粗算。
- 作者单位包括 Sharpa Robotics、上海交通大学与 Sharpa 的具身智能联合实验室和清华大学;真机平台 Sharpa North 和 Sharpa Wave 灵巧手与排在首位的作者单位使用同一品牌名。
- 仿真实验里的“人类视频”是另一种机械臂的视频,不是人类视频。
- 作者写明的局限:分词器训练需要原子动作描述(策略本身只用视频帧);扩展分析看的是离线验证误差,每个设置一次运行,预训练预算最多 2,678 小时,更大规模下趋势是否延续、如何转化为真机成功率仍未知。
- 真机对比中 SALA 比基线多用了人类视频和任务人类示范,比较的是整套方法,不是相同数据量下的结构差异。
- 论文给出了项目网站地址,本站没有打开,也没有查到代码或模型是否公开。
链接
- SALA: Semantically Aligned Latent Actions Enable Dual-Axis Scaling of Embodied Foundation Models(arXiv 2611.17110)
- 论文 HTML 全文
- 物理AI实验室 1.5:数据从哪来,从 SO-101 元数据算出示范时长,再分清三条来路的单位与动作空间
- 物理AI实验室 3.1:VLA 拆解,把一个放杯动作编成 256 个区间的词元,再给三个模型的参数量与频率标清口径
- 物理AI实验室 2.8:可复现评测,手算 Wald 与 Wilson 区间,从 1/√n 定评测次数,再给零失败算出失败率上界
- 前沿雷达|EgoJEPA:不做人到机器人的重定向,从第一视角人类视频学潜动作,换机器人只加一对适配器再微调
- 前沿雷达|SWAM:4.7 万小时视频与示范怎样喂给世界动作模型,作者逐项消融了标注细度、UMI 动作标签和数据配比
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程


