
常见的机器人操作仿真基准大多在“横向”扩展:把抓放、推、开门这类较简单的技能换到更多场景和物体上。新加坡国立大学等机构的 Chongkai Gao 等人在预印本 ManiLadder(arXiv 2611.16374,2026-11-12)里换了一个问题:一个策略能稳定解决哪一级难度的操作任务?他们用一条固定的参考策略在统一协议下的成功率给 112 个仿真任务定级,分成 4 级,并反复修改任务,直到每个任务落进目标区间。读这套分级时,先要知道它锚定在哪条策略上、换策略后还剩多少一致。以下数字均为作者报告 [R],本站没有运行作者的代码。
任务怎样组织
112 个任务分成 32 个套件,每个套件 3 到 4 个任务,同一套件内难度级别、物体类别和本体相同,只是技能或物体不同。四个级别都按同样三条轴组织:物体分刚体(含门、抽屉等铰接物体)和可变形物体;本体分单臂夹爪、单臂灵巧手、双臂夹爪、双臂灵巧手四种,机械臂是 Franka Panda,灵巧手是 LeapHand,少数需要底盘移动的任务用 TidyBot++;技能按文献整理成 9 个族,包括工具使用、接触密集装配和动态操作。可变形物体按维度分:绳子用胶囊刚体串成的铰接链,布料用 PBD 求解器,黏土类用 MPM,液体用 SPH。作者称 ManiLadder 是第一个在有组织的结构中包含 40 个以上可变形物体任务的仿真基准。仿真器是 Genesis,接口为 Gym 风格。
标准训练集每个任务 20 条脚本示范,共 2,240 条轨迹,20 Hz;单臂任务 4 个视角、双臂 5 个,图像 640 × 480。标准观测只有 RGB 图像和一句任务指令,不给本体状态,也不给仿真器特权状态。允许外部预训练,但要公开检查点和可得的训练数据信息。每个任务用固定的 50 个测试初始化种子评测,与采集示范的种子分开,所有方法共用。
难度怎样校准
参考策略是一个 50M 可学习参数的小型流匹配模仿学习策略:冻结的 RADIO 视觉编码器读多视角 RGB,Transformer 编码器–解码器对动作块做流匹配去噪。每个任务给 20 条示范,训练 40k 步,batch size 256,每 5k 步评测 50 个回合,取训练过程中最好的一次成功率 s(T),按区间定级:
| 级别 | 参考策略成功率 s(T) | 按 50 回合换算的成功次数(本站计算) |
|---|---|---|
| Level 1 | 60%–100% | 30–50 |
| Level 2 | 24%–58% | 12–29 |
| Level 3 | 6%–22% | 3–11 |
| Level 4 | 0%–4% | 0–2 |
50 个回合的成功率只能以 2 个百分点为一档,所以 58% 与 60%、22% 与 24%、4% 与 6% 是相邻的两档,区间之间没有空档。任务落不进目标区间,就改任务设计(初始化范围、空间容差、物体复杂度、时序协调等),重新采示范、重训、重评。作者报告平均每个任务要改约四轮,并认为这说明人的主观难度判断和标准协议下的经验难度信号差距很大。作者也明确说,ManiLadder 不打算定义与策略无关的“绝对难度”,参考策略在这里是一件测量仪器。
换种子、换策略后,分级还剩多少
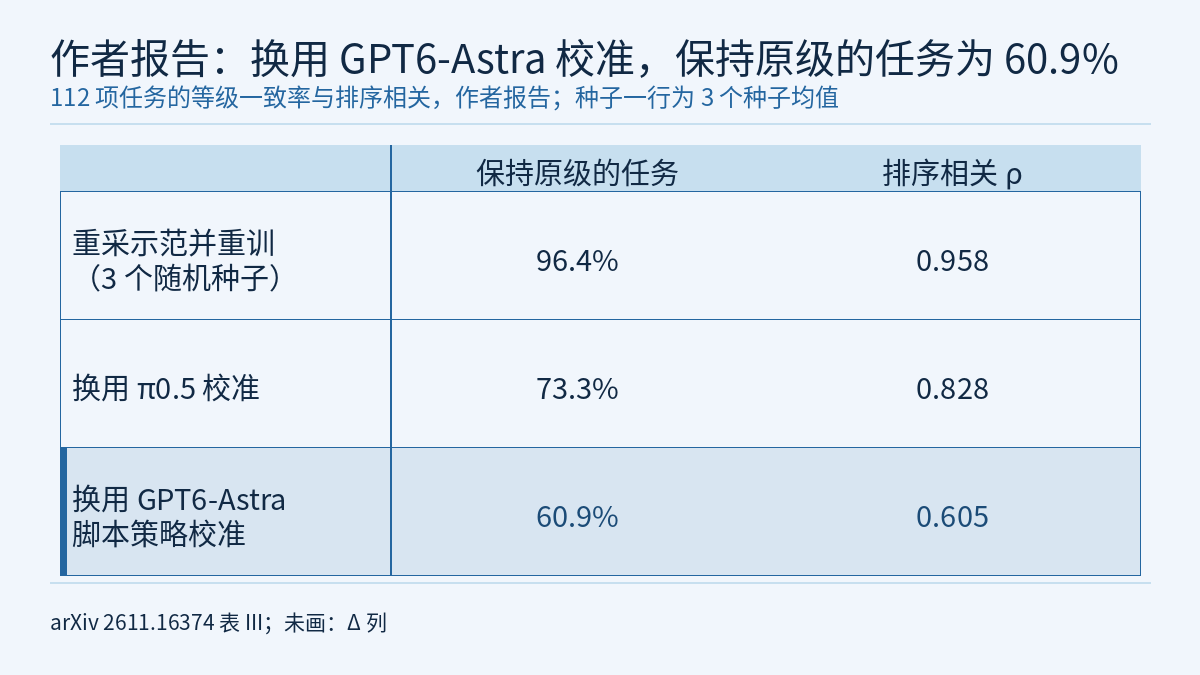
为检验这件仪器,作者做了两组复核,每个指标都在全部 112 个任务上计算。第一组用 3 个随机种子重新采 20 条示范、重训、重评;第二组不再改任务,换两种策略重做校准:π0.5(大型预训练流匹配 VLA),以及 GPT6-Astra 脚本策略,即让 GPT-6 Astra Medium 作为编码智能体,从 20 条示范和至多 20 个环境交互回合合成可执行的 Python 策略。ρ 是与原始校准的任务排序相关,Δ 是成功率平均绝对变化,A 是保持原级别的任务比例(论文表 III):
| 设定 | ρ | Δ(百分点) | A(%) |
|---|---|---|---|
| 3 个随机种子 | 0.958 ± 0.006 | 5.67 ± 0.361 | 96.4 ± 3.100 |
| π0.5 | 0.828 | 12.95 | 73.3 |
| GPT6-Astra | 0.605 | 18.26 | 60.9 |
按 A 换算,换成 π0.5 校准时约 26.7% 的任务换了级,换成 GPT6-Astra 时约 39.1%(本站计算)。作者强调的是另一面:三种方法的平均成功率都从 Level 1 到 Level 4 单调下降,所以按级别聚合的趋势能迁移到参考策略之外。单个任务上差别很大:GPT6-Astra 在 Stack6Blocks-v1 和 DualArmRubikCube-v1 上成功率为 100% 和 84%,两种模仿学习策略最多 8%;它在较低级别的 PushSoccer-v1、ShapeTToI-v1 上又表现很差。
作者为每个任务标注了四项属性:时序分数、物体复杂度、操作复杂度和感知难度。论文图 6 显示时序分数与成功率负相关,操作复杂度和感知难度高的任务成功率也往往更低;作者据此认为难度来自多个因素,而不是单一属性。
Attained Level:一个方法能爬到第几级
基准的汇总指标是 Attained Level(AL):在某一级及其以下每一级中,至少有比例 ρ 的任务成功率达到阈值 τ,才算达到这一级。论文固定 ρ = 0.8,主指标 AL@50 取 τ = 0.5,严格指标 AL@80 取 τ = 0.8;在 50 个回合下分别对应至少 25 次和 40 次成功。AL = 0 表示 Level 1 的条件就没有满足。单任务训练(ST)下的结果:
- 小型流匹配策略:AL@50 = 1,AL@80 = 0。
- π0.5:AL@50 = 1,AL@80 = 0。
- GPT6-Astra:AL@50 = 0,AL@80 = 0。
GPT6-Astra 在 Level 2–4 的平均成功率比两种模仿学习策略高,AL 却是 0。原因在定义里:达到某一级要求每个更低级别也满足覆盖率,它在 Level 1 没有满足。所以 AL 与平均成功率回答的是两个问题,报告时最好并列。智能体方法用 D20-E20 设定:同样 20 条示范,加 20 个探索回合的预算,开发阶段可读在线 RGB 与本体状态,禁止使用任务专用专家代码、隐藏仿真状态和评测结果,开发完成后冻结控制器。作者提醒,GPT6-Astra 多了探索回合和本体状态观测,它的提升不能只归因于模型能力。
实验里的几项发现
- 没有一种方法全面领先。相对小型流匹配策略,π0.5 在 Level 1 刚体单臂灵巧手套件上高 27.5 个百分点,Level 2 可变形单臂灵巧手高 36.0,Level 3 可变形单臂夹爪高 34.0;在 Level 1 刚体单臂夹爪低 23.5,Level 2 刚体双臂灵巧手低 27.5。相对 π0.5,GPT6-Astra 在 Level 3 的四个刚体套件上都更高(7.0 到 31.3 个百分点),在 Level 2 可变形双臂夹爪高 63.3,Level 4 刚体双臂夹爪高 37.5,但在 Level 3 可变形双臂灵巧手上为 0。
- 跨级迁移帮助小,同级跨套件迁移多数有益。用 π0.5 先在源集合上训练再微调目标集合:只有 L2 → L1 提高(+4.1 个百分点),L1 → L2 与 L3 → L2 分别为 −2.3 和 −4.4,Level 2 预训练后 Level 3 仍基本解不了。Level 2 内六种跨套件设定中五种为正,最大的是刚体 → 可变形(+9.2)和两种末端执行器之间(+6.1、+7.0)。
- 一个策略训练全部 112 个任务,结果差很多。MT-A(一个 π0.5 策略联合训练全部任务)在全部 32 个套件上都低于单任务训练:Level 1 从 75.4% 降到 25.9%,Level 2 从 40.7% 降到 8.2%,Level 3 和 Level 4 都只有 0.1%,总体 8.6% 对 33.5%。按论文表述,MT-A 的总训练步数是单任务预算的 112 倍。
- 数据增加,成功率上升,但远未饱和。在 16 个 Level 2 刚体任务上联合微调 π0.5,每任务 20、50、100、200 条示范时平均成功率为 21.4%、27.8%、29.6%、31.8%。单臂灵巧手套件从 31.0% 升到 53.0%,双臂灵巧手从 12.5% 升到 29.0%,双臂夹爪则从 20.0% 降到 12.0%。
真机部分选了 8 个任务,用 X-Arm 机械臂、Meta Quest 3 遥操作和两台 RealSense D435i,每个任务 20 条示范训练流匹配策略,评测 50 次(论文表 IX):
| 任务 | 真机 | 仿真 |
|---|---|---|
| PickPlacePen | 100% | 80% |
| HangMug | 40% | 44% |
| Stack6Blocks | 10% | 10% |
| PingPongTransport | 0% | 0% |
| UnfoldShirt | 80% | 70% |
| FoldShirt | 40% | 44% |
| BagHanging | 10% | 6% |
| BuildTent | 0% | 0% |
作者的结论是真机结果大体保持了仿真校准的难度顺序。按上面的定级区间对照仿真一列,前四个和后四个任务各自恰好从 Level 1 排到 Level 4(本站推断,论文图 7 只说 8 个任务来自四个难度级别)。
和本站评测课的关系
物理AI实验室 2.8 讲过怎样给一个成功率配 Wilson 区间。用同样方法算,50 回合中 30 次成功(60%,Level 1 的下限)的 95% Wilson 区间约为 46.2%–72.4%(本站计算),跨过了 Level 1 与 Level 2 的边界。单次 50 回合的评测本身分不清边界附近的任务属于哪一级,能说明分级稳定的是作者的种子复核:3 个种子下 96.4% 的任务保持原级。2.8 还提醒过,从多次运行中只报最好的一次会让数字偏高;ManiLadder 的校准分数正是训练中多次评测的最大值(40k 步、每 5k 步一次,约 8 次,本站按步数换算)。这是定级规则的一部分,对所有任务一致,但读者不宜把 s(T) 当作一次普通评测的成功率。配对比较、失败分类和随机种子的读法见 物理AI实验室 1.8,全季安排见 课程大纲。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。论文称已把任务定义、示范和评测协议冻结为带版本的发布,所读正文没有给出代码或数据的下载地址。
- 难度级别锚定在一条 50M 参数的参考策略上。换成 π0.5 或 GPT6-Astra 校准,约 26.7% 和 39.1% 的任务换级(本站按表 III 换算)。
- 只有种子复核给了标准差;各套件成功率表、AL 结果和真机表都没有区间,也没有说明训练重复了几次,几个百分点的差距不宜读成确定的排序。
- GPT6-Astra 与模仿学习策略的输入和预算不同(多 20 个探索回合和本体状态),比较的是不同学习设定。
- 真机部分是一套平台上的 8 个任务,验证的是难度顺序,不是硬件安全验证。


