
预印本 SWAM(arXiv 2611.12870,2026-11-09,作者来自上海交通大学、Shanghai Innovation Institute、Noematrix Ltd.、西湖大学和同济大学)研究世界动作模型(WAM)预训练时的数据与监督怎样组织。WAM 从预训练视频模型出发,在语言条件下同时预测未来视频和机器人动作;作者关心的是,加入动作学习之后,视频预训练学到的语言–视频对应能不能保住。为此他们整理了约 47,000 小时的通用视频、第一视角视频、UMI 示范和机器人示范,逐项改变标注细度、动作标签覆盖率、数据配比和模型结构,在 RoboTwin 2.0 的随机场景上比较成功率。本文按这些消融逐项整理,并标出哪些差距在作者的评测规模下偏小。以下数字均为作者报告 [R],本站未复现。
一个模型同时学无动作视频和带动作示范
模型是 MoT 结构的两条分支:视频分支从 Wan2.2-TI2V-5B 初始化,动作分支随机初始化,两者各有独立的残差流,训练时全部参数都更新。信息只从视频流向动作:视频 token 因果地关注当前和过去的视频 token;动作 token 关注过去和当前块的视频 token,以及当前块内的状态和动作 token。作者指出,这种单向连接让只有视频的样本可以继续训练视频分支,而视频目标不会直接更新动作分支。
语言只通过交叉注意力进入视频分支。动作分支没有文本交叉注意力,只能经由视频特征拿到语言信息,用意是复用视频预训练里已经建立的语言–视觉对应。每个块含 2 个视频潜帧和 48 个动作步。UMI 示范和机器人示范共用一套 16 维双臂末端表示:每只手 3 维位置、wxyz 顺序的 4 维四元数和 1 维夹爪值,每个来源按自己的 q1 与 q99 统计量归一化。
训练目标是视频和动作各一个 flow matching 损失,等权相加。所有样本都计算视频损失,只有带有效动作标注的样本计算动作损失,缺失或无效的动作目标被掩码。这样,没有动作标签的视频也能进入同一次预训练。本站此前介绍的 HWAM 处理的是人形机器人参考动作与实际状态的差别;SWAM 关心数据与监督,按论文的建模选择,视频分支不以本体状态为条件。
47,016.7 小时的数据池:四类来源,监督各不相同
论文表 1 列出预训练数据的构成,共 4,407,996 个回合、47,016.7 小时:
| 来源 | 小时 | 组成 | 提供的监督 |
|---|---|---|---|
| 通用视频 | 10,909.6 | Panda-70M 10,087.4 h,OpenVid 822.1 h | 语言–视频 |
| 第一视角视频 | 10,986.3 | EgoSuite 8,600.6 h,Ego4D 1,339.7 h,EgoVerse 1,046.0 h;共 371,212 条轨迹 | 语言–视频 |
| UMI 示范(自采) | 15,284.9 | 411,754 条轨迹 | 语言–视频–动作 |
| 机器人示范 | 9,836.0 | ABC、AgiBot、InternData-A1、Galaxea、RoboCOIN、RoboMind 的子集,共 768,356 条轨迹 | 语言–视频–动作 |
UMI 示范用 RoboPocket 采集:一部智能手机加一只手持自适应夹爪,操作者开合、移动夹爪来操作物体。头部和双腕视角录像,手机的视觉惯性跟踪给出动作轨迹,外部编码器记录夹爪开合。机器人示范只保留双臂机器人、带头部与双腕视角且通过质量检查的子集,排除缺视角、视角语义不一致、分辨率不足、任务过于简单和单臂本体的数据。全部数据打包为 LeRobot 2.1 格式。过滤按来源不同:通用视频(OpenVid、Panda-70M)借助原有标注和 VLM 内容审核,去掉动画、静态画面、电视节目等不合适的内容;第一视角视频用 VLM 评估运动模糊、亮度、遮挡以及片段是否包含有效动作;UMI 示范和机器人示范采用类似的过滤规则。之后用 Qwen 3.8 Max 和 Seed 2.1 Pro 切分子任务、生成标注。
物理AI实验室 1.5 讲过人类视频的难处:人手不是机器手,视频里没有精确的关节角。SWAM 的处理方式是让人拿一只结构上接近机器人末端执行器的夹爪去做示范,再把动作写进与机器人示范相同的 16 维末端表示。下一节的动作标签消融,量的就是这些人类动作标签对机器人控制有多少用。
标注细度与动作标签:三组消融
消融的评测协议相同:预训练后,在 RoboTwin 2.0 的 50 个任务上只用 Clean 示范后训练,Easy 在相同的干净条件下评测(Clean-to-Clean,C2C),Hard 在背景纹理、杂物、光照、桌面高度和相机位置随机化的条件下评测(Clean-to-Random,C2R)。消融时每个任务、每种设置跑 25 个回合。下面引的都是 Hard 成功率。
- 语言标注(表 4,第一视角视频与 UMI 混合预训练 20k 步):子任务级标注从 Brief 到 Medium 再到 Detailed,为 47.20%、49.60%、53.52%;再加场景与光照描述为 55.04%。同为 Detailed,整段级标注为 51.60%,子任务级为 53.52%。把同一轨迹内子任务描述与视频片段的对应随机打乱,从 53.52% 降到 52.00%。
- 机器人数据的标注(表 5):作者随机抽取的 9 个机器人数据子集有 145,430 条轨迹,任务级指令却只有 592 条。原始指令为 50.80%;每条指令配 100 个同义改写、训练时随机抽一个,为 54.76%(+3.96 个百分点);为每条轨迹写具体的操作过程与环境描述,为 56.16%。作为对照,直接从 Wan 后训练、不做多源预训练是 34.56%。
- UMI 动作标签覆盖率(表 6):保留全部 UMI 视频,只改变带动作标签的轨迹比例。0%、25%、50%、75%、100% 对应 46.72%、47.76%、49.92%、50.16%、51.28%,从 0% 到 100% 共升 4.56 个百分点。没有标签的视频仍参与视频学习,所以这组比较把“多一份视频”和“多一份动作标签”分开了。
配比、结构与预训练规模
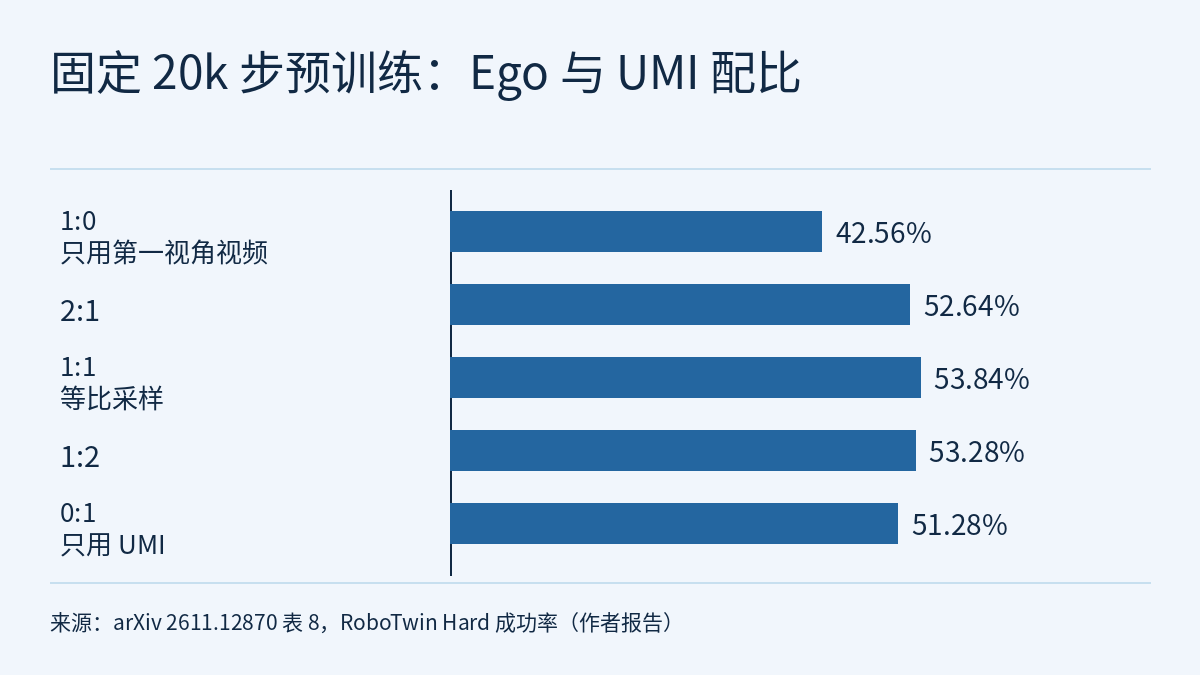
在固定 20k 步的预训练预算下,作者比较了第一视角视频(Ego)与 UMI 的五种采样比例(表 8):1:0 为 42.56%,2:1 为 52.64%,1:1 为 53.84%,1:2 为 53.28%,0:1 为 51.28%。三种混合都高于只用任一来源,等比采样最高,比只用 UMI 高 2.56 个百分点。增加单一来源的训练量时(表 7),固定 UMI、逐步加入 Ego(总步数 10k、20k、30k),Hard 为 49.68%、53.84%、55.60%;固定 Ego、逐步加入 UMI 的同一序列为 42.08%、53.84%、51.20%,最后一步是下降的,作者的表述是“generally improves”。在混合训练前先用通用视频过渡训练 25k 步,Hard 从 53.84% 升到 56.48%。
模型结构的比较(表 9)在 30k 步多源预训练下完成:视频与动作共享残差流的 Single-stream 为 52.56%,标准 Dual-stream 为 52.48%,只让动作分支经视频特征获取语言的 Dual-stream 为 57.36%,比标准 Dual-stream 高 4.88 个百分点。Easy 上这个变体反而最低:Single-stream 86.48%、标准 Dual-stream 84.96%、该变体 84.80%。另一组实验在 20k 步、Ego 与 UMI 等比的设置下,用交叉注意力额外接入 CLIP、DINOv2、SigLIP2 或 Qwen3-VL 2B 的图像特征,Hard 从原生输入的 49.52% 降到 39.76%–42.96%。作者的解释是这条新融合通路没有经过语言–视频预训练,模型可能更依赖当前训练分布里的外观线索;论文对此用的是“may”。
预训练规模按训练视频小时计,50k 步约合 45k 视频小时。在 RoboTwin 上,多源预训练后 Hard 最高为 59.60%,不预训练为 34.56%。真机上,Hard 设置的三任务平均 SR 和 PSR 随训练视频从 22.5k 小时增加到 90k 小时,由 33.33% 和 46.90% 升到 48.89% 和 61.43%,0 小时的设置一个任务也没完成。先在 Ego 与 UMI 上预训练 75k 步、再在机器人数据上续训 25k 步,RoboTwin Hard 为 61.52%(表 10)。
主结果:RoboTwin 50 个任务与三项真机任务
RoboTwin 2.0 的 50 个任务各有 50 条 Clean 示范,共 2,500 条;从预训练检查点出发,在全部任务上联合后训练一个模型 20k 步,主结果每个任务、每种设置跑 100 个回合。表 11 的部分结果:
| 模型 | RoboTwin Easy | RoboTwin Hard | 真机 Easy SR / PSR | 真机 Hard SR / PSR |
|---|---|---|---|---|
| SWAM(Ours) | 88.10% | 61.56% | 56.67% / 68.57% | 40.00% / 50.36% |
| OpenWAM | 89.30% | 48.70% | 37.78% / 46.35% | 23.33% / 31.67% |
| π0.5 | 70.66% | 46.00% | 50.00% / 71.87% | 20.00% / 37.78% |
| LingBot-VA | 77.04% | 36.16% | 41.11% / 53.61% | 10.00% / 24.01% |
| Fast-WAM | 77.76% | 1.92% | 35.56% / 49.33% | 6.67% / 14.52% |
RoboTwin 上,SWAM 的 Hard 比 OpenWAM 高 12.86 个百分点,Easy 比它低 1.2 个百分点,两种设置的平均为 74.83%。真机实验在双臂 Flexiv Rizon 4 上做叠杯、叠毛巾和礼物装盒三项任务,每项任务从上游预训练权重单独适配一个模型 50k 步,所有模型用相同的任务数据。Easy 只改变熟悉物体的位置,Hard 更换物体、背景或两者。每项任务、每种设置用 10 个事先固定、各模型共享的布局,每个布局 3 次,共 30 次;动作以 30 Hz 同步执行。Hard 下 SWAM 的 SR 比 OpenWAM 高 16.67 个百分点,PSR 比 π0.5 高 12.58 个百分点;Easy 下 π0.5 的 PSR(71.87%)高于 SWAM(68.57%)。论文另展示了水果放置和彩色叠杯两个换物体、换场景的执行示例,这两项没有给出成功率。
读这些差距时要算的样本量
以下是本站按论文给出的评测次数做的估算,不是论文的数字。消融每种设置是 50 个任务 × 25 个回合 = 1,250 个回合。把回合当作独立试验,成功率在 50% 附近时,标准误约 1.4 个百分点,95% Wald 区间半宽约 2.8 个百分点。比较两个各自独立评测的设置时,差值的 95% 半宽约为 √2 × 2.8 ≈ 3.9 个百分点。按这个尺度,1:1 与 1:2 的配比差(0.56 个百分点)、打乱标注的降幅(1.52)、整段与子任务标注的差(1.92)以及等比与只用 UMI 的差(2.56)都落在抽样波动之内;结构改动的 4.88 超过 3.9,但超出的幅度不大;接入外部图像特征的降幅(6.56–9.76)和有无预训练的 25.04 则明显更大。这个估算只算评测回合的抽样,不含训练随机种子带来的差异,而本站读到的正文没有报告多种子结果或置信区间。
主结果每种设置 5,000 个回合,Hard 61.56% 的标准误约 0.7 个百分点,相对 12.86 个百分点的领先很小。真机每个模型、每种设置是 3 项任务 × 30 次 = 90 次,因为各任务次数相同,40.00% 和 23.33% 对应 36/90 和 21/90 次成功;40% 附近的单组 95% Wald 半宽约 10 个百分点。各模型共用同一批布局,按布局配对比较会更紧,但论文没有给出逐布局结果。区间的手算方法见 物理AI实验室 2.8。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。论文称公开整理后的数据、训练代码和模型权重;本站没有打开或核对这些发布,所读正文也没有逐项说明公开内容是否包含自采的 15,284.9 小时 UMI 数据。
- 标注细度(表 4)、动作标签覆盖率(表 6)、配比(表 8)和结构(表 9)这几组消融,各自只在一个固定预算(如 20k 或 30k 步)和一套配置下比较,结论的适用范围以这些设置为限;表 5 的预训练步数正文没有给出。标注由 Qwen 3.8 Max 和 Seed 2.1 Pro 生成,换用其他标注模型的效果论文没有测。
- 真机规模曲线在 90k 小时处的 Hard SR 为 48.89%,而表 11 中 SWAM 的真机 Hard SR 为 40.00%;RoboTwin 上表 10 末行(88.08%、61.52%)与表 11(88.10%、61.56%)也略有差别。本站读到的正文没有说明主表对应哪个检查点。规模实验用 Ego 与 UMI 数据,主表写的是在完整多源数据上预训练。
- 正文引用的表号与表题编号有错位,例如描述标注实验时写的是 Table 6,对应表题是 Table 4。本文按表题编号引用。
- 真机只有一个平台、三项任务,每项任务单独后训练一个模型。水果放置和彩色叠杯是示例,不是统计结果。仿真和实验室真机的成功率都不是硬件安全验证。
- 作者写明的局限:方法对复杂推理和显式多阶段规划的支持有限,历史上下文有限可能妨碍长时程任务;他们计划探索记忆机制和分层规划。


