
プレプリント SWAM(arXiv 2611.12870、2026-11-09、著者は上海交通大学、Shanghai Innovation Institute、Noematrix Ltd.、西湖大学、同済大学)は、世界行動モデル(WAM)を事前学習するときのデータと教師信号の組み立て方を調べた研究です。WAM は事前学習済みの動画モデルを出発点とし、言語を条件として未来の動画とロボットの動作を同時に予測します。著者が問うのは、動作の学習を加えたあとも、動画の事前学習で得た言語と動画の対応が保たれるかどうかです。そのために一般動画、一人称視点動画、UMI デモ、ロボットのデモを合わせて約 47,000 時間を整理し、キャプションの詳しさ、動作ラベルの付与率、データの混合比、モデル構造を一つずつ変えて、RoboTwin 2.0 のランダム化シーンでの成功率を比べています。本記事ではこれらのアブレーションを順に整理し、著者の評価規模に対して小さい差がどれかを示します。以下の数値はすべて著者報告 [R] で、本サイトでは再現していません。
動作のない動画と動作付きデモを一つのモデルで学習する
モデルは 2 つのブランチからなる MoT 構造です。動画ブランチは Wan2.2-TI2V-5B で初期化し、動作ブランチはランダムに初期化します。両者はそれぞれ独立した残差ストリームを持ち、学習ではすべてのパラメータを更新します。情報は動画から動作へ一方向にだけ流れます。動画トークンは現在と過去の動画トークンに因果的に注意を向け、動作トークンは過去と現在のチャンクの動画トークン、および現在のチャンク内の状態トークンと動作トークンに注意を向けます。著者によれば、この一方向の接続により、動画だけのサンプルで動画ブランチの学習を続けても、動画の目的関数が動作ブランチを直接更新することはありません。
言語はクロスアテンションを通じて動画ブランチにだけ入ります。動作ブランチにはテキストのクロスアテンションがなく、言語の情報は動画の特徴を経由してのみ受け取ります。動画の事前学習ですでにできている言語と視覚の対応を再利用するための設計です。各チャンクは動画の潜在フレーム 2 枚と動作 48 ステップからなります。UMI デモとロボットのデモは共通の 16 次元の双腕エンドエフェクタ表現を使います。片手あたり 3 次元の位置、wxyz 順の 4 次元クォータニオン、1 次元のグリッパー値で、各ソースはそれぞれの q1 と q99 の統計量で正規化します。
学習の目的関数は動画と動作それぞれの flow matching 損失で、等しい重みで足し合わせます。動画の損失はすべてのサンプルで計算し、動作の損失は有効な動作アノテーションを持つサンプルだけで計算します。欠けている、または無効な動作の目標はマスクされます。このため、動作ラベルのない動画も同じ事前学習に参加できます。本サイトで以前紹介した HWAM は人型ロボットの参照動作と実際の状態のずれを扱いました。SWAM が扱うのはデータと教師信号で、論文のモデル設計上、動画ブランチは身体の状態を条件にしていません。
47,016.7 時間のデータプール:4 種類のソースと、それぞれの教師信号
論文の表 1 は事前学習データの構成を示しています。合計 4,407,996 エピソード、47,016.7 時間です。
| ソース | 時間 | 内訳 | 得られる教師信号 |
|---|---|---|---|
| 一般動画 | 10,909.6 | Panda-70M 10,087.4 h、OpenVid 822.1 h | 言語–動画 |
| 一人称視点動画 | 10,986.3 | EgoSuite 8,600.6 h、Ego4D 1,339.7 h、EgoVerse 1,046.0 h。軌跡は計 371,212 本 | 言語–動画 |
| UMI デモ(自前収集) | 15,284.9 | 軌跡 411,754 本 | 言語–動画–動作 |
| ロボットのデモ | 9,836.0 | ABC、AgiBot、InternData-A1、Galaxea、RoboCOIN、RoboMind のサブセット。軌跡は計 768,356 本 | 言語–動画–動作 |
UMI デモは RoboPocket で収集しました。スマートフォンと手持ちの適応型グリッパーを組み合わせた装置で、操作者はグリッパーを動かし、開閉して物体を扱います。頭部と両手首の視点で録画し、スマートフォンの視覚慣性トラッキングが動作の軌跡を、外部エンコーダがグリッパーの開閉を記録します。ロボットのデモは、頭部と両手首の視点を備えた双腕ロボットのもので品質チェックを通ったサブセットだけを残し、視点の欠落、視点の意味の不一致、解像度不足、単純すぎるタスク、片腕の機体のデータは除いています。データはすべて LeRobot 2.1 形式でまとめています。フィルタリングはソースごとに異なります。一般動画(OpenVid、Panda-70M)では元のアノテーションと VLM による内容審査でアニメーション、静止したシーン、テレビ番組などの不適切な内容を取り除き、一人称視点動画では VLM でモーションブラー、明るさ、遮蔽、意味のある動作を含むかどうかを評価します。UMI デモとロボットのデモにも同様のフィルタリング規則を適用します。そのうえで Qwen 3.8 Max と Seed 2.1 Pro でサブタスクの分割とキャプション付けを行っています。
フィジカルAIラボ 1.5 では、人の動画の難しさとして、人の手はロボットの手ではなく、動画には正確な関節角がないことを取り上げました。SWAM は、構造がロボットのエンドエフェクタに近いグリッパーを人に持たせてデモを行い、その動作をロボットのデモと同じ 16 次元のエンドエフェクタ表現に書き込むことでこの問題に対処しています。次の節の動作ラベルのアブレーションは、こうした人の動作ラベルがロボットの制御にどれだけ役立つかを測っています。
キャプションの詳しさと動作ラベル:3 つのアブレーション
アブレーションの評価手順は共通です。事前学習のあと、RoboTwin 2.0 の 50 タスクで Clean のデモだけを使って事後学習します。Easy は事後学習と同じクリーンな条件(Clean-to-Clean、C2C)で、Hard は背景のテクスチャ、散らかった物、照明、テーブルの高さ、カメラ位置をランダム化した条件(Clean-to-Random、C2R)で評価します。アブレーションでは各タスク・各設定で 25 エピソードを実行します。以下はいずれも Hard の成功率です。
- 言語キャプション(表 4、一人称視点動画と UMI を混ぜて 20k ステップ事前学習):サブタスク単位のキャプションを Brief、Medium、Detailed と詳しくすると 47.20%、49.60%、53.52% になり、さらにシーンと照明の記述を加えると 55.04% になります。同じ Detailed でも、エピソード単位のキャプションは 51.60%、サブタスク単位は 53.52% です。同じ軌跡内でサブタスクの記述と動画区間の対応をランダムに入れ替えると、53.52% から 52.00% に下がります。
- ロボットデータのキャプション(表 5):著者がランダムに選んだ 9 つのロボットデータのサブセットには 145,430 本の軌跡がありますが、タスク単位の指示文は 592 件しかありません。元の指示文では 50.80%、各指示文に 100 通りの言い換えを用意して学習時にランダムに 1 つ選ぶと 54.76%(+3.96 ポイント)、軌跡ごとに具体的な操作の過程と環境を記述すると 56.16% です。比較のため、多ソースの事前学習をせず Wan から直接事後学習すると 34.56% です。
- UMI の動作ラベル付与率(表 6):UMI の動画はすべて残し、動作ラベルを持つ軌跡の割合だけを変えます。0%、25%、50%、75%、100% でそれぞれ 46.72%、47.76%、49.92%、50.16%、51.28% となり、0% から 100% までで 4.56 ポイント上がります。ラベルのない動画も動画の学習には参加するので、この比較は「動画が増えること」と「動作ラベルが増えること」を切り分けています。
混合比、構造、事前学習の規模
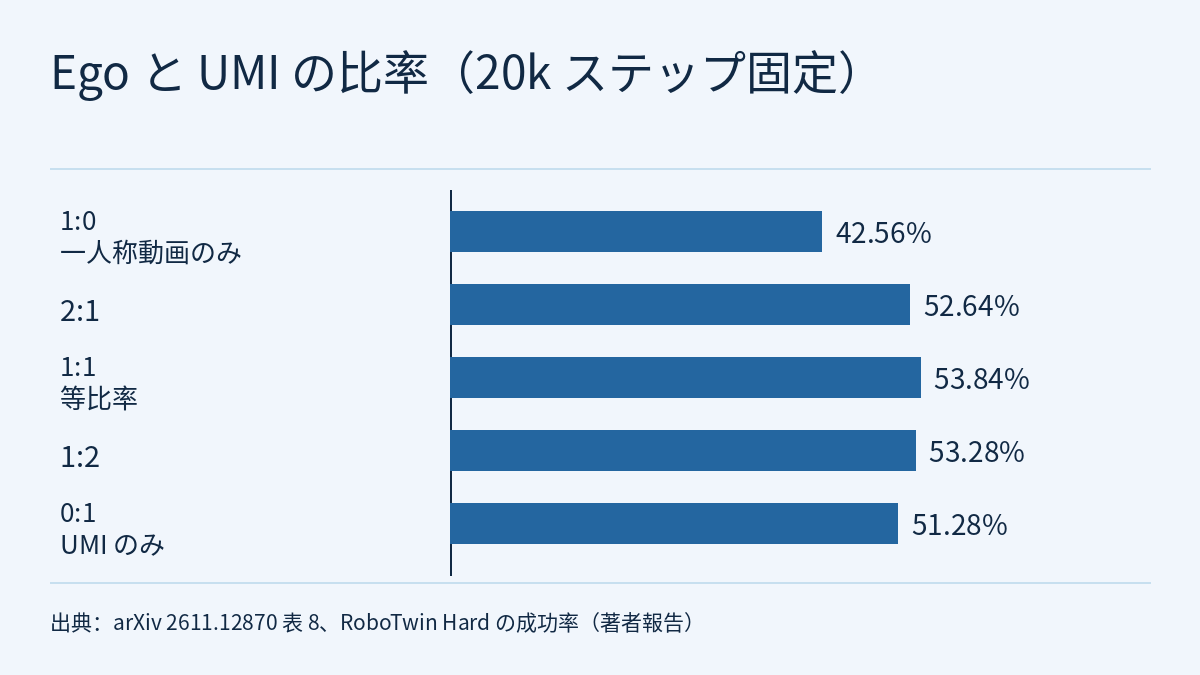
事前学習の予算を 20k ステップに固定し、一人称視点動画(Ego)と UMI の 5 通りのサンプリング比を比べています(表 8)。1:0 は 42.56%、2:1 は 52.64%、1:1 は 53.84%、1:2 は 53.28%、0:1 は 51.28% です。3 つの混合はいずれもどちらか一方だけの場合を上回り、等比率が最も高く、UMI のみより 2.56 ポイント高い結果です。1 つのソースの学習量を増やした場合(表 7)、UMI を固定して Ego を加えていくと(総ステップ数 10k、20k、30k)Hard は 49.68%、53.84%、55.60%、Ego を固定して UMI を加えていくと 42.08%、53.84%、51.20% で、最後の段階では下がっています。著者の表現は「generally improves」です。混合学習の前に一般動画だけで 25k ステップの移行学習を入れると、Hard は 53.84% から 56.48% に上がります。
モデル構造の比較(表 9)は 30k ステップの多ソース事前学習で行っています。動画と動作が残差ストリームを共有する Single-stream は 52.56%、標準の Dual-stream は 52.48%、動作ブランチが動画の特徴を通してだけ言語を受け取る Dual-stream は 57.36% で、標準の Dual-stream より 4.88 ポイント高くなっています。Easy ではこの変種がかえって最も低く、Single-stream 86.48%、標準の Dual-stream 84.96%、この変種 84.80% です。別の実験では、20k ステップ・Ego と UMI の等比率という設定で、CLIP、DINOv2、SigLIP2、Qwen3-VL 2B の画像特徴をクロスアテンションで追加すると、Hard はネイティブ入力の 49.52% から 39.76%〜42.96% に下がりました。著者は、この新しい融合経路が言語と動画の事前学習を経ていないため、モデルが現在の学習分布の見た目の手がかりに頼りやすくなる可能性があると説明しています。論文の表現は「may」です。
事前学習の規模は学習に使った動画の時間で測り、50k ステップがおよそ 45k 時間の動画に相当します。RoboTwin では、多ソース事前学習後の Hard の最高値が 59.60% で、事前学習なしでは 34.56% です。実機では、Hard 設定の 3 タスク平均の SR と PSR が、学習動画を 22.5k 時間から 90k 時間に増やすにつれて 33.33% と 46.90% から 48.89% と 61.43% に上がり、0 時間の設定ではどのタスクも完了できませんでした。Ego と UMI で 75k ステップ事前学習したあと、ロボットのデータで 25k ステップ追加学習すると、RoboTwin の Hard は 61.52% になります(表 10)。
主な結果:RoboTwin の 50 タスクと実機の 3 タスク
RoboTwin 2.0 の 50 タスクにはそれぞれ 50 本の Clean デモがあり、合計 2,500 本です。事前学習済みチェックポイントから、全タスクをまとめて 1 つのモデルを 20k ステップ事後学習し、主な結果は各タスク・各設定で 100 エピソードを実行しています。表 11 の一部を示します。
| モデル | RoboTwin Easy | RoboTwin Hard | 実機 Easy SR / PSR | 実機 Hard SR / PSR |
|---|---|---|---|---|
| SWAM(Ours) | 88.10% | 61.56% | 56.67% / 68.57% | 40.00% / 50.36% |
| OpenWAM | 89.30% | 48.70% | 37.78% / 46.35% | 23.33% / 31.67% |
| π0.5 | 70.66% | 46.00% | 50.00% / 71.87% | 20.00% / 37.78% |
| LingBot-VA | 77.04% | 36.16% | 41.11% / 53.61% | 10.00% / 24.01% |
| Fast-WAM | 77.76% | 1.92% | 35.56% / 49.33% | 6.67% / 14.52% |
RoboTwin では、SWAM の Hard は OpenWAM より 12.86 ポイント高く、Easy は 1.2 ポイント低く、2 つの設定の平均は 74.83% です。実機実験では双腕の Flexiv Rizon 4 でカップ積み、タオルたたみ、ギフトの箱詰めの 3 タスクを行いました。タスクごとに上流の事前学習済み重みから別々のモデルを 50k ステップ適応させ、すべてのモデルが同じタスクデータを使います。Easy は見慣れた物体の位置だけを変え、Hard は物体、背景、またはその両方を変えます。各タスク・各設定で、事前に固定して全モデルで共有する 10 通りの配置を使い、配置ごとに 3 回、計 30 回試行します。動作は 30 Hz で同期実行します。Hard では SWAM の SR が OpenWAM より 16.67 ポイント、PSR が π0.5 より 12.58 ポイント高くなっています。Easy では π0.5 の PSR(71.87%)が SWAM(68.57%)を上回っています。論文には、物体やシーンを変えた果物の配置と色違いのカップ積みの実行例も載っていますが、成功率は示されていません。
差を読む前に計算しておくべきサンプル数
以下は論文に書かれた評価回数から本サイトが行った見積もりで、論文の数値ではありません。アブレーションの各設定は 50 タスク × 25 エピソード = 1,250 エピソードです。エピソードを独立な試行とみなすと、成功率が 50% 前後のとき標準誤差は約 1.4 ポイント、95% Wald 区間の半幅は約 2.8 ポイントです。独立に評価した 2 つの設定の差を比べる場合、差の 95% 半幅は約 √2 × 2.8 ≈ 3.9 ポイントです。この尺度では、1:1 と 1:2 の差(0.56 ポイント)、キャプションを入れ替えたときの低下(1.52)、エピソード単位とサブタスク単位のキャプションの差(1.92)、等比率と UMI のみの差(2.56)は、いずれも標本変動の範囲に収まります。構造変更による 4.88 は 3.9 を上回りますが、その幅は大きくありません。外部の画像特徴を加えたときの低下(6.56〜9.76)と事前学習の有無による 25.04 は、はっきり大きい差です。この見積もりは評価エピソードの標本抽出だけを考えたもので、学習の乱数シードによるばらつきは含みません。本サイトが読んだ本文には、複数シードの結果や信頼区間の報告はありません。
主な結果は各設定 5,000 エピソードで、Hard 61.56% の標準誤差は約 0.7 ポイントです。12.86 ポイントの差に比べれば小さい値です。実機では各モデル・各設定が 3 タスク × 30 回 = 90 回です。どのタスクも試行回数が同じなので、40.00% と 23.33% は 90 回中 36 回と 21 回の成功に当たり、40% 付近の単一群の 95% Wald 半幅は約 10 ポイントです。全モデルが同じ配置を使っているので、配置ごとの対応のある比較ならもっと狭くなりますが、論文は配置ごとの結果を示していません。区間の手計算は フィジカルAIラボ 2.8 で扱っています。
制約と注意点
- これは arXiv のプレプリントで、数値はすべて著者報告 [R] です。本サイトでは再現していません。論文は整理済みのデータ、学習コード、モデルの重みを公開するとしています。本サイトはこれらの公開物を開いて確認しておらず、読んだ本文には、公開内容に自前収集の 15,284.9 時間の UMI データが含まれるかどうかの項目別の説明はありません。
- キャプションの詳しさ(表 4)、動作ラベルの付与率(表 6)、混合比(表 8)、構造(表 9)の各アブレーションは、それぞれ 1 つの固定予算(20k または 30k ステップなど)と 1 つの構成で比較しており、結論が当てはまるのはその設定の範囲です。表 5 の事前学習ステップ数は本文に書かれていません。キャプションは Qwen 3.8 Max と Seed 2.1 Pro で生成されており、ほかのキャプション生成モデルでの効果は論文では検証されていません。
- 実機のスケーリング曲線では 90k 時間で Hard SR が 48.89% ですが、表 11 の SWAM の実機 Hard SR は 40.00% です。RoboTwin でも表 10 の最終行(88.08%、61.52%)と表 11(88.10%、61.56%)にわずかな違いがあります。本サイトが読んだ本文には、主表がどのチェックポイントに対応するかの説明はありません。スケーリング実験は Ego と UMI のデータを使い、主表は多ソースデータ全体で事前学習したと書かれています。
- 本文中の表番号の参照と表のキャプションの番号が一致しない箇所があります。たとえばキャプションの実験は本文では Table 6 と書かれていますが、該当する表のキャプションは Table 4 です。本記事ではキャプションの番号で引用しています。
- 実機の結果は 1 つのプラットフォーム、3 つのタスクによるもので、タスクごとに別々に事後学習したモデルを使っています。果物の配置と色違いのカップ積みは実行例で、統計的な結果ではありません。シミュレーションと実験室の実機での成功率は、いずれもハードウェアの安全性検証ではありません。
- 著者が挙げている制約:この手法は複雑な推論や明示的な多段階の計画への対応が限られ、履歴の文脈が短いため長いタスクの実行が妨げられる可能性があります。今後は記憶の仕組みと階層的な計画を検討するとしています。
リンク
- SWAM: Scaling World Action Models with Cross-Modal Alignment(arXiv 2611.12870)
- 論文の HTML 版全文
- フィジカルAIラボ 1.5:データはどこから来る?――SO-101 のメタデータからお手本の長さを求め、三つの入手ルートの単位と動作空間を見分ける
- フィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求める
- フロンティア・レーダー|HWAM:人型ロボットの参照動作は実際の動きと一致しない――実行後の身体状態を動作と同時に生成する
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)


