
プレプリント VLA Adaptation with Real and Simulated Data: A Case Study on Robotic Chess(arXiv 2611.12676、2026-11-09、Matěj Kripner と Milan Straka、プラハのカレル大学数学物理学部)は、一つの狭いタスクを使って、VLA をファインチューニングするときによく出る実務上の問いに答えています。お手本を何件集めるか、どれだけ学習させるか、どのチェックポイントを配備するか、シミュレーションのデータを使う価値があるか、という問いです。低価格の SO-101 アームが「Move the king from e4 to a5」のような指示に従ってチェスのキングを動かし、モデルは π0.5 です。著者が報告する結論は四つあります。チェックポイントは学習率をゼロまで下げてから比較する必要があり、そうしないと同じ学習の結果が最大 31 ポイント違います。検証損失とオフラインの行動誤差では良いモデルを選べません。実機のお手本が少ないときほど、シミュレーションのお手本での事前学習が効きます。方策自身のロールアウトでさらに学習しても、測定できる改善はありませんでした。以下の数値はすべて著者の報告 [R] で、本サイトでは再現していません。
タスク、アーム、シミュレーションの双子
指示には移動元と移動先のマスの名前しか含まれません。方策は見えている盤面上でその 2 マスを見つけ、キングをつかみ、運び、置いて、待機姿勢に戻ります。盤は木製で 1 マス 31 mm、キングは高さ 64 mm、台座 20 mm です。著者はこのタスクが SO-101 にとって難しい理由を挙げています。マスの位置は名前からしかわかりません。アームの姿勢は根元近くの深く折りたたんだ状態から奥の段でほぼ伸び切った状態まで大きく変わります。グリッパーは固定指 1 本と可動ジョー 1 つで、キングの軸から数ミリずれてつかむと倒してしまいます。3D プリントのリンクは負荷で最大 2 cm たわむため、視覚のフィードバックなしでは正確に位置決めできません。
実機にはカメラが 2 台あります。1 台は手首に付けてグリッパーの方向を向き、もう 1 台は盤の上に固定しています。どちらも魚眼レンズで、画像はシミュレーターのピンホールカメラモデルに補正してから方策に渡します。シミュレーターは実機の MuJoCo の双子で、アームの運動学とサーボの動力学、実測した盤の位置姿勢、スキャンしたキング、2 台のカメラの位置姿勢と視野を再現していますが、プリントしたリンクのたわみはモデル化していません。
シミュレーションのお手本は、ランダム化したスクリプトのエキスパートが作ります。著者の理由は、モーションプランナーは同じ手を毎回まったく同じに実行するため、遠隔操作に似ず、模倣学習に必要なばらつきも得られないというものです。そこでエキスパートは人間の操作者をまねます。知覚の誤差を含んだまま目標へ手を伸ばし、遅延の後に残った誤差を観測して修正し、誤差が許容値を下回るまで繰り返します。エピソードごとにテンポ、誤差、許容値、把持のパラメーターを独立にサンプリングし、つかみ損ねたらジョーを開いてやり直します。このエキスパートの成功率は 93% です。
方策は π0.5 から始めます。π0.5 は SO-101 で事前学習されていません。入力は 2 台のカメラ画像、6 つの関節位置、指示、現在の段階で、出力は 15 Hz の関節目標 50 個からなる行動チャンクです。そのうち 10 個を実行してから計画し直します。著者は行動エキスパートと言語モデル、つまり 4.1B パラメーターのうち 2.7B をファインチューニングし、視覚エンコーダーは凍結しています。言語モデルは、1 手の 5 つの段階のどこにいるかも 1 トークンで予測します。テスト時には行動チャンクごとに現在の段階と次の段階を採点し直し、次の段階が 2 回続けて勝ったら移ります。
シミュレーションでの規模:データも更新回数も足りている必要がある
シミュレーションのお手本は約 11.4k 件で、キングはマスの中で最大 8 mm ずれており、93% が成功です。学習セットは成功例の入れ子の部分集合で n = 100、316、1,000、3.2k、10k、ほかに成功例 30 件を検証用に残しています。すべての学習は 500 ステップのウォームアップ後に 3 × 10⁻⁵ の一定の学習率、グローバルバッチ 32 フレームです。更新回数の予算は 1,000 から 165k(最大のデータセットのちょうど 1 エポック)までの幾何級数で 8 段階とし、大きい 2 つのデータセットは 237k まで延ばしています。各設定は 1 回だけ学習します。各モデルは決まった手順の 1,000 回の閉ループ試行で評価し、成功率には Wilson 95% 区間を付けています。成功率 30–60% のあたりで約 ±3 ポイントです。
結果は二つの軸で読めます。
- 更新回数が約 4k 未満では、データ量にかかわらずどのモデルも一度も成功しません。
- 更新回数が少ないうちはデータを増やしてもほとんど効きません。9k 更新では、お手本 1,000 件と 10k 件で成功率は 10% と 11% です。
- 著者のグリッドでは、小さいデータセットは最初のエポックを終えるまでは大きいデータセットと同じ性能で、その後に差がつきます。多エポックの学習はそれでも役に立ち、評価のノイズを超えて成功率を下げた例はありません。
- 165k 更新(すべて学習率を下げた後)での成功率は、5 つのデータ規模の順に 9.9%、22.0%、31.7%、39.7%、60.2% です。お手本 10k 件で 237k 更新まで学習すると 64.1% で、まだ上がり続けています。
二つの比較はお手本 10k 件の規模だけで行われています。π0.5 のロボット事前学習を外したモデル(視覚言語モデルは PaliGemma から初期化し、行動エキスパートはランダムに初期化)も 59.5% に達します。それぞれ標準のレシピでファインチューニングすると、π0 は 77.7%、SmolVLA は 54.5% です。著者は、これらのレシピは本論文のものと異なるため、この数値はモデルとレシピをまとめて比べたものであり、データが少ない場合にはロボット事前学習がまだ効く可能性があると注記しています。
チェックポイントの選び方:先に学習率を下げ、オフライン指標には頼らない
著者はデータ規模ごとに一定の学習率の幹を 1 本走らせ、各予算の 90% の時点でチェックポイントを残し、そこから枝分かれさせて残り 10% の更新で学習率をゼロまで下げます。お手本 10k 件では、165k 更新で終わるクールダウンの枝が 60%、その出発点の一定学習率のチェックポイントは 29% でした。要旨の「最大 31 ポイント」はこの差です。幹自身の 165k 更新のチェックポイントは 49% です。幹の成功率は更新回数に対して単調ではなく、幹のチェックポイントで早期終了すると、クールダウンで到達できる成績より 18 ポイント低いモデルを選ぶことになります。初期の結果では、同じ区間の更新に確率的重み平均(SWA)をかけてもほぼ同じ効果があり、57% 対クールダウンの 60% でした。
オフライン指標の問題はもっとはっきりしています。お手本 100 件では、検証損失は約 2k 更新で最小になり、学習の終わりまでに 2 倍以上に増えますが、成功率は 0 から 10% に上がります。検証損失で選ぶと成功率ゼロのモデルが返ってきます。開ループの行動誤差は単調に下がりますが、モデルを区別できません。約 79k 更新では 5 つのデータ規模すべてで誤差は 22–24 mm ですが、クールダウン後のモデルの成功率は 8% から 48% まで開いています。
マイルストーン別に見ると、つかんだ後の失敗の大半はキングを倒したもので、全試行の約 3 分の 1 にあたります。クールダウンで主に良くなるのは把持と配置です。著者は結論で、自分たちの設定ではファインチューニングの選択は多数の試行による閉ループ評価でしか判断できず、シミュレーターがそれを手の届くコストにしたと書いています。フィジカルAIラボ 2.3 では SmolVLA のファインチューニングに向けたお手本の準備と、各数字が何を測ったかの確認を扱いました。この論文が補うのは学習の後の段階で、どのチェックポイントを配備するか、そして損失曲線だけで決められない理由です。
実機:実データが少ないときほどシミュレーション事前学習の差が大きい
著者の 1 人がリーダーアームで遠隔操作し、キングの移動を 261 回記録しました。移動元と移動先のマスはランダムに選び、キングはシミュレーションのデータと同じくマスの中心から最大 8 mm ずらして置いています。そのうち 259 回が成功で、これが実機データセットになります。動作の合計は約 30 分です。ファインチューニングは二つの初期値から始めます。公開されている π0.5 そのもの(以下、ベース初期化)と、シミュレーションのお手本 10k 件で 237k 更新まで学習してクールダウンした、シミュレーション成功率 64% のモデル(以下、シミュレーション事前学習初期化)です。実データは 32、128、256 件の入れ子のランダムな部分集合とし、レシピはシミュレーションと同じです。幹を 45k 更新まで走らせ、2k、15k、45k の各予算の 90% でチェックポイントを残してそれぞれクールダウンし、さらに幹を 75k 更新まで延ばしてクールダウンしたモデルを 1 つ加えています。
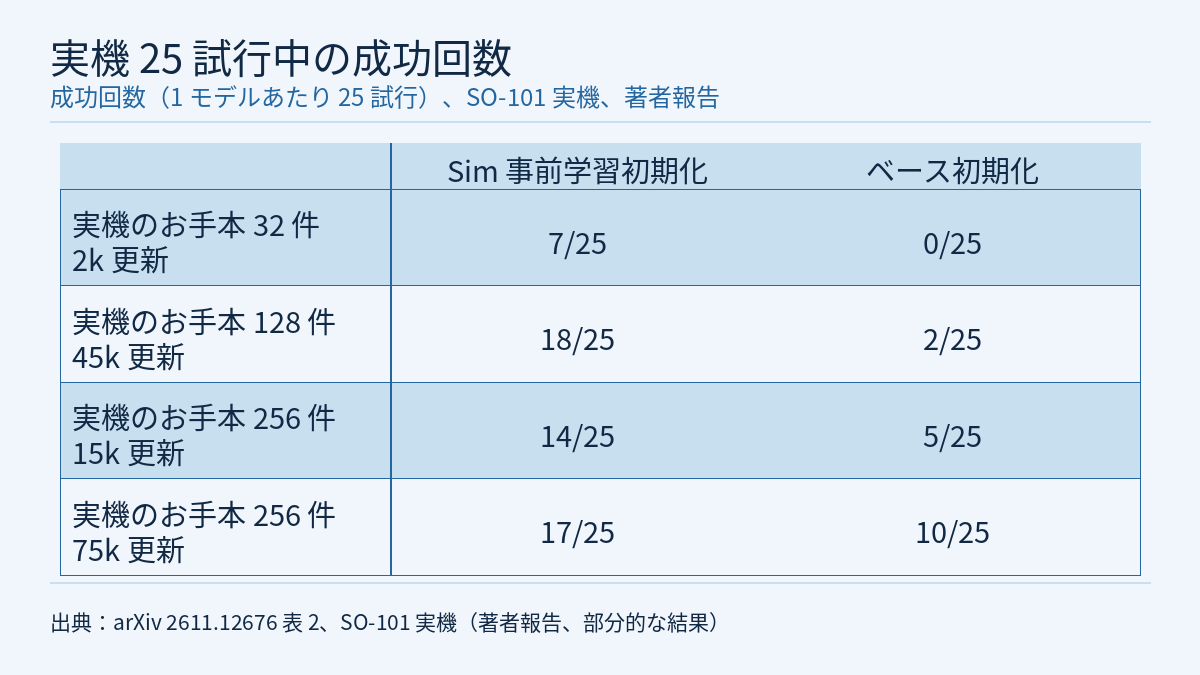
どのモデルも同じ 25 回の試行、つまりシミュレーターの易しい手順の最初の 25 手を、キングをマスの中央に置いて実行します。方策は自律的に動きますが、配備時の推論レイテンシのため、お手本の 3 分の 1 のテンポで動きます。制御時間が 60 s を超えた試行は失敗とし、失敗した試行は捨てません。評価者はキングを戻し、到達した最高のマイルストーンを判定するだけです。結果は部分的で、評価したのは 10 モデル、5 組です(論文の表 2。各セルは 25 回中の回数)。
| 実機のお手本 | 更新回数 | シミュレーション事前学習:接触 | 把持 | 成功 | ベース:接触 | 把持 | 成功 |
|---|---|---|---|---|---|---|---|
| 32 | 2k | 25 | 12 | 7 | 6 | 0 | 0 |
| 128 | 45k | 25 | 24 | 18 | 15 | 8 | 2 |
| 256 | 15k | 25 | 23 | 14 | 23 | 13 | 5 |
| 256 | 45k | 25 | 22 | 14 | 23 | 17 | 10 |
| 256 | 75k | 25 | 23 | 17 | 24 | 15 | 10 |
5 組すべてでシミュレーション事前学習初期化のほうが良い結果でした。お手本 128 件では成功 18/25 対 2/25 です。お手本 32 件では、シミュレーション事前学習初期化が 7/25 成功し、ベース初期化は一度もキングをつかめず 0/25 でした。お手本 256 件では差が縮まり、シミュレーション事前学習初期化が 14/25 から 17/25、ベース初期化が 5/25 から 10/25 です。著者は、1 モデルあたり 25 回しか試行していないので大きな差だけを解釈すると明記しています。フィジカルAIラボ 2.8 では、この規模の成功率に Wilson 区間を付ける計算を扱いました。表のどの差が信頼できるかを判断するのに使えます。
シミュレーションと実機の違いのうち、著者が対処したのは二つです。魚眼の画像は学習と配備の両方でシミュレーターの内部パラメーターに補正しています。実機キャリブレーションの関節ゼロ点はシミュレーターと関節ごとに一定のずれがあり、実機データセットの統計量による正規化で吸収しています。対処していないものも二つあります。実機の方策はお手本の 3 分の 1 のテンポで動き、シミュレーターは 15 Hz の関節目標をステップとして適用するのに対し、実機のコントローラーは補間します。さらに、記録のフレームレートはセッションによって毎秒 15 から 23 フレームとばらつき、30 として保存されたため、方策は見かけのテンポが混ざったデータで学習しています。フィジカルAIラボ 2.5 では sim2real のドメインランダム化とシステム同定を扱いました。この論文は、どの違いを補正で消し、どれを残したかの具体的な一覧になっており、それでもシミュレーション事前学習は実機での結果を改善しています。
否定的な結果:方策自身のロールアウトでの再学習
著者はシミュレーションで、方策が自身のロールアウトから改善するかを調べました。あるデータ規模で最も良い行動クローニングのモデル(165k 更新)を収集時と同じ分布の新しい手で動かし、判定結果付きですべての試行を記録し、ベースモデルからお手本とロールアウトを合わせて学習し直します。ラウンドは 2 つです。1K+1K はお手本 1,000 件に成功率 32% のモデルのロールアウト 1,000 件を加え、10K+10K はお手本 10k 件に成功率 60% のモデルのロールアウト 10k 件を加えます。比較対象は、お手本だけで同じ更新回数学習した行動クローニングです。
- Filtered BC(成功したロールアウトだけを追加):1K+1K では 79k 更新で 33% 対行動クローニングの 30%、165k 更新で 34% 対 32% です。中間の 2 つの予算では約 3 ポイント上回りますが、最大の予算では上回りません。
- RECAP 型のアドバンテージ条件付け(価値関数によるラベル、交差適合した価値関数によるラベル、結果によるラベルの 3 種):79k 更新で 30–31% で、行動クローニングと同等です。方策はラベルを実際に使っており、結果ラベルのモデルは正のラベルでサンプリングすると 30%、ラベルなしで 26%、負のラベルで 24% です。classifier-free guidance は β = 1.5 で 31%、β = 2.5 では 23% に下がります。10K+10K のラウンドでは、結果ラベルが 79k 更新で 46%、行動クローニングが 48% です。
- 価値関数:方策の 3B のバックボーンを使い 2 エポック学習した大きな価値関数は、学習用エピソードを記憶してしまい、未知のエピソードでは偶然と同じ精度でした。著者は小さな価値関数を 1 エポックだけ学習させる方法に切り替え、保留したエピソードでは、開始から 4 秒(把持の前)の時点で AUC 0.85 で成功と失敗を区別できています。
- 自動コーチによる修正:元の RECAP では人がロールアウト中に方策を修正します。著者はこれをシミュレーション内のモニターで置き換えました。キングが傾くか滑ったとき、つかみ損ねたとき、またはキュー中の行動の前方シミュレーションが転倒を予測したときに、制御をスクリプトのエキスパートに渡し、立て直した後に方策へ戻します。修正付きのロールアウト約 1,000 件で学習すると、修正付き RECAP は難しい手順で 35% と行動クローニングの 30% を上回りました(対応のある McNemar 検定、p < 0.02)が、易しい手順では 46% 対 50% でした。
- 残差強化学習:シミュレーターの特権状態から PPO で学習した小さなネットワークが、凍結した方策の行動に最大 3° の関節オフセットを加えます。報酬と探索ノイズを変えた 4 回の実行のいずれでも、成功率は初期値から評価ノイズの範囲内にとどまりました。
著者の結論は、自分たちの設定ではどの方法も通常の行動クローニングに対して測定できる改善をもたらさず、ラベル付きの変種だけが見る失敗したロールアウトにも測定できる効果はなかった、というものです。制約の節には、ここでの RECAP の変種は元の手法にあるアドバンテージ条件付きの事前学習と人による修正を省いていると書かれており、この否定的な結果は著者が実装した版についてのものです。
制約と注意点
- arXiv のプレプリントです。数値はすべて著者の報告 [R] で、本サイトでは再現しておらず、公開されたシミュレーターやデータも動かしていません。
- タスクは 1 つで、各設定は 1 回しか学習していないため、学習シード間のばらつきはわかりません。
- 実機の証拠は限られています。1 モデルあたり 25 回の試行で、評価したのは 10 モデルだけであり、著者自身が部分的な結果としています。実機の評価ではキングをマスの中央に置いていますが、学習データではキングが中心から最大 8 mm ずれているため、評価はずれた配置を含んでいません。
- スクリプトのエキスパートはランダム化されていますが、人間のお手本との類似度は厳密に測定されていません。論文は、人間の操作者の軌跡のばらつきが同程度で、運ぶ経路はよりまっすぐだと述べるにとどまります。
- シミュレーションでの π0、SmolVLA、ロボット事前学習なしの比較はお手本 10k 件の規模だけで、それより小さいデータセットには当てはめられません。
- 成功率はすべてタスク達成の指標で、アームの動作の安全性検証は含みません。シミュレーションの結果は実機や安全性の検証ではありません。
リンク
- VLA Adaptation with Real and Simulated Data: A Case Study on Robotic Chess(arXiv 2611.12676)
- 論文の HTML 全文
- 論文に記載のコードリポジトリ:kripner/vla-chess(シミュレーターとスクリプトのエキスパート)
- 論文に記載の実機お手本データセット(LeRobot 形式、261 エピソード)
- フィジカルAIラボ 2.3:SmolVLA をファインチューニングする――指示に合わせてお手本を計画し、各数字が何を測ったかを確かめ、非同期の動作キューの時間を計算する
- フィジカルAIラボ 2.5:sim2real のドメインランダム化とシステム同定――二本の論文の数字を元の設定に戻し、コップを押した一本の軌跡から摩擦を手で求める
- フィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求める


