
预印本 VLA Adaptation with Real and Simulated Data: A Case Study on Robotic Chess(arXiv 2611.12676,2026-11-09,Matěj Kripner 与 Milan Straka,布拉格查理大学数学与物理学院)用一个窄任务回答微调 VLA 时常见的几个实际问题:要多少示范、训练多久、部署哪个检查点、仿真数据值不值得用。任务是让一台低成本 SO-101 机械臂按“Move the king from e4 to a5”这类指令搬动国际象棋的王,模型是 π0.5。作者报告的结论有四条:比较检查点之前要先把学习率降到零,否则同一次训练的成绩最多差 31 个百分点;验证损失和离线动作误差选不出好模型;真实示范少时,先在仿真示范上预训练帮助最大;在策略自己的 rollout 上再训练,没有带来可测的提升。以下数字均为作者报告 [R],本站未复现。
任务、机械臂与仿真孪生
指令只给出起点和终点格子的名字,策略要在看到的棋盘上找到这两个格子,再抓起、搬运、放下王,最后回到准备姿态。棋盘是木质的,每格 31 mm;王高 64 mm,底座 20 mm。作者列出这个任务对 SO-101 难在哪里:格子只能从名字推出位置;臂的姿态从靠近底座时的深度折叠到远端几乎完全伸直,变化很大;夹爪是一根固定指加一个活动钳口,抓取偏离王的中轴几毫米就会把它碰倒;3D 打印的连杆受载时最多弯 2 cm,没有视觉反馈就无法精确定位。
真机用两台相机:一台装在腕部,沿夹爪方向看;一台固定在棋盘上方。两台都是鱼眼镜头,画面先校正到仿真器的针孔相机模型再给策略。仿真器是真机的 MuJoCo 孪生,复现了臂的运动学和舵机动力学、实测的棋盘位姿、扫描得到的王,以及两台相机的位姿和视场,但不模拟打印连杆的柔性。
仿真示范来自一个随机化的脚本专家。作者的理由是,运动规划器每次执行同一步棋都一模一样,既不像遥操作,也给不了模仿学习需要的多样性,所以让专家模仿人类操作员:带着感知误差伸向目标,经过一段延迟后观察剩余误差并修正,直到误差小于容差。每个 episode 各自采样节奏、误差、容差和抓取参数;抓空时专家会松开重试。这个专家的成功率是 93%。
策略从 π0.5 开始,它没有在 SO-101 上预训练过。输入是两路相机画面、6 个关节位置、指令和当前阶段;输出是 15 Hz 下 50 个关节目标组成的动作块,执行其中 10 个后重新规划。作者微调动作专家和语言模型,即 4.1B 参数中的 2.7B,视觉编码器保持冻结。语言模型还要用一个词元预测当前处于一步棋五个阶段中的哪一个;测试时每个动作块对当前阶段和下一阶段重新打分一次,下一阶段连续两次胜出才切换。
仿真中的规模:数据和更新步数都要够
仿真示范共约 11.4k 条,王在格子内最多偏移 8 mm,其中 93% 成功。训练集是成功示范的嵌套子集,n = 100、316、1,000、3.2k、10k,另留 30 条成功示范做验证。所有训练用 3 × 10⁻⁵ 的恒定学习率(前 500 步预热),全局批量 32 帧;更新预算按几何级数取 8 档,从 1,000 到 165k(最大数据集正好一个 epoch),两个最大的数据集再延长到 237k。每种配置只训练一次。每个模型在固定的走子日程上跑 1,000 次闭环试验,成功率给出 Wilson 95% 区间,在 30–60% 的成功率附近约为 ±3 个百分点。
结果按两个轴看:
- 低于约 4k 次更新时,不论数据多少,没有一个模型成功过。
- 更新步数少时,加数据几乎没用:9k 次更新下,1,000 条和 10k 条示范的成功率分别是 10% 和 11%。
- 在作者的网格里,小数据集在跑完第一个 epoch 之前和大数据集表现一样,之后才落后;多 epoch 训练仍有帮助,没有一次让成功率下降到评测噪声之外。
- 165k 次更新(均已降学习率)时,五个数据规模的成功率依次是 9.9%、22.0%、31.7%、39.7%、60.2%;10k 条示范训练到 237k 次更新时为 64.1%,仍在上升。
两个对照只覆盖 10k 条示范这一档:去掉 π0.5 的机器人预训练(视觉语言模型从 PaliGemma 初始化,动作专家随机初始化)同样达到 59.5%;按各自原配方微调,π0 为 77.7%,SmolVLA 为 54.5%。作者提醒,后两者的配方与本文不同,这些数字是模型和配方一起比较的结果;机器人预训练在小数据集上也可能仍然重要。
选检查点:先降学习率,不看离线指标
作者的训练方式是:每个数据规模跑一条恒定学习率的主干,在每档预算的 90% 处留一个检查点,再从这个检查点分出一支,用剩下 10% 的更新把学习率降到零。在 10k 条示范上,到 165k 次更新结束的降温分支成功率为 60%,它出发时的恒定学习率检查点只有 29%,摘要里“最多多出 31 个百分点”就是这个差值;主干自己在 165k 次更新时为 49%。主干的成功率随更新步数并不单调,如果在主干检查点上做早停,选出的模型会比降温后能达到的成绩低 18 个百分点。初步结果显示,对同一段更新做随机权重平均(SWA)几乎同样有效:57% 对降温的 60%。
离线指标的问题更直接。100 条示范时,验证损失在约 2k 次更新处最低,到训练结束时翻了一倍多,而成功率从 0 升到 10%;按验证损失选模型,得到的是一个成功率为零的模型。开环动作误差倒是单调下降,但区分不了模型:约 79k 次更新时,五个数据规模的误差都在 22–24 mm,降温后模型的成功率却从 8% 到 48% 不等。
按里程碑看失败:抓住之后的失败大多是把王碰倒,约占全部试验的三分之一;降温主要改善的是抓取和放置。作者在结论里写,在他们的设置下,微调中的选择只能靠大量试验的闭环评测来判断,而仿真器让这件事负担得起。物理AI实验室 2.3 讲微调 SmolVLA 时怎样准备示范数据、核对各个数字的口径;这篇论文补上的是训练之后的一步:用哪个检查点去部署,以及为什么不能只看损失曲线做决定。
真机:仿真预训练在真实数据少时差距最大
一位作者用主臂遥操作采集了 261 次搬王,起点和终点格子随机抽取,王放在离格子中心最多 8 mm 处,与仿真数据一致。其中 259 次成功,构成真实数据集,总共约半小时的动作。作者从两个起点微调:发布的 π0.5 本身(下称 base 初始化),以及在 10k 条仿真示范上训练 237k 次更新并降温、仿真成功率 64% 的模型(下称仿真预训练初始化)。真实数据取 32、128、256 条的嵌套随机子集,训练配方与仿真相同:主干跑到 45k 次更新,在 2k、15k、45k 三档预算的 90% 处留检查点并各自降温,主干再延长到 75k 次更新,多出一个降温模型。
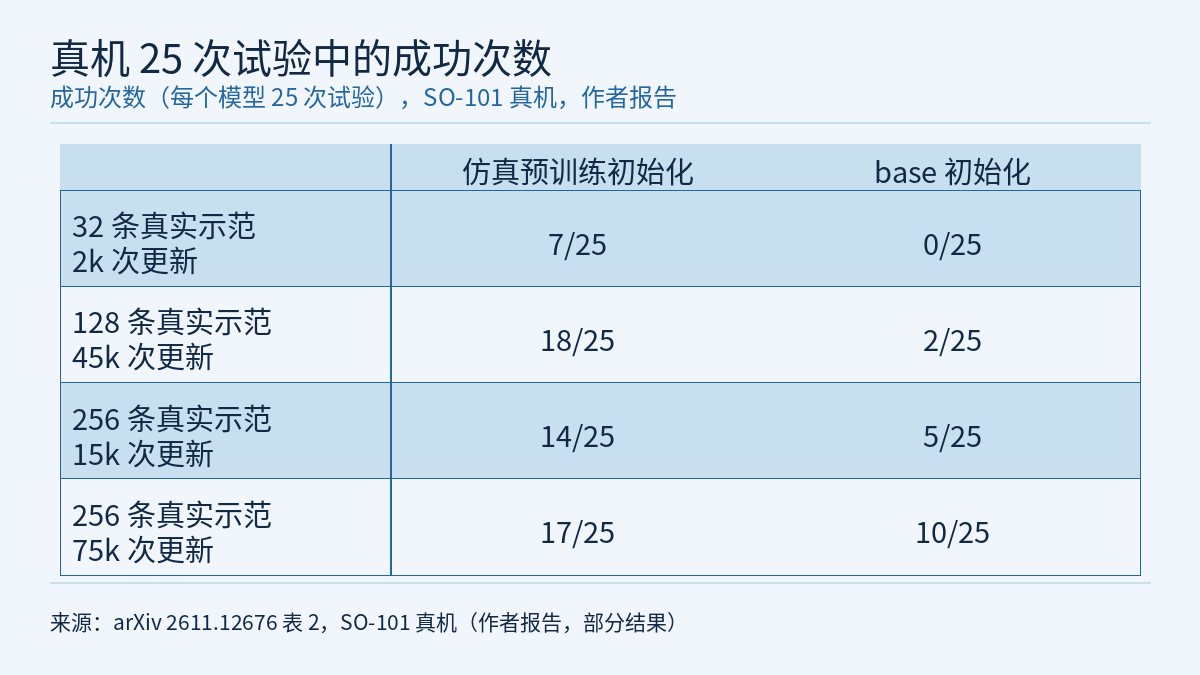
每个模型跑同样的 25 次试验,即仿真简单日程的前 25 步棋,王放在格子正中。策略自主执行,因为部署中的推理延迟,速度只有示范节奏的三分之一;单次试验控制时间超过 60 s 记为失败,失败的试验从不剔除。评测者只负责复位和判定达到的最高里程碑。结果是部分的,共评测了十个模型、五组配对(论文表 2,每格为 25 次中的次数):
| 真实示范 | 更新次数 | 仿真预训练:碰到 | 抓住 | 成功 | base:碰到 | 抓住 | 成功 |
|---|---|---|---|---|---|---|---|
| 32 | 2k | 25 | 12 | 7 | 6 | 0 | 0 |
| 128 | 45k | 25 | 24 | 18 | 15 | 8 | 2 |
| 256 | 15k | 25 | 23 | 14 | 23 | 13 | 5 |
| 256 | 45k | 25 | 22 | 14 | 23 | 17 | 10 |
| 256 | 75k | 25 | 23 | 17 | 24 | 15 | 10 |
五组里仿真预训练初始化都更好。128 条示范时成功 18/25 对 2/25;32 条示范时仿真预训练初始化成功 7/25,base 初始化一次也没抓住王,成功 0/25;256 条示范时差距缩小,仿真预训练初始化成功 14/25 到 17/25,base 初始化 5/25 到 10/25。作者写明每个模型只有 25 次试验,所以只解读大的差异。物理AI实验室 2.8 演示过怎样给这种规模的成功率算 Wilson 区间,可以拿来判断表中哪些差异站得住。
仿真与真机之间的差异,作者处理了两项:鱼眼画面在训练和部署中都校正到仿真器的内参;真机标定的关节零点与仿真差一个固定偏移,用真实数据集的统计量做归一化后被吸收。另有两项没有处理:真机策略以三分之一的示范节奏运行;仿真器把 15 Hz 的关节目标当作阶跃执行,真机控制器则做插值。此外,真机采集时帧率在 15 到 23 帧/秒之间变化,存储为 30,所以策略训练用的是多种表观节奏的混合。物理AI实验室 2.5 讲 sim2real 的域随机化与系统辨识;这篇论文给了一份具体的清单:哪些差异靠校正消掉了,哪些留着没管,而仿真预训练在真机上仍然带来了提升。
负结果:在自己的 rollout 上再训练
作者在仿真中测试了策略能否从自己的 rollout 中进步。做法是取某个数据规模下最好的行为克隆模型(165k 次更新),在采集分布的新走子上运行并记录带判定结果的每次试验,再从 base 模型出发用示范加 rollout 重新训练。共两轮:1K+1K 用 1,000 条示范加成功率 32% 的模型的 1,000 条 rollout;10K+10K 用 10k 条示范加成功率 60% 的模型的 10k 条 rollout。对照是只用示范、相同更新次数的行为克隆。
- Filtered BC(只加成功的 rollout):1K+1K 中 79k 次更新时 33% 对行为克隆的 30%,165k 次时 34% 对 32%;在两个中间预算上领先约 3 个百分点,最大预算上没有。
- RECAP 式优势条件化(价值函数打标签、交叉拟合价值函数、按结果打标签三种):79k 次更新时 30–31%,与行为克隆持平。策略确实用到了标签:按结果打标签的模型用正标签采样为 30%,不给标签 26%,负标签 24%;classifier-free guidance 取 β = 1.5 为 31%,取 β = 2.5 降到 23%。10K+10K 一轮中,按结果打标签在 79k 次更新时为 46%,行为克隆为 48%。
- 价值函数:用策略 3B 主干、训练两个 epoch 的大价值函数记住了训练 episode,对没见过的 episode 判断等于随机;作者改用较小的价值函数只训练一个 epoch,在留出的 episode 上,开始 4 秒(抓取之前)就能以 AUC 0.85 区分成功与失败。
- 自动教练纠正:原版 RECAP 由人在 rollout 中纠正策略,作者在仿真中用一个监视器代替:王倾斜或滑动、抓空、或前向仿真预测会碰倒时,把控制交给脚本专家,修好后再交回。约 1,000 条带纠正的 rollout 上,带纠正的 RECAP 在困难日程上为 35%,高于行为克隆的 30%(配对 McNemar 检验 p < 0.02),在简单日程上却是 46% 对 50%。
- 残差强化学习:一个用 PPO 从仿真特权状态训练的小网络,给冻结策略的动作加最多 3° 的关节偏移;四次运行换了奖励和探索噪声,成功率都停留在初始值的评测噪声范围内。
作者的结论是,在他们的设置下,这些方法都没有比普通行为克隆带来可测的提升,只有带标签的变体能看到的失败 rollout 也没有带来可测的好处。他们在局限里写明,这里的 RECAP 变体省略了原方法的优势条件化预训练和人工纠正,所以这个负结果只针对他们实现的版本。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现,也没有运行作者发布的仿真器或数据。
- 只有一个任务,每种设置只训练一次,所以没有训练种子之间的方差。
- 真机证据有限:每个模型 25 次试验,只评测了十个模型,作者自己称结果是部分的。真机评测时王放在格子正中,而训练数据中王最多偏离中心 8 mm,评测没有覆盖偏移的情况。
- 脚本专家是随机化的,但它和人类示范有多相似没有严格测量;论文只描述人类操作员的路径分散程度与专家相近,搬运路线更直。
- 仿真里的 π0、SmolVLA 和“无机器人预训练”对照只做了 10k 条示范一档,不能推到小数据集。
- 所有成功率都是任务完成指标,不涉及机械臂运动的安全验证;仿真结果不等于真机或安全上的验证。
链接
- VLA Adaptation with Real and Simulated Data: A Case Study on Robotic Chess(arXiv 2611.12676)
- 论文 HTML 全文
- 论文给出的代码仓库:kripner/vla-chess(仿真器与脚本专家)
- 论文给出的真实示范数据集(LeRobot 格式,261 个 episode)
- 物理AI实验室 2.3:微调 SmolVLA,为一句指令配好示范数据,核对每个数字的口径,再给异步动作队列算时间账
- 物理AI实验室 2.5:sim2real 的域随机化与系统辨识,把两篇论文的数字放回原设定,再从一条推杯轨迹手算摩擦
- 物理AI实验室 2.8:可复现评测,手算 Wald 与 Wilson 区间,从 1/√n 定评测次数,再给零失败算出失败率上界


