本节视频
配音由 AI 合成。 视频章节、文字稿与出处
文字稿
文字稿
知行问
机器人学会一个动作之后,能不能靠自己,越练越好?这一集讲 RL 后训练。让模型在真实的试错里,学会从失败里爬起来,越做越好。
从模仿到试错
先说模仿学习。给机器人看很多示范,它照着做。可示范里,很少有出错和补救。为什么模仿会卡?示范多半只覆盖做对的路线。手一偏,进了示范没见过的状态,做错了也不知该怎么办。举个例子。倒咖啡时手一抖,洒了。模仿出来的策略,可能就僵在那儿。强化学习换个思路。让机器人自己试,做得好就多给奖励。它从自己的经验里,学怎么变好。所以关键词是后训练。先用示范打底,再用试错,把策略磨得又稳又快。打底加打磨,缺一不可。
π*0.6 与 RECAP
先看一篇论文。它来自 Physical Intelligence。他们的模型,叫 π-star-0.6。他们的方法,叫 RECAP。论文称,它用优势条件,把强化学习,用到了 VLA 上。优势条件是什么意思?简单说,让模型分清。哪个动作更好,哪个更差。它的数据,来自三处。人给的示范,机器自己跑的。还有人在旁边,随手纠正的。为什么要人纠正?因为纯靠自己试,太慢也太危险。人搭把手,学得更快更稳。效果怎么样?论文称,在部分最难的任务上,吞吐量翻了一倍多。失败率,也大致砍掉一半。这些任务有多真?论文说,它能在真实家庭里叠衣服。还能组装纸箱,用专业机器做咖啡。另一篇论文,更硬核。它直接在真机上,做强化学习,不靠仿真。就在真实世界里,一次次地试。训练要多久?论文称,只要一到二点五小时。就能练出,接近满分的成功率。提升有多大?论文报告,对比模仿学习基线和以往的 RL 方法。它的成功率平均达到两倍,执行速度快了约一点八倍。它的秘诀之一,是人在环里。机器快出错时,人搭把手。这些纠正,也变成学习信号。原来机器人也能吃一堑长一智,从失败里学出本事!
自我改进闭环
把这些串起来,就是一个闭环。看、想、动、拿到反馈,再更新自己。在这个闭环里,最关键的一环是反馈。有了好反馈,策略才知道,该往哪里改。没有反馈,只能瞎试。一圈一圈转下去,策略就自己往上爬。这,就是自我改进。不用每次,都从头教。在仿真里,也能这么练。英伟达的 Isaac Lab,是一个开源框架。它支持强化学习。怎么看 RL 有没有用?做个前后对照。先量成功率,再用强化学习微调,看它涨没涨。有一种训练路线是这样的。先训一个老师,再蒸馏成学生。最后用强化学习,把学生磨好。仿真的好处,是能大量并行,还摔不坏。所以试错,可以又快又便宜。真机和仿真,常常配合着来。仿真里练个八九不离十,真机上再精调。仿真里有个技巧,叫域随机化。把光照、摩擦、质量都随机抖一抖。策略就更抗造。还有个方向,是车队式学习。很多机器人一起干活,把经验汇到一处,一起变强。数据越多,越见过世面。试错的数据很宝贵。跑一次真机,又慢又贵。所以每条经验,都得用足。还有个技巧,叫课程学习。先给简单的,再慢慢加难。别一上来,就挑最难的。真机试错,还得管安全。得有护栏。别让它把自己,或者环境弄坏。人纠正虽好,但也累人。理想的做法是。越到后面,越少要人插手。奖励怎么给,是门手艺。给得太稀疏,学不动。给得太密,又容易学歪。怎么确认真的变强了?要重复多次实验,看结果波动有多大。别被一次好运骗了,配对提升的区间含零,就只能说证据不足。回到咖啡的例子。练过之后,手一抖,它会停一下。扶正,再接着倒。还有一种做法,是离线强化学习。不再边跑边试错。而是从存好的经验里,反复地学。为什么过去很少这么做?因为真实机器人上的 RL,太难稳住。稍不小心,就会发散。那为什么行得通了?因为算法更稳了。也因为有了,人搭把手的流程。还要说清楚。这些多半还是单个技能、单台机器。离通用,还差得远。还没解决的,是代价。真机上的强化学习,慢、贵,还可能真摔坏零件。还有奖励怎么设。奖励一旦设歪,机器人会钻空子。学出你没想要的行为。就算仿真里练得好,搬到真机,也可能水土不服。这就是老问题,sim2real。所以后训练的思路,是先模仿、再试错。让策略,从自己的经验里,继续长大。越用,它就越顺手、越会补救。回顾三点:一,示范少见出错,模仿一偏就卡;RL 从试错学补救。二,RECAP 把 RL 用到了 VLA 上。论文称,在部分最难的任务上,吞吐翻了一倍多,失败大致减半。三,自我改进是个闭环,但真机 RL 又慢又贵,奖励也难设。先学别人,再自己练——机器人也能越挫越勇!策略强了,可长任务里怎么记住、怎么规划?下一集见!
证据与出处
翻倍以上 / 约减半 · 在部分最难的任务上,RECAP 把吞吐量翻了一倍多,失败率大致减半(论文) [R] · arXiv 2511.14759 · π*0.6 / RECAP
叠衣·组装纸箱·咖啡 · π*0.6 经 RECAP 训练后能在真实家庭叠衣服、可靠地组装纸箱、用专业咖啡机做咖啡(论文) [R] · arXiv 2511.14759 · π*0.6 / RECAP
1 到 2.5 小时 · 真实世界 RL:1 到 2.5 小时训练出接近满分的成功率(论文) [R] · arXiv 2410.21845 · HIL-SERL
2 倍 / 1.8 倍 · 与模仿学习基线和以往 RL 方法相比,成功率平均达到 2 倍,执行快 1.8 倍(论文) [R] · arXiv 2410.21845 · HIL-SERL
GPU 并行仿真 · 英伟达 Isaac Lab:GPU 加速的开源机器人学习框架,支持强化学习、示范学习与运动规划 [O] · NVIDIA Isaac Lab 文档
动手与自测
小测公开,答案与解析在作答后显示;图文课里的练习答案需登录查看。
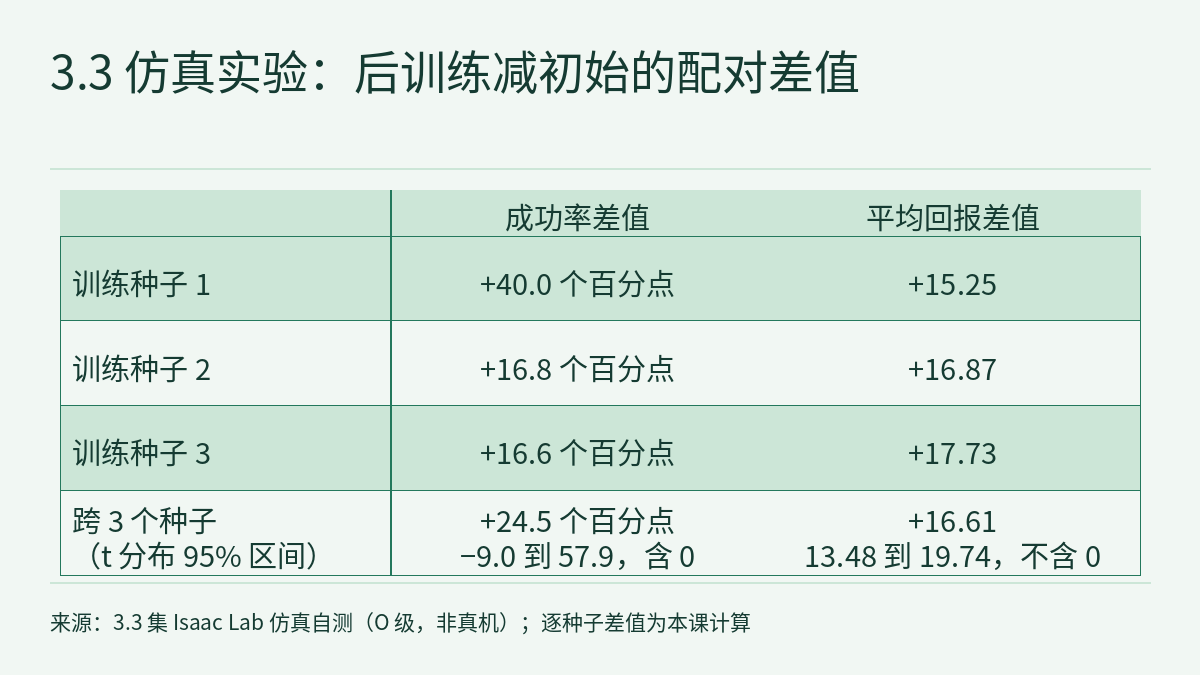
第 3.3 集的视频讲 RL 后训练:示范多半只覆盖做对的路线,模仿出来的策略一偏离示范就容易卡住;强化学习让策略从自己的经验里学会补救,所以先用示范打底,再用试错打磨。片中引了两篇论文:Physical Intelligence 的 π*0.6 与 RECAP(arXiv 2511.14759),UC Berkeley 的 HIL-SERL(arXiv 2410.21845);还用本课程自己在 Isaac Lab 里跑的一次仿真实验,说明怎样确认策略真的变强了。本篇是这一集的图文课与练习,不重复文字稿,只做视频给了结论、没有展开的三件事:把 HIL-SERL 的“1 到 2.5 小时”“2 倍”“1.8 倍”放回论文写明的系统、基线和任务范围;用一个虚构的工作站算清 RECAP 摘要里的“吞吐量翻一倍多”和“失败率大致减半”为什么是两个量;再用实验记录公开的逐种子数字,亲手复算成功率和回报的配对 95% 区间,看成功率为什么只能记“证据不足”。贯穿全文的规则:一个倍数只属于报告它的系统、基线和指标;分母不同,就不能互相换算,也不能拼成一个结论。
本节视频、文字稿与出处在本页上方,全季安排见课程大纲。上一课物理AI实验室 3.2:世界模型,用 Cosmos 造数据,写清每种生成以什么为条件,把 78.3% 放回人类评审,再给生成数据定验收规则结尾问:练出来的策略,怎么在试错里越变越强?本课接着回答。误差怎样滚出示范覆盖范围,物理AI实验室 1.6:模仿学习,手算误差怎样滚出示范覆盖范围,再把 ACT、扩散策略与数据规模律的数字放回各自条件已经手算过;回报怎样累计、奖励怎样被钻空子,物理AI实验室 1.7:强化学习,手算一局回报看奖励怎样被钻空子,再读论文里的地形课程与超时重置讲过;Isaac Lab 的并行训练,物理AI实验室 2.4:在 Isaac Lab 里并行练走路,读懂基准表的三列 FPS,再从训练命令算出总步数讲过;域随机化与 sim2real,物理AI实验室 2.5:sim2real 的域随机化与系统辨识,把两篇论文的数字放回原设定,再从一条推杯轨迹手算摩擦讲过;配对表和 Wilson 区间,分别在物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账和物理AI实验室 2.8:可复现评测,手算 Wald 与 Wilson 区间,从 1/√n 定评测次数,再给零失败算出失败率上界里算过。本课不再重复这些,只讲 RL 后训练的三份证据各自量了什么,以及跨训练种子的 t 区间怎样算。实验的协议和结果全文见物理AI实验室 3.3 实验记录:Isaac Lab 仿真 3 个种子。站内雷达前沿雷达|在 SO-101 上微调 π0.5 搬国际象棋王:先降学习率再比检查点,仿真预训练在真实数据少时帮助最大,自身 rollout 再训练没有可测提升介绍的是另一篇预印本、另一台机器人和另一套设置,它的结果不能与本课的数字合并。下一集 3.4 讲长程任务:记忆、规划与多策略路由。
公开小测的 5 道题附完整解析;登录后可完成三项练习:用实验记录的逐种子数字复算配对 95% 区间,再估算要几颗训练种子;给一台虚构的咖啡工作站算吞吐量、成功率和失败率,审四句倍数说法;审一份虚构的真机 RL 后训练计划,把它改写成可以检查的协议。每项都附分步解法、常见错误与 20 分评分标准。
一、HIL-SERL:“1 到 2.5 小时”和“2 倍”各带着哪些条件
HIL-SERL 的论文是 arXiv 预印本,作者 Jianlan Luo、Charles Xu、Jeffrey Wu 和 Sergey Levine 来自 UC Berkeley。按本课程的分级属 R 级,以下都是作者报告,本站没有复现。片中两张数字卡对应摘要里的两句,各自独立摘录:
learn policies that achieve near-perfect success rates and fast cycle times within just 1 to 2.5 hours of training.
We show that our method significantly outperforms imitation learning baselines and prior RL approaches, with an average 2x improvement in success rate and 1.8x faster execution.
引言里还有一句,写明了和模仿学习比较时的条件:
Our trained RL policies greatly outperform imitation learning methods that are trained on the same amount of human data, e.g., same number of episodes of demonstrations or corrections, on average 101% improvement in terms of success rate and 1.8x faster in cycle time.
读这几个数字要注意四点。第一,“提升 101%”就是变成原来的 2.01 倍,和摘要的“2 倍”一致;引言写明对照的是用同样多人类数据(同样回合数的示范或纠正)训练的模仿学习。摘要还提到以往的 RL 方法,所读段落没有分开给出对它们的数字。第二,这是跨任务的平均。成功率翻倍只在基线不高于 50% 时才可能:基线 70% 的任务,翻倍就是 140%,不存在。所以平均 2 倍说明不了任何一个具体任务提升多少(本课的算术)。第三,引言说的是“几乎所有任务”:
However, perhaps the most surprising finding is that our system can train RL policies to achieve near-perfect success rates and super-human cycle times on almost all of the tasks with only one hour to 2.5 hours of training time in the real world.
第四,1 到 2.5 小时是这套系统在这些任务上的真机训练时间。所读段落没有说明它是否包括采集示范、训练奖励分类器和搭建系统的时间。
这套系统由几块拼成,论文把每一块对应到一个难点:用预训练的视觉骨干处理优化不稳定;用基于 RLPD 的样本高效离策略算法,并纳入人类示范和纠正,处理样本复杂度;另加一个设计好的底层控制器,保证训练时的安全。RLPD 每个训练步从先验数据和在线数据里各取一半组成一个批次。奖励是稀疏的:
For all our tasks, we employ a sparse reward function. This function makes a binary decision on whether a task is successful or not using a trained classifier.
人的纠正也是数据:
During training, the system queries a human operator for potential corrections, which are then used to update the policy in an off-policy manner.
论文说,它和前作 SERL 的一个区别是同时用人类示范和纠正,SERL 只用示范;作者认为加入纠正对策略从错误中学习、提高表现至关重要,尤其是难以从零学起的任务。任务包括用鞭子从塔里抽出一块 Jenga、在锅里翻动物体、双臂之间交接物体,以及装配主板、IKEA 书架、汽车仪表盘和正时皮带,用一只或两只机械臂。视频提醒“这些多半还是单个技能、单台机器”。按本课的读法,每个数字都属于这些任务、这套硬件和这一流程,换一个任务,训练时间和提升都要重新量。
登录后继续阅读本课其余各节、自测题与答案。
局限 / 注意
- HIL-SERL 和 RECAP 都是 arXiv 预印本,属 R 级;系统结构、训练时间和倍数都是作者报告,本站没有复现,也没有运行任何一个模型。RECAP 是 Physical Intelligence 对自家模型的报告。
- HIL-SERL 本课只读了摘要、引言、相关工作和第 3 节开头的一部分;RECAP 只读了摘要;Isaac Lab 只读了文档首页。所读段落没有给出 RECAP 的绝对数值、哪些任务算“最难”、吞吐量的定义和比较对象,也没有说明 HIL-SERL 的训练时间是否包括准备工作。
- 实验记录是本课程自己的仿真实验,O 级,不是真机结果;复现脚本、原始日志和逐种子 JSON 没有公开。它的初始策略是练得不够的 PPO 策略,结论不能代表 VLA 的 RL 后训练。
- 以下是本课的整理、算术或推断:101% 等于 2.01 倍;基线高于 50% 的任务不可能翻倍;逐种子差值与复算的区间;回报区间相差 0.01 的原因;第四节的证据表和记录清单。
- 第二节的三次处理和工作站 B,以及练习里的工作站 K、团队 H、机械臂 C、计划 P1–P5、介入次数和迁移练习的种子差值,都是虚构的,不是任何论文或系统的数据。
- 纸面计算和仿真结果都不是硬件安全验证。
链接
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)
- 物理AI实验室 3.3 实验记录:Isaac Lab 仿真 3 个种子
- 物理AI实验室 3.2:世界模型,用 Cosmos 造数据,写清每种生成以什么为条件,把 78.3% 放回人类评审,再给生成数据定验收规则
- 物理AI实验室 1.6:模仿学习,手算误差怎样滚出示范覆盖范围,再把 ACT、扩散策略与数据规模律的数字放回各自条件
- 物理AI实验室 1.7:强化学习,手算一局回报看奖励怎样被钻空子,再读论文里的地形课程与超时重置
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 物理AI实验室 2.4:在 Isaac Lab 里并行练走路,读懂基准表的三列 FPS,再从训练命令算出总步数
- 物理AI实验室 2.5:sim2real 的域随机化与系统辨识,把两篇论文的数字放回原设定,再从一条推杯轨迹手算摩擦
- 物理AI实验室 2.8:可复现评测,手算 Wald 与 Wilson 区间,从 1/√n 定评测次数,再给零失败算出失败率上界
- 前沿雷达|在 SO-101 上微调 π0.5 搬国际象棋王:先降学习率再比检查点,仿真预训练在真实数据少时帮助最大,自身 rollout 再训练没有可测提升
- Luo 等:Precise and Dexterous Robotic Manipulation via Human-in-the-Loop Reinforcement Learning(HIL-SERL,arXiv 2410.21845)
- Physical Intelligence:π*0.6 与 RECAP(arXiv 2511.14759)
- NVIDIA Isaac Lab 文档