
プレプリント CucumberVision at the Edge(arXiv 2611.09490、2026-11-06、Kaur ら、ウィンザー大学と MBZUAI)は、RGB-D によるキュウリの長さ計測パイプラインを RTX 3050 Ti 搭載のノート PC から NVIDIA Jetson Orin Nano と Raspberry Pi 4 へ移し、長さの誤差、1 果あたりの時間、1 果あたりのエネルギーをまとめて報告しています。エッジへの配備に取り組む人が自分の作業と照らし合わせられる結果は三つあります。計測精度はセグメンテーションのバックエンドで決まり、プロンプト型のバックエンドを同じ FP32 で動かした場合、ノート PC と組み込みボードの間で 0.01 cm 以内しか違いません。グラフ全体を INT8 量子化すると、出力テンソルの配置が原因で検出器は対象を一つも出力しなくなります。Jetson の 7 W モードは 15 W モードより 1 果あたり 73% 多くエネルギーを使います。以下の数値はすべて著者の報告 [R] で、本サイトでは再現していません。
実験設定:3 台のマシンで同じ撮影データを再生
パイプラインは著者らの先行研究(arXiv 2606.22439)のものをそのまま使っています。Intel RealSense D435 が位置合わせ済みのカラー画像と深度を出し、YOLO26n のインスタンスセグメンテーションモデルが各キュウリを見つけ、セグメンテーションのバックエンドが検出ボックスをピクセル単位のマスクに細かくし、最後に中軸弧スプライン推定器(論文では M5)がマスク内の点群の断面重心を通る 3 次スプラインを当てはめて弧長を積分します。論文の模式図では、理想化した曲がった果実について、直線の主軸で測った弦の長さは弧長より 13% 短く、曲率が大きいほど差が広がります。ほかの推定器のうち M1 と M2 は検出ボックスだけを使い、著者はこれを検出器の対照として扱います。ある変更で M1 と M2 も動けばボックスが変わったことを、M1 と M2 が動かずに M3 と M5 が動けばセグメンテーション段で効いたことを示します。
- ノート PC:RTX 3050 Ti、PyTorch CUDA、FP32、能動冷却。精度の基準です。
- Jetson Orin Nano:JetPack 6.0、TensorRT 8.6.2、FP32 と FP16、能動冷却。
- Raspberry Pi 4 B:Cortex-A72 CPU、64 ビット RPi OS、ONNX Runtime、FP32 と INT8、受動冷却。
3 台とも温室で撮影した同じ 50 回分のデータを再生します。2 回のセッションで 7 本のキュウリを繰り返し撮影したもので、糸で測った正解の長さは 6.9–25.0 cm です。レイテンシはウォームアップ後の 220 回、精度は 50 回すべてで集計しています。YOLO26 は NMS が不要で、形状 (1, 300, 38) のテンソルを出力します。どちらのボードも汎用の推論ラッパーを使わず、このテンソルを直接解析しています(表で † を付けた構成を除く)。
統計の扱いにも注目する価値があります。同じキュウリを繰り返し撮影したデータは独立な標本ではないため、論文の区間はすべて果実単位で再標本化する cluster bootstrap(10,000 回)で求め、対応のある比較には 1 本の果実の撮影をすべてまとめて符号反転させる正確な sign-flip 置換検定を使っています。有意性の議論で示される標本数は「7 本」です。フィジカルAIラボ 2.8 では各試行が独立だと仮定して 1/√n から評価回数を見積もりました。この論文はその反例で、50 回の撮影は 50 個の独立な標本ではありません。
この手順で、ノート PC と FP32 の Jetson はどちらも SAM ViT-B を使ったとき M5 の MAE が 0.58 cm(95% CI 0.46–0.69)、Bland–Altman のバイアスは +0.06 cm、対応のある差はゼロでした。TensorRT FP16 にすると Jetson の検出レイテンシは 120 ms から 46 ms(2.57×)に下がり、M5 は 0.64 cm になります。対応のある差は +0.061 cm(95% CI +0.005〜+0.137、p = 0.11)で、著者は符号は一貫しているものの 7 本では有意ではないとしています。FP16 エンジンの構築時に 115 個の重みが FP16 の表現範囲を超えるという警告が出ましたが、著者が確かめたところ、出力は FP32 の経路とボックス座標で 1 px 以内、信頼度で 0.001 以内に収まっていました。
精度はセグメンテーションのバックエンドに、コストはプラットフォームに従う
1 枚の GPU 上でバックエンドだけを替えると、SAM ViT-B は 0.58 cm、蒸留版の MobileSAM は 0.76 cm(95% CI 0.56–1.00)、検出器自身の YOLO-seg マスク(以下、自前マスク)は 0.98 cm(95% CI 0.66–1.24)でした。プラットフォームを替えた場合、両側とも FP32 という条件で、プロンプト型の二つのバックエンド(SAM と MobileSAM)のノート PC と組み込みボードの差は最大 0.01 cm です。マスク自体もほぼピクセル単位で一致し、FP32 の Jetson での SAM のマスク IoU は 1.000、Raspberry Pi 上の MobileSAM とノート PC の平均 IoU は 1.000(最小 0.997)でした。
一方、コストはプラットフォームをまたいでまったく引き継がれません。MobileSAM はノート PC で 70 ms、Raspberry Pi で 15,041 ms かかり、214 倍の差があります。著者はここから、バックエンドの選択とプラットフォームの選択は切り分けられると主張します。ワークステーション上で候補のバックエンドを数分で評価し、得られた精度を現場のシステムが出す精度とみなし、そのうえでスループットとエネルギーからプラットフォームを選ぶ、という手順です。著者は三つの適用条件も明記しています。
- 成り立つのはプロンプト型のバックエンドだけです。自前マスクでは、M5 はノート PC、Raspberry Pi、Jetson でそれぞれ 0.98、0.82、0.84 cm、Raspberry Pi とノート PC の間のマスク IoU は平均 0.823、最小 0.447 で、2 つの組み込みボードでは自前マスクの構成に長さを長めに測る約 +0.57 cm の系統的なバイアスがあります。
- 比較したバックエンドは、同じプロンプトに対して出力が決定的です。
- マスクの品質が一定の水準を超えている必要があります。古典的な GrabCut は MobileSAM より 2.4 倍安価ですが、22% のフレームで使えるマスクを出せず、M5 は 1.92 cm まで悪化します。これはマスクをまったく使わない M2(0.83 cm)よりも悪い値です。
グラフ全体の INT8:Raspberry Pi で最速の検出器が、果実を一つも検出しない
Raspberry Pi での検出器の量子化アブレーションでは、学習に使っていない温室画像 40 フレームをキャリブレーションデータとしています。著者は検出器を ONNX に書き出して QDQ 形式の静的な学習後量子化を行い、per-tensor MinMax、per-tensor entropy、per-tensor percentile、per-channel MinMax の 4 手法を比べました。グラフ全体を量子化すると、モデルは 41.7 MB から 11.1 MB に、ピークメモリは 682 MB から 460 MB に縮み、検出レイテンシは 1,929 ms から 793 ms(2.43×)に下がります。この研究で Raspberry Pi 上で測った中で最速の検出器です。ところが、どの撮影でも検出結果がありませんでした。2 つのプラットフォーム、2 つの ONNX Runtime のバージョンで同じでした。
著者は原因を出力の配置に求めています。NMS-free の検出ヘッドは一つのテンソルだけを出力し、その中でボックス座標は 0–640、信頼度は 0–1 の範囲を取ります。per-tensor 量子化はテンソル全体に一つのスケールを与えるので、スケールは座標で決まってしまい、論文によれば量子化ステップは 7.71 になります。ピークの信頼度 0.85 は 1 ステップの 0.11 にしかならず、丸めるとゼロになるため、どの候補ボックスも検出しきい値を超えません。著者の議論は次のとおりです。0.85 をゼロにしないにはステップを 1.63 未満にする必要があり、640 を 255 段階の符号なし整数で表すにはステップが 2.51 以上必要です。二つの条件は両立しないので、どのキャリブレーション手法でもこの失敗は避けられず、重みの量子化の粒度を変えても解決しません。論文はこれを根拠に、この失敗はこのモデル、データセット、ツールチェーンではなく出力の配置に由来するとしています。前提は、座標の桁の値と確率の桁の値が同じテンソルに入り、テンソル単位で量子化されることです。
対処は検出ヘッドを量子化から外すことです(ヘッドは畳み込みの重みの 12.6% を占めます)。このときモデルは 15.1 MB、ピークメモリは 594 MB、検出レイテンシは 1,406 ms で 1.37× の高速化になります。M5 は 0.82 cm から 1.12 cm に変わり(+0.30 cm、95% CI −0.03〜+0.83、p = 0.27)、Bland–Altman の一致限界は −3.43〜+3.69 cm に広がります。
フィジカルAIラボ 2.6 では、量子化の効果を重みの容量、実行時メモリ、レイテンシの三つに分けて記録しました。この事例は、その三つより先に確かめるべき項目があることを示しています。出力がまだ有効かどうかです。グラフ全体の INT8 は容量、メモリ、レイテンシのどれでも最良なのに、検出数はゼロでした。速度の表だけで選ぶと誤ります。エッジとリアルタイム性の特集で取り上げた実測では、量子化はメモリを減らすだけで、かえって遅くなっていました。ここではヘッドを外すことで、Raspberry Pi の CPU 上の検出が実際に 1.37× 速くなり、その代わりに誤差が 0.30 cm 増えています(区間はゼロを含みます)。
1 果あたりのエネルギー:電力が低くてもエネルギーが少ないとは限らない
Jetson ではボード上の INA3221 モニター(tegrastats で読み取り)で VDD_IN レールの電力を得て、計測中の区間で積分し、計測した果実の数で割ります。電力モードごとにアイドル時の基準値を別に記録して差し引き、正味の値を求めます。Raspberry Pi にはボード上の電力センサーがないため、著者は外部で供給電力を測り、アイドル時の基準値は 2.52 W でした。1 回の実行で 44 果を計測します(論文の表 5)。
| 構成 | 平均電力(W) | 実行時間(s) | J/果 | J/果(正味) | M5 MAE(cm) |
|---|---|---|---|---|---|
| Jetson TensorRT FP16 + SAM、15 W | 10.14 | 183 | 42.18 | 20.18 | 0.64 |
| Jetson TensorRT FP16 + SAM、7 W | 7.21 | 446 | 73.12 | 23.45 | 0.64 |
| RPi 4 FP32 + MobileSAM | 5.41 | 859 | 105.55 | 56.38 | 0.76 |
| RPi 4 FP32、自前マスク | 5.68 | 117 | 15.05 | 8.38 | 0.82 |
| RPi 4 INT8(ヘッドは FP32)、自前マスク | 5.61 | 89 | 11.29 | 6.22 | 1.12 |
7 W モードは電力が 29% 低い一方で時間は 2.44 倍かかり、1 果あたり 73.12 J と、15 W モードの 42.18 J より 73% 多くなります。精度は両モードでビット単位まで同じで(M5 はどちらも 0.64 cm、対応のある差はちょうどゼロ)、著者はこれを対照として扱っています。電力の上限は実行速度を変えるだけで、演算結果は変えません。遅くなる分の多くはセグメンテーション段で生じ、こちらは 2.75 倍、検出は 1.49 倍の遅れでした。表の正味の値から本サイトが計算すると、差は約 16%(23.45 J と 20.18 J)です。つまり 73% という総量での差の大部分は、実行時間が延びた間に積み重なったアイドル電力によるものです。総量はバッテリーが実際に払うエネルギーで、著者は 15 W モードの総量 42.2 J/果をもとに 100 Wh のバッテリーで約 8,500 回の計測ができると見積もっています。
プラットフォーム間でも同じ計算が成り立ちます。MobileSAM を動かす Raspberry Pi の電力は 5.41 W で、SAM を動かす Jetson の 10.14 W より 47% 低いものの、1 果あたり 105.55 J を使い、Jetson の総量の 2.50 倍、正味の 2.79 倍になります。しかもこの二つは精度が最も近い構成です(0.76 cm と 0.64 cm)。Raspberry Pi では構成が変わっても負荷時の電力はほぼ一定(5.41〜5.68 W、差は 5%)なので、レイテンシを縮める最適化はそのまま同じ割合でエネルギーを減らします。ヘッドを外した INT8 では 1 果あたりのエネルギーが 15.05 J から 11.29 J へと 25% 減りました。Jetson はそうなりません。電力モードが電力と時間の両方を変えるからです。本サイトの EdgeVLN の記事でも、実行経路を電力ではなく 1 ステップあたりのエネルギーで比べています。
熱については、受動冷却の Raspberry Pi で量子化したパイプラインを 30 min 連続して動かしたところ(実験室の室温 21 °C)、約 90 s で熱平衡に達し、ピークは 53.0 °C で、80 °C のスロットリングしきい値より 27.0 °C 低い値でした。357 回のサンプルすべてで ARM クロックは 1800 MHz を保ち、スロットリングのフラグは立たず、実行ごとの検出レイテンシの変動は 1.1% でした。
非支配の 3 構成と選び方の規則
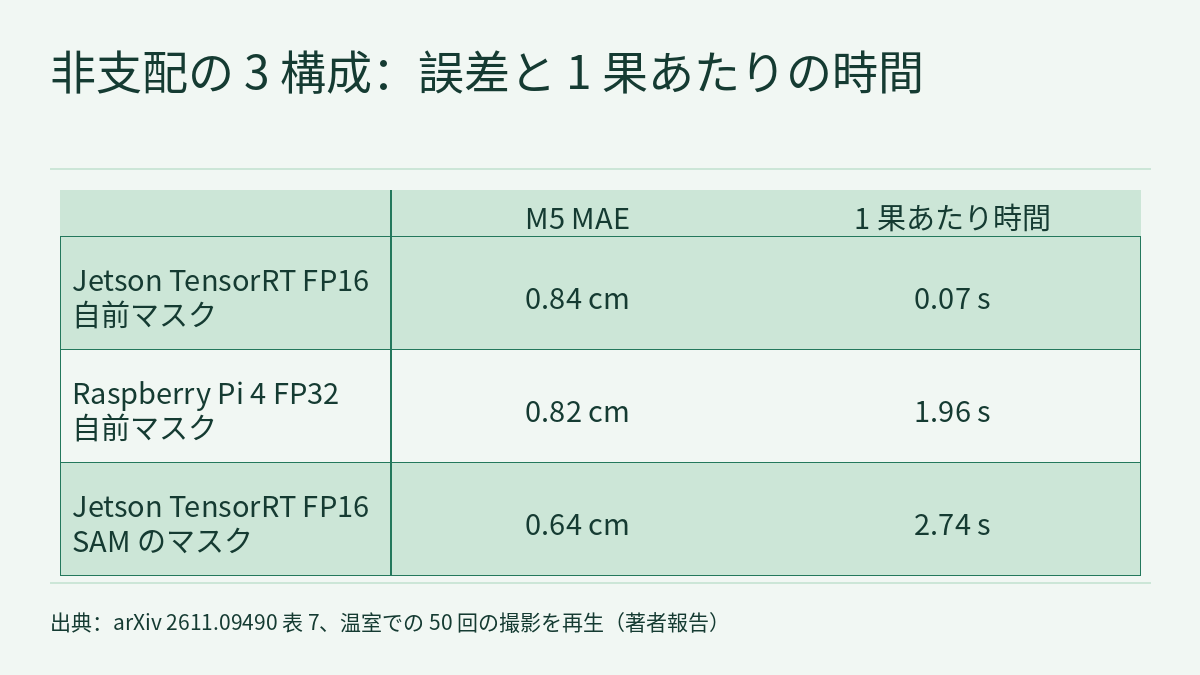
論文の表 7 は各構成を精度、スループット、エネルギーの 3 軸に置き、精度とスループットの 2 項目で支配関係を判定して、組み込み配備構成の中で(ノート PC の参照行は比較対象外)非支配の構成を三つ挙げています。
- Jetson TensorRT FP16、自前マスク:M5 0.84 cm、1 果あたり 0.07 s(72 ms)、約 0.7 J/果(推算値)。
- Raspberry Pi 4 FP32、自前マスク:0.82 cm、1.96 s、15.1 J/果。低コストの選択肢です。
- Jetson TensorRT FP16、SAM:0.64 cm、2.74 s、42.2 J/果。
同じ Jetson 上の二つの動作点の間では、38 倍のレイテンシの差で 0.20 cm の精度が得られます。著者はアブレーションから、組み合わせて使える三つの規則を導いています。精度の目標に合わせてセグメンテーションのバックエンドを選ぶ(プロンプト型の精度は引き継がれるので、評価は手近なハードウェアでよい)。スループットとエネルギーの目標に合わせてプラットフォームを選ぶ(プラットフォームはバックエンドが出す精度を変えない)。検出器がボトルネックのときだけ量子化し(このパイプラインでは自前マスクの構成)、その際は検出ヘッドを外す。
表を読むときに気をつけたい点が二つあります。以下は本サイトの解釈です。Raspberry Pi の自前マスク構成が「非支配」になるのは 0.82 cm と 0.84 cm という 0.02 cm の差によるもので、両者の 95% CI(0.66–0.98 と 0.69–0.98)はほぼ重なっています。著者も、支配関係は精度とスループットだけで判定しておりハードウェアのコストは含まないので、支配される構成でもコストの面では適切な選択になりうると書いています。また、Jetson の自前マスク構成の約 0.7 J は 1 果あたりのレイテンシと平均電力から推算した値で、実測ではありません。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者の報告 [R] です。本サイトでは再現していません。論文によれば、コード、量子化の設定、エネルギーと熱の計測スクリプト、結果ファイルは責任著者への依頼で入手でき、公開リポジトリはありません。
- 標本が小さく、7 本のキュウリを撮った 50 回分の保存データの再生で、いずれも 1 果だけが写った画像です。論文は RGB-D カメラをロボットの先端に取り付けた実験室でのリアルタイム計測にも触れていますが、本サイトが読んだ結果の表はすべて再生によるものです。
- 各ボードは 1 台ずつしか試しておらず、個体差は調べられていません。熱の試験は室温 21 °C の実験室で 1 回行っただけで、温室の環境に当てはめるのは単一条件からの推論であることを著者も明記しています。
- 独立に注釈した正解ボックスがないため、論文は mAP を報告していません。表 7 のエネルギーのうち 2 項目はレイテンシと平均電力からの推算値です。
- 本サイトが確認した際、表 5 の実行時間を 44 果で割った値が表 2 の 1 果あたりのレイテンシより長いことに気づきました(たとえば Jetson の SAM 構成では 183 s / 44 ≈ 4.2 s、表 2 では 2.74 s)。本サイトが読んだ本文にはこの差の説明がないため、J/果を表 2 のレイテンシから逆算するのは避けるべきです。
- INT8 の失敗についての議論は、座標と信頼度が一つのテンソルに入りテンソル単位で量子化されるという前提に対するものです。ほかの出力配置や量子化方式は、この論文の結論の範囲外です。
- 結果はすべて計測精度と計算性能の指標で、ロボットの動作についての安全検証ではありません。
リンク
- CucumberVision at the Edge: Accuracy, Throughput, and Energy of RGB-D Cucumber Sizing on Jetson Orin Nano and Raspberry Pi 4(arXiv 2611.09490)
- 論文の HTML 全文
- フィジカルAIラボ 2.6:エッジへ――遅延のログから制御周波数の上限を求め、量子化で減るのが容量か時間かを見分け、動作チャンクの長さを決める
- フィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求める
- フロンティア・レーダー特集|エッジとリアルタイム性:VLA と世界行動モデルのレイテンシ予算はどこに使われているか
- フロンティア・レーダー|EdgeVLN:同じ 4 bit でも、1 ステップのエネルギーは実行経路によって 36.8 倍の差


