
预印本 CucumberVision at the Edge(arXiv 2611.09490,2026-11-06,Kaur 等,温莎大学与 MBZUAI)把一套 RGB-D 黄瓜测长流水线从带 RTX 3050 Ti 的笔记本搬到 NVIDIA Jetson Orin Nano 和 Raspberry Pi 4 上,并同时报告测长误差、单果耗时和单果能量。对做边缘部署的人,这篇论文给了三个可以直接拿来对照的结果:测长精度由分割后端决定,提示式分割后端、同为 FP32 时,笔记本与嵌入式板子之间相差不超过 0.01 cm;整图 INT8 量化后检测器一个目标也输出不了,原因出在输出张量的布局上;Jetson 的 7 W 模式测一个果比 15 W 模式多耗 73% 的能量。以下数字均为作者报告 [R],本站未复现。
实验设置:三台机器回放同一批采集
流水线沿用作者此前的工作(arXiv 2606.22439)。Intel RealSense D435 提供对齐的彩色与深度图,YOLO26n 实例分割模型定位每根黄瓜,分割后端把检测框细化成像素级掩码,最后由中轴弧样条估计器(论文记为 M5)在掩码点云上沿截面质心拟合三次样条并积分弧长。论文的示意图里,对一根理想化的弯曲果实,直线主轴量出的弦长比弧长短 13%,曲率越大差得越多。另外两种估计器 M1、M2 只用检测框,作者把它们当作检测器的对照:某项改动让 M1、M2 也变了,说明它改的是检测框;M1、M2 不变而 M3、M5 变了,说明它作用在分割阶段。
- 笔记本:RTX 3050 Ti,PyTorch CUDA,FP32,主动散热,作为精度基线。
- Jetson Orin Nano:JetPack 6.0、TensorRT 8.6.2,FP32 与 FP16,主动散热。
- Raspberry Pi 4 B:Cortex-A72 CPU,64 位 RPi OS,ONNX Runtime,FP32 与 INT8,被动散热。
三台机器回放同样的 50 次温室采集,来自两个时段、7 根黄瓜的重复视角,用线测量的真值长度在 6.9–25.0 cm 之间。时延按 220 次预热后的采集统计,精度按全部 50 次统计。YOLO26 不需要 NMS,输出形状为 (1, 300, 38) 的张量;两块板子都绕开通用推理封装,直接解析这个张量(表中注 † 的配置除外)。
统计方法值得注意。同一根黄瓜的多次采集不是独立样本,所以论文的区间都用按果实重采样的 cluster bootstrap(10,000 次),配对比较用整根果的所有采集一起翻号的精确 sign-flip 置换检验,显著性讨论里写的样本量是“7 根果”。物理AI实验室 2.8 用 1/√n 估算评测次数时假设每次独立;这篇论文是一个反例:50 次采集并不等于 50 个独立样本。
在这套协议下,笔记本和 Jetson FP32 用 SAM ViT-B 时 M5 的 MAE 都是 0.58 cm(95% CI 0.46–0.69),Bland–Altman 偏差 +0.06 cm,配对差为零。TensorRT FP16 把 Jetson 的检测时延从 120 ms 降到 46 ms(2.57×),M5 变为 0.64 cm;配对差 +0.061 cm(95% CI +0.005 到 +0.137,p = 0.11),作者称方向一致,但在 7 根果上不显著。构建 FP16 引擎时有 115 个权重超出 FP16 可表示范围的警告,作者核对后发现输出与 FP32 路径的框坐标相差不到 1 px,置信度相差不到 0.001。
精度跟着分割后端走,代价跟着平台走
在同一块 GPU 上只换分割后端:SAM ViT-B 为 0.58 cm,蒸馏版 MobileSAM 为 0.76 cm(95% CI 0.56–1.00),检测器自带的 YOLO-seg 掩码为 0.98 cm(95% CI 0.66–1.24)。换平台时,两种提示式后端(SAM 与 MobileSAM)在同为 FP32 的条件下,笔记本与嵌入式板子之间的最大差是 0.01 cm。掩码本身几乎逐像素一致:Jetson FP32 上 SAM 的掩码 IoU 为 1.000,树莓派上 MobileSAM 与笔记本的平均 IoU 为 1.000(最小 0.997)。
代价则完全不能跨平台迁移。MobileSAM 在笔记本上 70 ms,在树莓派上 15,041 ms,相差 214 倍。作者据此提出,后端选择和平台选择可以分开做:在工作站上用几分钟评估候选后端,把得到的精度当作现场系统会给出的精度,再按吞吐和能量选平台。作者同时写明了三个边界条件:
- 只对提示式后端成立。检测器自带掩码的 M5 在笔记本、树莓派、Jetson 上分别是 0.98、0.82、0.84 cm,树莓派与笔记本之间的掩码 IoU 平均 0.823、最小 0.447;两块嵌入式板子上用自带掩码的配置有约 +0.57 cm 的系统性偏差,倾向于高估长度。
- 比较的后端在同一提示下输出确定。
- 掩码质量要过一个门槛。经典方法 GrabCut 比 MobileSAM 便宜 2.4 倍,但在 22% 的帧上给不出可用掩码,M5 退到 1.92 cm,比根本不用掩码的 M2(0.83 cm)还差。
整图 INT8:树莓派上最快的检测器,一个果也检不出
在树莓派的检测器量化消融中,校准数据为 40 帧留出的温室画面。作者把检测器导出为 ONNX 后按 QDQ 格式做静态训练后量化,比较了 per-tensor MinMax、per-tensor entropy、per-tensor percentile 和 per-channel MinMax 四种策略。整图量化后,模型从 41.7 MB 缩到 11.1 MB,峰值内存从 682 MB 降到 460 MB,检测时延从 1,929 ms 降到 793 ms(2.43×),是本研究在树莓派上测到的最快检测器。但它在每一次采集上都没有检测结果,两个平台、两个 ONNX Runtime 版本都一样。
作者给出的原因在输出布局。NMS-free 检测头只输出一个张量,其中框坐标的范围是 0–640,置信度的范围是 0–1。per-tensor 量化给整个张量一个缩放系数,这个系数只能由坐标决定,论文给出的量化步长是 7.71。峰值置信度 0.85 只有一个步长的 0.11,四舍五入后为零,于是没有任何候选框过检测阈值。作者的论证是:要让 0.85 不归零,步长必须小于 1.63;要用 255 个无符号等级表示 640,步长至少是 2.51。两个要求互相排斥,所以任何校准策略都避不开,改权重的量化粒度也没用。论文据此把这一失效归于输出布局,而非这个模型、数据集或工具链;适用前提是坐标量级与概率量级的值放在同一个张量里、并且按张量量化。
修法是把检测头排除在量化之外(它占卷积权重的 12.6%)。此时模型 15.1 MB,峰值内存 594 MB,检测时延 1,406 ms,提速 1.37×;M5 从 0.82 cm 变为 1.12 cm(+0.30 cm,95% CI −0.03 到 +0.83,p = 0.27),Bland–Altman 一致性界限放宽到 −3.43 到 +3.69 cm。
物理AI实验室 2.6 讲过,量化要把权重体积、运行时内存和时延分开记账。这个案例说明三笔账之前还要先查一项:输出是否仍然有效。整图 INT8 在体积、内存、时延三项上都是最好的,检测数却是零;只看速度表的话会选错。边缘与实时性专题里收录的实测是量化只省内存、反而更慢;这里排除检测头后,树莓派 CPU 上的检测确实快了 1.37×,代价是 0.30 cm 的误差增量(区间包含零)。
每个果的能量:功率低不等于省能量
Jetson 用板载 INA3221 监测器(通过 tegrastats 读取)积分 VDD_IN 在工作窗口内的功率,再除以测量的果数;每种功率模式单独记录空闲基线并扣除,得到净值。树莓派没有板载功率传感器,作者在外部测量供电功率,空闲基线为 2.52 W。每轮测 44 个果,结果如下(论文表 5):
| 配置 | 平均功率(W) | 运行时间(s) | J/果 | J/果(净) | M5 MAE(cm) |
|---|---|---|---|---|---|
| Jetson TensorRT FP16 + SAM,15 W | 10.14 | 183 | 42.18 | 20.18 | 0.64 |
| Jetson TensorRT FP16 + SAM,7 W | 7.21 | 446 | 73.12 | 23.45 | 0.64 |
| RPi 4 FP32 + MobileSAM | 5.41 | 859 | 105.55 | 56.38 | 0.76 |
| RPi 4 FP32,自带掩码 | 5.68 | 117 | 15.05 | 8.38 | 0.82 |
| RPi 4 INT8(检测头 FP32),自带掩码 | 5.61 | 89 | 11.29 | 6.22 | 1.12 |
7 W 模式的功率低 29%,耗时却是 2.44 倍,每果 73.12 J,比 15 W 模式的 42.18 J 多 73%。两种模式的精度逐位相同(M5 都是 0.64 cm,配对差正好为零),作者把这当作对照:功率上限改变执行速度,不改变算术。变慢主要发生在分割阶段,它慢了 2.75 倍,检测只慢了 1.49 倍。按表中净值,本站计算的差距约为 16%(23.45 对 20.18 J),所以 73% 的毛差距大部分来自运行时间变长期间累积的空闲功耗。毛值是电池实际付出的能量;作者按 15 W 模式的毛值 42.2 J/果估算,100 Wh 电池约可支持 8,500 次测量。
平台之间也是同样的账。树莓派跑 MobileSAM 的功率是 5.41 W,比 Jetson 跑 SAM 的 10.14 W 低 47%,但每果 105.55 J,毛值是 Jetson 的 2.50 倍、净值是 2.79 倍,而这两组的精度最接近(0.76 对 0.64 cm)。树莓派各配置的负载功率几乎不变(5.41 到 5.68 W,相差 5%),所以在它上面任何缩短时延的优化都按同样比例省能量:排除检测头的 INT8 把每果能量从 15.05 J 降到 11.29 J,少 25%。Jetson 不是这样,因为它的功率模式同时改变功率和时长。本站 EdgeVLN 一文 也是按每步能耗而不是功率比较不同执行路径的。
散热方面,被动散热的树莓派连续运行量化后的流水线 30 min(实验室环境 21 °C),约 90 s 达到热平衡,峰值 53.0 °C,比 80 °C 的降频阈值低 27.0 °C;357 个采样点上 ARM 时钟一直保持 1800 MHz,没有出现降频标志,各轮检测时延的波动为 1.1%。
三个非支配配置与选型规则
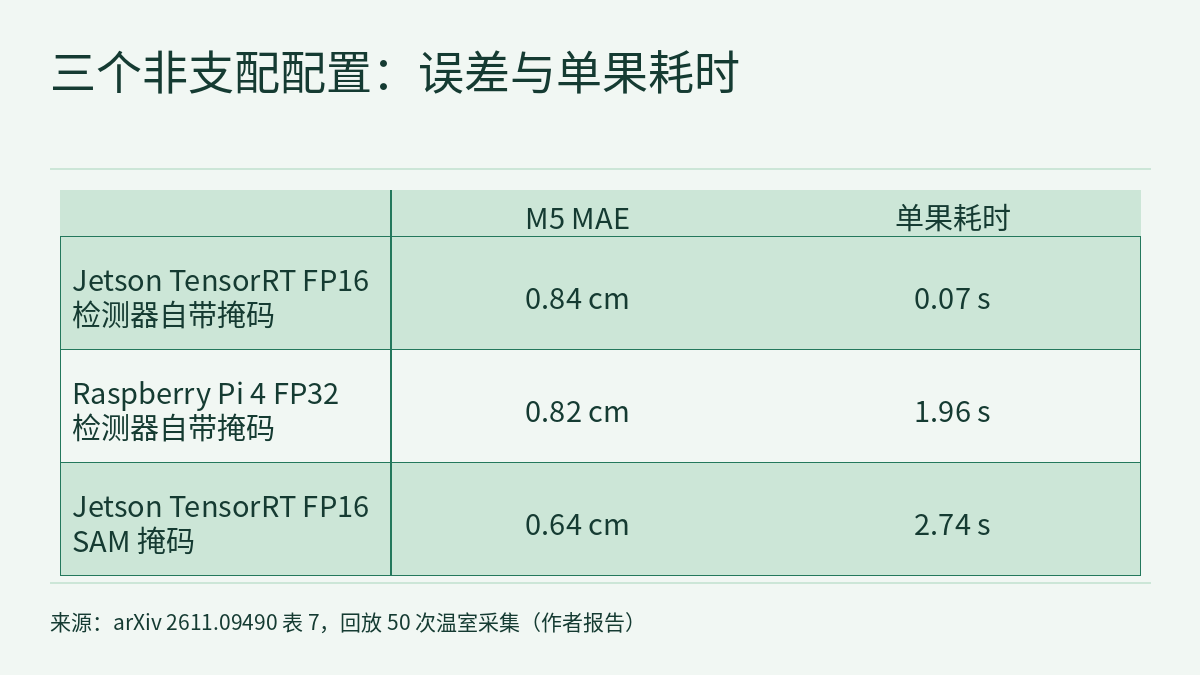
论文表 7 把每个配置放进“精度、吞吐、能量”三维空间,按精度和吞吐两项判断支配关系,在嵌入式部署配置中(笔记本参考行不参与比较)标出三个非支配配置:
- Jetson TensorRT FP16,自带掩码:M5 0.84 cm,单果 0.07 s(72 ms),约 0.7 J/果(推算值)。
- Raspberry Pi 4 FP32,自带掩码:0.82 cm,1.96 s,15.1 J/果,作为低成本选项。
- Jetson TensorRT FP16,SAM:0.64 cm,2.74 s,42.2 J/果。
同一块 Jetson 上的两个工作点之间,38 倍的时延差换来 0.20 cm 的精度。作者由消融总结出三条可以叠加使用的规则:按精度目标选分割后端,在方便的硬件上评估即可,提示式后端的精度会迁移;按吞吐和能量目标选平台,平台不改变后端给出的精度;只在检测器是瓶颈时量化(在这条流水线上是自带掩码的配置),并且把检测头排除在外。
读这张表时有两点要留意,以下是本站的解读。树莓派自带掩码配置之所以“非支配”,靠的是 0.82 对 0.84 cm 这 0.02 cm 的差距,而两者的 95% CI(0.66–0.98 与 0.69–0.98)几乎重合。作者也写明,支配关系只算精度和吞吐,不含硬件成本,被支配的配置在成本上仍可能是合适的选择。另外,表中 Jetson 自带掩码配置的约 0.7 J 是由单果时延和平均功率推算的,不是实测。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。代码、量化配置、能量与热测试脚本和结果文件按论文的说法需向通讯作者索取,没有公开仓库。
- 样本小:7 根黄瓜、50 次存储采集的回放,均为单果画面。论文另提到在实验室里把 RGB-D 相机装在机器人末端做了实时测长,但本站读到的结果表都来自回放。
- 每种板子只测了一台,单机差异没有表征;热测试只在 21 °C 实验室环境下做过一次,推到温室环境是单一条件下的推断,作者也这样写明。
- 论文没有报告 mAP,因为没有独立标注的真值框;表 7 中有两项能量值由时延和平均功率推算。
- 本站核对时注意到,表 5 的运行时间除以 44 个果后长于表 2 的单果时延(例如 Jetson SAM 配置 183 s / 44 ≈ 4.2 s,表 2 为 2.74 s),本站读到的正文没有解释这一差异,所以 J/果 不宜直接用表 2 的时延反推。
- INT8 失效的论证针对的是“坐标与置信度在同一张量里、按张量量化”这一前提;其他输出布局或量化方式不在这篇论文的结论范围内。
- 所有结果都是测量精度和计算性能指标,不涉及机器人运动的安全验证。
链接
- CucumberVision at the Edge: Accuracy, Throughput, and Energy of RGB-D Cucumber Sizing on Jetson Orin Nano and Raspberry Pi 4(arXiv 2611.09490)
- 论文 HTML 全文
- 物理AI实验室 2.6:上边缘,从时延日志算出控制频率上限,分清量化省下的是体积还是时间,再给动作块定长度
- 物理AI实验室 2.8:可复现评测,手算 Wald 与 Wilson 区间,从 1/√n 定评测次数,再给零失败算出失败率上界
- 前沿雷达专题|边缘与实时性:VLA 与世界动作模型的延迟预算花在哪里
- 前沿雷达|EdgeVLN:同为 4 bit,每步能耗因执行路径相差 36.8 倍


