
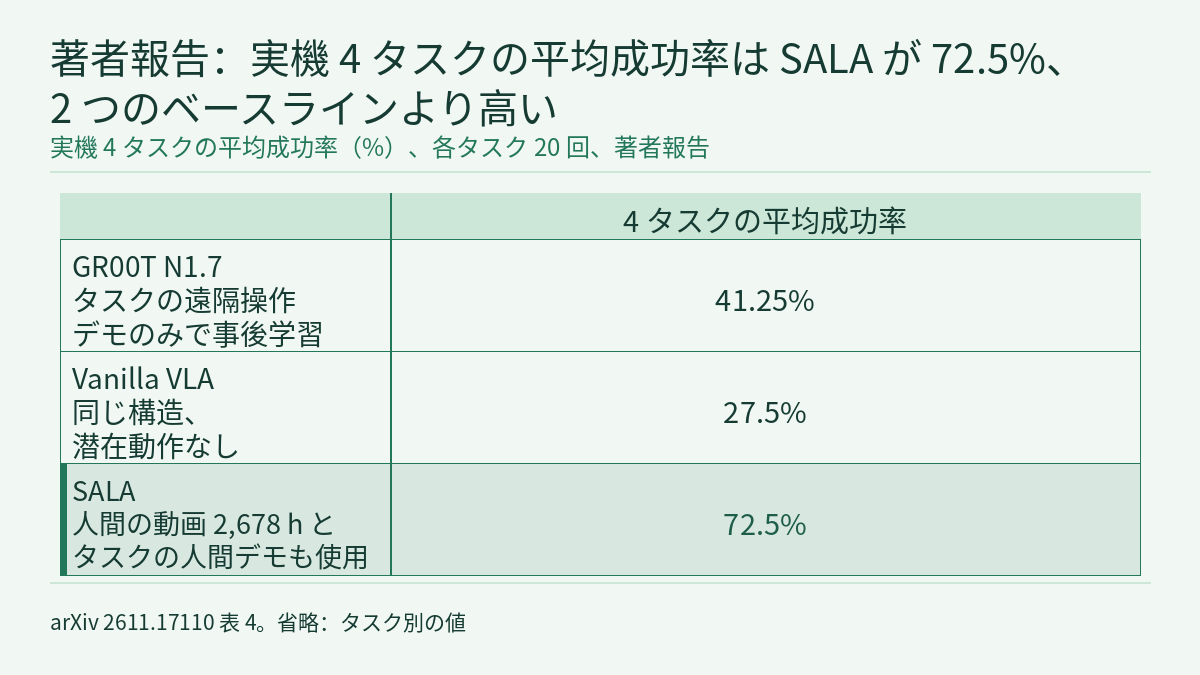
一人称視点の人間の動画でロボットの方策を学習する方法の一つに、潜在動作モデル(LAM)があります。2 枚のフレームから「潜在動作」を推定し、方策にそれを予測させます。arXiv 2611.17110(2026-11-12)の著者は、動画の再構成だけで学んだ潜在動作はシーンの見た目でまとまりやすく、人の手とロボットの手が同じ「コップをつかむ」を行っても近くに配置されるとは限らないと指摘しています。提案手法 SALA は、原子動作の言語記述を使ってペアになっていない人間のクリップとロボットのクリップの意味的な類似度を見積もり、それで潜在空間を教師付けします。著者報告では、63 次元の動作空間をもつ実機で 4 タスクの平均成功率が 72.5%、同じ構造で潜在動作を除いたベースラインは 27.5% でした(SALA は人間の動画による事前学習とタスクの人間デモも使用)。以下の数字はすべて著者報告 [R] です。本サイトはコードを実行しておらず、独立した再現もしていません。
再構成だけで学んだ潜在動作はシーンごとにまとまる
LAM は逆動力学と順動力学を組み合わせます。エンコーダが k ステップ離れた観測 o_t と o_(t+k) から潜在動作 z を推定し、情報ボトルネックで圧縮したあと、デコーダが o_t と圧縮コードから o_(t+k) を再構成します。この目的関数は、各潜在変数が自分のクリップ内の変化を説明することしか求めません。人とロボットが同じことをしたときに近い潜在動作になることは求めていません。著者は、こうした潜在変数は動作そのものよりシーンを多く符号化すると述べています。
世界行動モデル(WAM)と違い、LAM は方策学習中にピクセルを予測しません。著者はこれを LAM の学習効率が高い理由として挙げ、推論コストも低くなりうるとしていますが、本文には学習時間や推論時間の測定値はありません。
言語記述でペアのないクリップに「ソフトな近傍」を与える
SALA のトークナイザーは、人間のデータセットと別に収集したロボットのデータセットで一緒に学習します。両者は視覚エンコーダ、量子化器、視覚デコーダを共有し、損失は次の 3 つからなります。
- 視覚の再構成:人間とロボットのクリップがどちらも参加し、目標は凍結した DINOv2 による未来の観測の特徴です。
- 動作の再構成:動作ラベルがあるのはロボットのクリップだけです。ロボット専用の動作デコーダが潜在コードと初期状態から動作チャンクを再構成し、ロボットの潜在動作を直接制御に結び付けます。
- 意味の整合:各クリップには原子動作の記述(例:“grasp the cup”)が付いています。凍結したテキストエンコーダで人間のクリップと同じバッチ内の各ロボットクリップとの言語類似度を求め、softmax でソフトな近傍 P にします。潜在動作のコサイン類似度からは Q を作り、交差エントロピーで Q を P に近づけます。
整合には設計上の工夫が 2 つあります。1 つ目は、ロボットの潜在動作に stop-gradient をかけ、人間の潜在動作だけを動かすことです。動作で教師付けされているのはロボット側だけだからです。2 つ目は、量子化器にハード VQ ではなく SoftVQ を使うことです。各トークンはコードブック上の分布で、z に応じてなめらかに変わるため、「コップをつかむのは、コップを置くよりボトルをつかむほうに近い」といった段階的な関係を表せます。著者報告では、ハード VQ では整合損失が一様予測の値付近にとどまり、視覚の再構成損失はどちらも同程度でした。
実装では、各クリップを 8 個の潜在トークンに符号化し、コードブックは 256 コードです。テキストエンコーダはシミュレーションでは CLIP ViT-B/32、実機実験では Qwen3-Embedding-4B です。本サイトで以前紹介した EgoJEPA は手の動作の差分を条件に潜在動作を学びます。SALA は身体をまたぐ対応関係を言語記述に任せ、人とロボットのペアデータを必要としません。
凍結したトークナイザーで動画にラベルを付ける
学習後のトークナイザーは凍結され、「教師」として人間とロボットのクリップに潜在動作の分布 y を付けます。未来のフレームはラベル付けにだけ使い、方策は現在の観測しか見ないため、デプロイ時に教師は不要です。方策は π0 型の構成で、VLM に Qwen3-VL-4B、別に 0.6B パラメータの動作エキスパートを置き、フローマッチングで動作チャンクを生成します。著者は動作エキスパートに学習可能な潜在動作クエリを加え、教師の分布に KL ダイバージェンスで合わせ、ノイズを加えた動作トークンがそのクエリを参照するようにしました。人間の動画には状態も動作もないので潜在動作の経路だけを通りますが、学習されるのは同じ VLM と同じ動作エキスパートです。この種の VLA の構造は フィジカルAIラボ 3.1 で確認できます。
学習は 3 段階です。事前学習では人間の動画と潜在動作の損失だけを使います。ラベル付けに必要なのは動画フレームだけで、動作ラベルも言語記述も要りません。中間学習では対象ロボットの遠隔操作データでフローマッチング損失と潜在動作損失を併用します。任意の事後学習では、あるタスクの遠隔操作デモと人間のデモを一緒に学習します。言語記述はトークナイザーの学習にしか使わないため、実機実験で注釈を付けたのは人間の動画のうち 983 時間分のサブセットとロボットデータだけです。
シミュレーション:RoboTwin 2.0 での比較
シミュレーション実験には人間の動画がなく、代わりに別のアーム ARX-X5 の動画(27,000 軌跡、68.0 時間)を使います。対象ロボット Aloha-AgileX のデータはクリーンなシーンの 2,500 軌跡(9.2 時間)だけです。評価は双腕 50 タスクで各 100 回、クリーンなシーン(Clean)とドメインランダム化したシーン(Random)に分かれます。WAM と LAM のベースラインも同じ動画で追加学習しており、π0.5 と X-VLA は対象ロボットのデータだけを使います。主な結果(成功率 %)は次のとおりです。
| 手法 | 種類 | ロボットデータで事前学習したチェックポイント | Clean | Random | 平均 |
|---|---|---|---|---|---|
| π0.5 | VLA | あり | 70.7 | 46.6 | 58.7 |
| LingBot-VA | WAM | あり | 75.8 | 38.4 | 57.1 |
| FastWAM | WAM | なし | 79.4 | 3.2 | 41.3 |
| OpenWAM | WAM | なし | 86.8 | 3.9 | 45.4 |
| RotVLA | LAM | あり | 74.4 | 28.0 | 51.2 |
| SALA | LAM | なし | 80.2 | 48.6 | 64.4 |
SALA は Random と平均で最も高く、Clean では OpenWAM を下回ります。FastWAM と OpenWAM は Clean で SALA と同等以上ですが、Random では 3.2 と 3.9 に下がります。著者の説明では、動画予測はシーンの見た目もモデル化する必要があり、ドメインランダム化が変えるのはまさにその見た目です。アブレーションでは、整合損失を除くと 75.5 / 36.8、stop-gradient を除く(双方向の整合)と 73.5 / 46.8 でした。著者はまた、整合を加えると ARX-X5 の潜在動作の分散のうち動作で説明される割合の中央値が 0.41 から 0.67 に上がり、シーンで説明される割合が 0.14 から 0.04 に下がったと報告しています。これらの成功率について、論文は区間や複数シードの結果を示していません。本サイトで以前紹介した SWAM も RoboTwin での数字を報告していますが、学習データと設定が異なるため、上の表とそのまま比べるべきではありません。
実機:人間の動画による 2 つのスケーリング軸
実機は Sharpa North という車輪型ヒューマノイドで、22 自由度の Sharpa Wave 器用ハンドを 2 つ備え、関節空間の動作は腕、手、胴体、首を含めて 63 次元です。データは一人称視点の人間の動画 2,678 等価時間(71,582 軌跡)と、ロボットの遠隔操作データ 888 時間です。4 つの下流タスクにはそれぞれ遠隔操作デモと人間のデモがあり、たとえばギア組み立ては遠隔操作 1,466 本(9.0 時間)と人間のデモ 2,715 本(12.0 時間)です。各手法を各タスク 20 回試行した成功率(%)は次のとおりです。
| 手法 | ギア組み立て | 両手での注ぎ | 花の差し込み | スプーンですくう | 平均 |
|---|---|---|---|---|---|
| GR00T N1.7 | 45 | 50 | 30 | 40 | 41.25 |
| Vanilla VLA | 40 | 25 | 20 | 25 | 27.5 |
| SALA | 75 | 80 | 55 | 80 | 72.5 |
3 手法とも同じタスクの遠隔操作デモで事後学習しています。Vanilla VLA は SALA と同じ構造から潜在動作を除いたもので、遠隔操作データからしか学べません。SALA はこれに加えて人間の動画による事前学習とタスクの人間のデモを使います。そのため著者は、両者の差は潜在動作と、それによって使えるようになる人間の動画を合わせた寄与を測るものだとしています。この比較では両者を切り分けていません。
2 つのスケーリング軸は次のとおりです。
- 事前学習の軸:人間の動画の予算を 0、473、1,103、2,678 等価時間とし、中間学習と事後学習のデータは変えません。著者報告では、保留した遠隔操作デモでの検証 L1 誤差(各タスクで使う関節のみ)は予算を増やすたびに下がり、0 時間の版でも Vanilla VLA より低くなりました。これはオフラインの誤差で成功率ではなく、各設定 1 回の実行です。
- 事後学習の軸:2,678 時間で事前学習したモデルから始め、遠隔操作デモを固定し、各タスクの人間のデモを 10%、50%、100% 使うと、平均成功率は 53.75% から 72.5% に上がりました。
論文は実機の成功率に区間を示していません。フィジカルAIラボ 2.8 の Wilson 95% 区間で粗く計算すると(本サイトの計算。各手法の 4 タスク計 80 回を独立な試行とみなし、タスク間の違いは無視)、72.5% は 58/80 で約 61.9%–81.1%、27.5% は 22/80 で約 18.9%–38.1%、41.25% は 33/80 で約 31.1%–52.2% です。SALA の区間は 2 つのベースラインのどちらとも重なりません。事後学習の軸の 53.75% も 80 回だとすると(この組の試行回数は論文に個別には書かれていません)、43/80 で約 42.9%–64.3% となり、72.5% の区間と重なります。このサンプル数では、この傾向はまだ確かとはいえません。
制約と注意点
- これは arXiv のプレプリントで、数字はすべて著者報告 [R] です。独立した再現はありません。論文は成功率の区間や複数シードの結果を示しておらず、上の Wilson 区間は本サイトが回数から粗く計算したものです。
- 著者の所属には Sharpa Robotics、上海交通大学の SJTU-Sharpa Joint Lab for Embodied AI、清華大学が含まれます。実機の Sharpa North と Sharpa Wave ハンドは、最初に挙げられた所属と同じブランド名です。
- シミュレーション実験の「人間の動画」は別のロボットアームの動画で、人の動画ではありません。
- 著者が挙げる制約:トークナイザーの学習には原子動作の記述が必要です(方策自体は動画フレームだけで学びます)。スケーリング分析はオフラインの検証誤差を測ったもので、各設定 1 回の実行、事前学習の予算は最大 2,678 時間です。より大きな規模で傾向が続くか、実機の成功率にどう結び付くかは未解決です。
- 実機の比較では、SALA はベースラインが使っていない人間の動画とタスクの人間のデモを使っています。比べているのは手法全体で、同じデータ量での構造の違いではありません。
- 論文にはプロジェクトサイトの記載がありますが、本サイトは開いておらず、コードやモデルが公開されているかも確認していません。
リンク
- SALA: Semantically Aligned Latent Actions Enable Dual-Axis Scaling of Embodied Foundation Models(arXiv 2611.17110)
- 論文の HTML 全文
- フィジカルAIラボ 1.5:データはどこから来る?――SO-101 のメタデータからお手本の長さを求め、三つの入手ルートの単位と動作空間を見分ける
- フィジカルAIラボ 3.1:VLA を分解する――コップを置く動作を 256 区間のトークンに直し、三つのモデルのパラメータ数と周波数の範囲を確かめる
- フィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求める
- フロンティア・レーダー|EgoJEPA:人からロボットへのリターゲティングをやめ、一人称視点の人間の動画から潜在動作を学び、ロボットごとにアダプター 1 組を加えて調整する
- フロンティア・レーダー|SWAM:47,000 時間の動画とデモを世界行動モデルにどう与えるか――キャプションの詳しさ、UMI の動作ラベル、データ混合比を一つずつ検証
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座


