この回の動画
ナレーションは AI 合成音声です。 動画の章・文字起こし・出典
文字起こし
文字起こし
知行の問い
ヒューマノイドの大規模モデルはダウンロードできる。でも、あなたのロボットは見たことがない。どうやって言うことを聞かせるの?今回の目標はひとつ。公開されている GR00T を、新しいロボットにファインチューニングします。データから配備まで、ひと通りやってみます。
まず GR00T を知る
GR00T は、エヌビディアが公開したヒューマノイドの大規模モデルです。画像を見て、指示を聞き、そのまま動作を出力します。ひとつのモデルが、さまざまなスキルをまとめて受け持ちます。ロボットの種類を選びません。同じモデルを、形の違う体に移せます。これがクロスエンボディメントです。重みも公開されています。つまり、手を加えて、自分の製品に組み込めるのです。エヌビディアによると、パラメータは三十億個。エヌビディアはさらに、ライセンスが商用利用を認めていると言います。中身は二つに分かれています。ひとつは考える役、もうひとつはリアルタイムで動作を生み出す役。この速いと遅いの組み合わせが、デュアルシステムです。ファインチューニングが楽なのは、事前学習でたくさん学んでいるからです。白紙から始めなくていい。出発点が高いので、早く仕上がります。たとえるなら、世の中をよく知っている弟子です。あなたの家のルールだけを教えればいいのです。エヌビディアによると、事前学習には二万時間を超える映像を使いました。おもに、人がカメラを身につけて、作業しながらいちにんしょうの視点で撮ったものです。さらに大事なのは、ひとつの法則です。エヌビディアによると、人の映像を千時間から二万時間に増やすと、平均の完了率が二倍以上になりました。エヌビディアによると、千時間から二万時間までは、人の作業を見るほど、手が器用になるんだ!エヌビディアはさらに、効果は具体的だと言います。二十二の自由度を持つ器用な手でも、細かい作業ができるのです。
データを準備する
ファインチューニングの最初の仕事は、データを GR00T が読める形式にすることです。使うのはリロボット形式。これでモデルが読めるようになります。形式は、一から作らないほうがいいでしょう。始める前に、変換スクリプトや例があるか、リポジトリの説明を確かめます。あれば、それを直せば、一から苦労しなくて済みます。データのひとまとまりには、画像、ロボットの状態、動作、それにタスクの指示が必要です。ひとつ欠けると、モデルは対応がとれません。全部そろって、はじめてよいデータです。もうひとつ、モダリティという小さなファイルがあります。動作の中の一つひとつの数が、ロボットのどの関節にあたるかを書いたものです。いわば配線図です。設定をまちがえても、学習はそのまま走ります。でも、学んだ動作がずれてしまいます。だから、まず確認しましょう。まずは例のデータで練習します。ほんの数本で、ロボットアームが四角いブロックをお椀に入れるものです。簡単な作業なので、入門にぴったりです。データがそろえば、学習を始められる。でも、どれくらい大きなマシンがいるの?
コマンド一行で学習
うれしいことに、ファインチューニングは一から学習する必要がありません。自分のデータで、少しだけ続けて学習すればいい。時間も、データも節約できます。コマンドは一行だけ。ベースモデルと自分のデータを指定して、ロボットのタグとモダリティ設定をつけます。引数は多くありませんが、どれも正しくなければなりません。ベース、データ、タグ、設定。どれも欠かせません。ひとつまちがえると、まるごと無駄になります。GPU一枚で動きます。どのGPUで、メモリがどれだけ要るかは、リポジトリの説明に従います。始める前に確かめましょう。あとは、損失が下がるのを待つだけ。学習中は曲線に目を配って、暴走させないように。すうっと下がっていけば、大丈夫です。しばらく学習すると、重みが保存されます。この重みが、あなたのロボット専用の頭脳です。一から学習すると時間がかかるけど、少し続けて学習するだけでいい。すごく節約できるね!
評価と配備
学習が終わったら、よいかどうかをどう確かめるのでしょう?まずは、オープンループ評価です。オープンループとは、録画済みのデータを使うことです。モデルに動作を予測させて、実際の動作と比べます。どれだけずれているか、すぐに分かります。二組の動作を曲線にして描きます。このイメージ図では、一本が予測、もう一本が実際です。二本が近いほど、よく学べています。いちばん分かりやすいサインです。ずれの大きさは、平均二乗誤差で測れます。大きなずれに、とても敏感です。とんでもない予測を見つけ出せます。数字をひとつだけ見ないでください。何本かのデータと、いくつかのシードで試してから、結論を出します。数字は、繰り返しに耐えなければなりません。ただし、オープンループは必要条件にすぎません。予測が正確でも、実機で作業をやりとげられるとは限りません。ここは、はっきり言っておきます。本当に確かめるには、ロボットにつないで、クローズドループで動かします。まずシミュレーションで動かすほうが安全です。安定したら、実機へ。配備も簡単です。方策サーバーを立ち上げて、ロボット側から画像を送り、動作を受け取ります。すっきりしたインターフェースです。もっと速くしたければ、テンソルアールティーも使えます。エッジデバイスで動かすこともできます。どこに配備するか次第です。正直に言っておくことが、もうひとつ。同じデータで二回学習すると、結果が少しぶれます。ノイズを改善と取りちがえないでください。
実践:例を動かす
一緒にやってみましょう。まず、リポジトリをサブモジュールごとクローンします。サブモジュールが抜けると、あとでエラーになります。環境を整えたら、ハギングフェイスにログインします。次に、リポジトリの説明に従って、必要な権限を申請します。権限が足りないと、読み込みに失敗します。それから、例のデータで、あのファインチューニングのコマンドを実行します。ロボットのタグは、新しい体の選択肢を選びます。学習中はログを開いたまま、損失とスループットを見張ります。暴走したら、早めに止めましょう。終わったら、オープンループ評価を一回。予測と実際を同じグラフに表示して、二本の線が重なっているかを見ます。すぐにわかります。再現はうまくいったのでしょうか?二本の線が、はっきり近づいたかを見ます。ファインチューニング前より、どれだけよくなったかも見ます。まだ解けていないのは、オープンループがよくても、クローズドループが安定するとは限らないことです。実機では、誤差が一歩ずつ積み重なっていきます。まとめです。ポイントは三つ。一つ、GR00T は公開され、商用利用もできるヒューマノイドの大規模モデル。二つ、ファインチューニングは、まずリロボット形式のデータを用意する。三つ、コマンド一行で続けて学習し、オープンループ評価で確かめる。仕組みを知って、データを用意して、コマンドを一つ打つだけ。あなたも大規模モデルを自分のものにできる!でも、こういう成功率や改善って、本物か、大げさに言われてるのか、どう見分けるの?また次回!
根拠と出典
商用可 · ライセンス。エヌビディアは GR00T N1.7 を、公開され商用ライセンスのあるモデルとしている [O] · NVIDIA · Hugging Face ブログ「GR00T N1.7」
22自由度 · の器用な手。この器用さの法則によって、22自由度の手でも接触の多い細かい作業ができるように [O] · NVIDIA · Hugging Face ブログ「GR00T N1.7」
練習とセルフチェック
小テストは公開で、回答するとすぐ解説が出ます。読み物の練習問題の答えはログイン会員向けです。
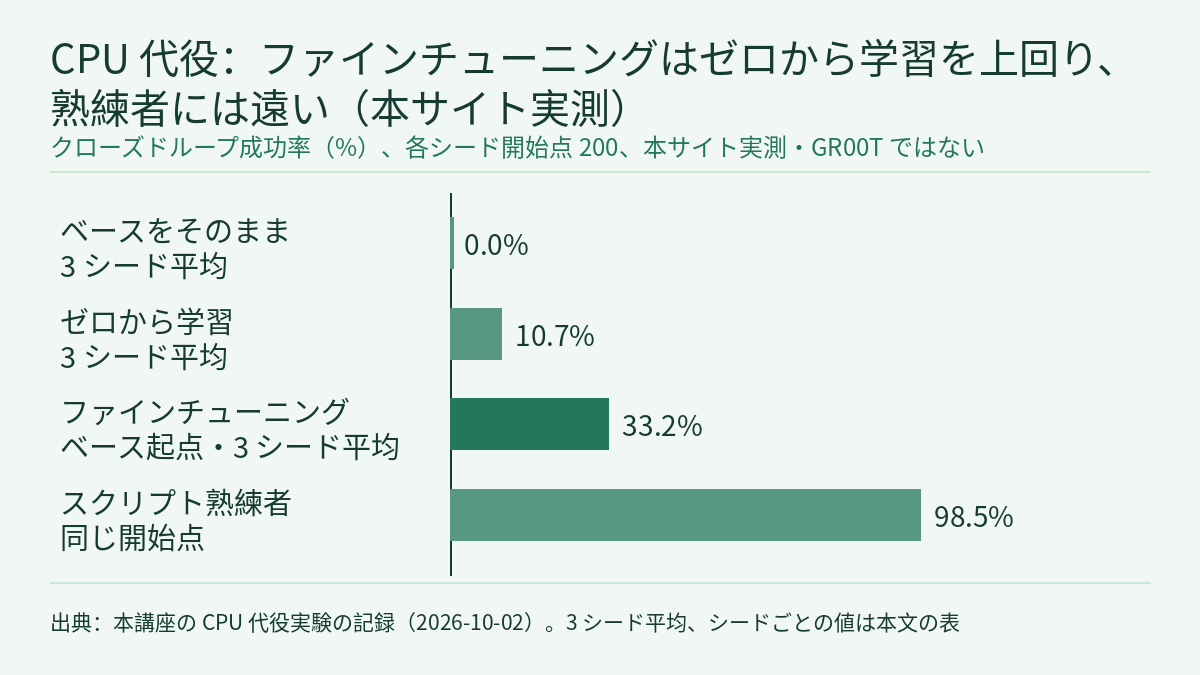
第 3.5 回の動画は、公開されている GR00T N1.7 を新しいロボットにファインチューニングします。まずモデルを知り、次にデータを LeRobot 形式にして modality 設定を書き、コマンド一行で事前学習済みのモデルから少しだけ続けて学習し、最後にオープンループ評価で確かめます。オープンループがよくても実機のクローズドループが安定するとは限らない、という注意も付いています。動画の数字カードは、すべて NVIDIA が Hugging Face で公開した GR00T N1.7 のブログから取っています。このページはこの回の解説と練習です。文字起こしは繰り返さず、動画が触れただけで展開しなかった三つのことを行います。ブログのファインチューニングのコマンドを引数ごとに見て、「ブログが書いていること」「自分で用意するもの」「リポジトリの説明で確かめること」に分けます。modality 設定を配線図として扱い、学習前には録画データの範囲と照らし合わせ、評価では次元ごとに誤差を報告します。そして、本講座が CPU で動かした小さな代役実験を使い、訓練・検証・テストの各データでのオープンループ誤差とクローズドループ成功率が、それぞれ何を示すのかを確かめます。全体を通す約束は、オープンループ誤差とクローズドループ成功率は別の量で、分けて報告すること、そして数字はそれを測ったモデル、データ、設定だけのもので、代役実験の数字を GR00T の結果として扱わないことです。
この回の動画、文字起こし、出典はこのページの上部にあります。シーズン全体の構成は講座の概要をご覧ください。前回のフィジカルAIラボ 3.4:長期タスク――ステップごとの成功率とチェーン全体の成功率を手で計算し、進み具合の記憶が変える量を確かめ、上位層だけを入れ替えたルーティングのアブレーションを審査するは、下位のその方策を自分のロボットにどう合わせるのか、という問いで終わりました。この回はその続きです。GR00T N1 のデュアルシステムの構造とパラメータはフィジカルAIラボ 3.1:VLA を分解する――コップを置く動作を 256 区間のトークンに直し、三つのモデルのパラメータ数と周波数の範囲を確かめるで分解しました。LeRobot のデータセットのメタデータをモデルの入力に対応づける方法と、ステップ数とバッチサイズを分けて数える方法はフィジカルAIラボ 2.2:LeRobot で ACT を学習させる――データセットのメタデータをモデルの入力に対応づけ、学習と評価のコマンドを一項目ずつ確かめるで、公開のベースモデルから VLA をファインチューニングするコマンドと数字の範囲はフィジカルAIラボ 2.3:SmolVLA をファインチューニングする――指示に合わせてお手本を計画し、各数字が何を測ったかを確かめ、非同期の動作キューの時間を計算するで扱いました。対応表と区間は、フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめるとフィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求めるで計算しました。この回はそれらを繰り返さず、GR00T N1.7 のブログが示すファインチューニングの入口、modality 設定の確認、そしてオープンループとクローズドループの間がどれだけ離れているかだけを扱います。次回 3.6 は、論文の読み方と数字の確かめ方です。
公開小テストの 5 問には詳しい解説が付いています。ログインすると、三つの練習に取り組めます。ブログのコマンドに沿って架空のロボットアームのファインチューニング実行シートを書き、サンプル数を計算してデータをエピソード単位で分ける。架空の録画範囲をもとに modality 設定の下書きを審査し、次元ごとのオープンループ誤差を計算する。本講座の代役実験の記録を使って架空の評価メモを審査し、結論を書き直す。いずれにも段階的な解答例、よくある誤り、20 点満点の採点基準が付いています。
1. GR00T N1.7 のブログが書いていること、書いていないこと
このブログは NVIDIA が自社のモデルを紹介したもので、2026 年 4 月 17 日に公開されました。本講座の分類では O レベルです。以下の構造、数字、用途はすべてベンダーの報告で、本サイトは GR00T N1.7 をダウンロードも実行もしていません。ブログの冒頭は、今回の公開が Early Access 版であると明記し、商用ライセンス付きの公開されたヒューマノイド向け VLA だと説明しています。原文は次のとおりです。
open, commercially licensed
動画の「30億パラメータ」の数字カードは、次の一文に対応します。
GR00T N1.7 is a 3B-parameter open reasoning Vision-Language-Action (VLA) model that maps visual observations and natural language instructions to continuous robot actions.
ブログによると、構成はデュアルシステムです。System 2 は Cosmos-Reason2-2B をバックボーンとする視覚・言語モデル、System 1 は 32 層の拡散 transformer で、VLM の出力とロボットのリアルタイムの状態を受け取り、デノイズしてモーター指令にします(System 2 の原文は 3.4 で引用しました)。ファインチューニングにとっていちばん役立つのは、ブログが明記している入力と出力です。
Inputs: RGB image frames (any resolution) + language instruction + robot proprioceptive state (joint positions, velocities, EEF poses)
Outputs: Continuous-value action vectors mapped to the robot’s degrees of freedom
この二文から、データの各エピソードは画像、指示、自己受容の状態をそろえる必要があり、モデルが出す動作ベクトルの各次元はロボットの自由度に一つずつ対応していなければならない、と読めます。動画はこれを書き出すファイルを modality 設定と呼んでいます。ブログはこのファイルの形式を説明していません。ファインチューニングの入口についても、書いてあるのは一文だけです。
N1.7 supports fine-tuning on custom embodiments using the LeRobot dataset format.
ブログはさらに、モデルを Unitree G1、Bimanual Manipulator YAM、AGIBot Genie 1 で検証したこと、NVIDIA Ampere、Hopper、Lovelace、Blackwell、Jetson の各プラットフォームに対応していること、事前学習に 20,854 時間の人の一人称視点映像を使ったこと、人の映像を 1k 時間から 20k 時間に増やすと平均タスク完了率が二倍以上になったことを述べています。いずれも NVIDIA の報告で、ブログはタスクの一覧も試行回数も示していません。
実際に手を動かす人には、ブログが書いていないことも同じくらい重要です。必要な GPU メモリ、2000 ステップのファインチューニングにかかる時間、ファインチューニング後のどのロボットでの成功率、新しい機体に使うタグ名、modality 設定のファイル形式です。推論性能は「4 ステップのデノイズ、単一カメラ視点」というリンクがあるだけで、本文に数字はありません。これらはリポジトリの説明で調べる必要があり、ブログから推し量ることはできません。
ログインすると、このレッスンの続きと確認問題、解答を読めます。
制約と注意点
- GR00T N1.7 のブログは NVIDIA が自社のモデルを紹介したもので、O レベルです。パラメータ数、検証プラットフォーム、事前学習の 20,854 時間の映像、完了率の「二倍以上」、「drop-in swap」は、いずれもベンダーの報告です。本サイトは GR00T N1.7 をダウンロードも実行もしておらず、ここに載せたコマンドはブログから写したもので、実行していません。
- ブログは、メモリの要件、ファインチューニングの所要時間、ファインチューニング後の成功率、新しい機体のタグ名、modality 設定の形式を示していません。これらはリポジトリの説明に従ってください。動画の「GPU 一枚で動きます」はブログのコマンドの
--num-gpus 1に対応しますが、本サイトは確かめていません。 - ブログのインストール手順はリポジトリの既定のブランチをクローンし、バージョンを固定していません。リポジトリの更新で引数名が変わる可能性がある、というのは本講座の推測です。
- 第 4 節の代役実験は本講座自身の CPU での実行(2026-10-02、本サイト実測)です。平面 3 関節アーム、小さな MLP 方策、視覚入力なしで、GR00T でも実機でもありません。本文には実行記録の集計値だけを転記し、実行スクリプトとシードごとの Wilson 区間は転記していません。
- 次のものは本講座の計算、整理、提案です。三つのシードの平均と比、第 2 節の引数の表、第 3 節の確認の順序、課題3の(4)の次の手順。
- アーム R、そのデータ、可動範囲、設定の下書き、次元ごとの誤差、同僚 Q のメモ、各応用課題の数字は架空です。紙の上の計算も、代役実験も、シミュレーションの結果も、ハードウェアの安全性の検証ではありません。
リンク
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)
- フィジカルAIラボ 3.4:長期タスク――ステップごとの成功率とチェーン全体の成功率を手で計算し、進み具合の記憶が変える量を確かめ、上位層だけを入れ替えたルーティングのアブレーションを審査する
- フィジカルAIラボ 3.1:VLA を分解する――コップを置く動作を 256 区間のトークンに直し、三つのモデルのパラメータ数と周波数の範囲を確かめる
- フィジカルAIラボ 2.2:LeRobot で ACT を学習させる――データセットのメタデータをモデルの入力に対応づけ、学習と評価のコマンドを一項目ずつ確かめる
- フィジカルAIラボ 2.3:SmolVLA をファインチューニングする――指示に合わせてお手本を計画し、各数字が何を測ったかを確かめ、非同期の動作キューの時間を計算する
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求める
- NVIDIA Isaac GR00T N1.7: Open Reasoning VLA Model for Humanoid Robots(Hugging Face ブログ)