
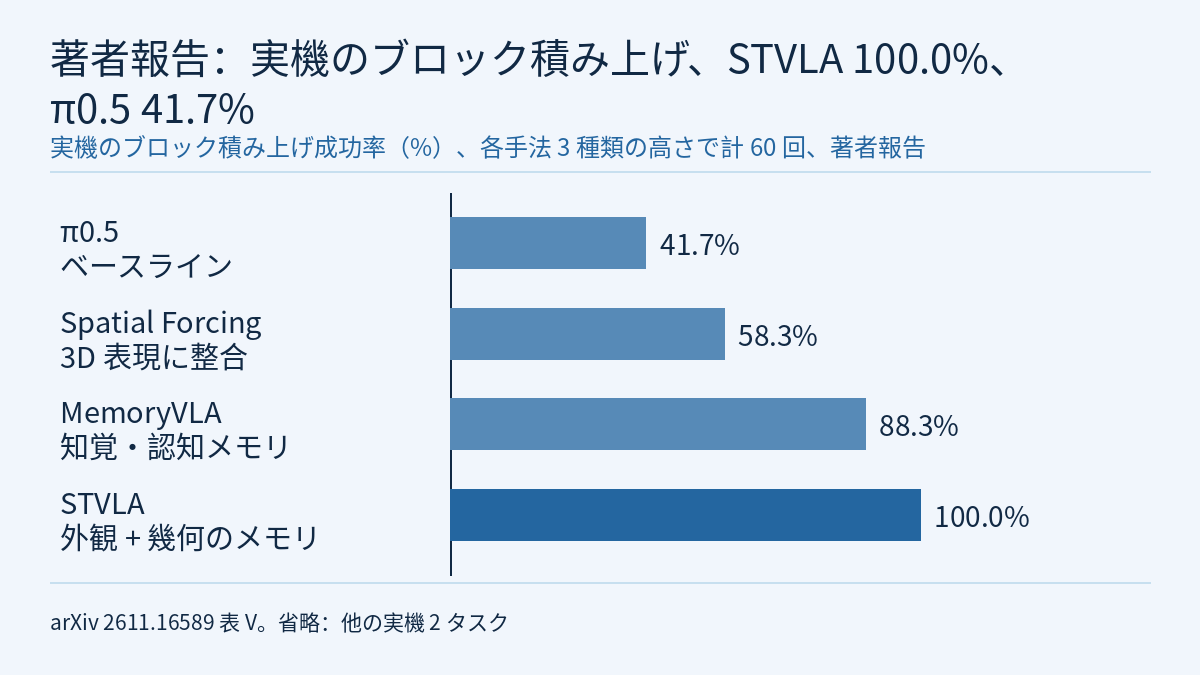
多くの VLA は主に現在の観測から動作を決めます。見た目が似ていてもタスクの進み具合が違うと、方策は終えた手順を繰り返すことがあります。台の高さや、ある場所がまだ空いているかといった幾何情報に動作が左右される場合、1 フレーム・1 視点の 2D 特徴ではそれを表せません。arXiv 2611.16589(2026-11-12)の STVLA は、凍結した視覚ジオメトリモデル VGGT-Ω から取り出した空間トークンを、バックボーンの外観トークンと対にして 1 つの有界メモリに保存し、動作を生成するときに過去のシーン構造を呼び出せるようにします。著者報告では、AGIBOT G2 双腕実機の 3 タスクで成功率が π0.5 より 30.0〜58.3 ポイント高くなりました。以下の数値はすべて著者報告 [R] です。本サイトはコードを実行しておらず、独立した再現もしていません。
メモリに何を保存するか:外観トークンと幾何トークン
STVLA は、π0.5 の PaliGemma 視覚言語モデルとフローマッチングの動作エキスパートに、空間トークン化と有界の視覚・空間メモリを加えます。論文に書かれた実装は次のとおりです。
- 空間トークン:凍結した 1B パラメータの VGGT-Ω が固定ヘッドカメラの K = 4 フレーム(512 px)を読み、前のフレームを文脈として使い、現在フレームの特徴だけを取り出します。1 フレームあたり幅 2048 のパッチ特徴が 1024 個です。学習可能な圧縮器が、学習クエリによるクロスアテンション 1 層でこれを N_s = 256 個の空間トークンに集約します。途中に変分ボトルネックを挟みます。
- メモリバンク:各ステップで現在の SigLIP 視覚トークンと空間トークンを連結して 1 件として保存します。容量は L_m = 16 で、超えると最も古い 1 件を捨て、エピソードの開始ごとに空にします。現在のトークンは L = 2 層のクロスアテンションでバンク全体に問い合わせ、各クエリは過去の視覚トークンと空間トークンの両方を参照できます。取り出した特徴は要素ごとのゲートで現在のトークンと融合します。
- 動作の条件付け:空間トークンはプレフィックス内に専用の区画を持ち、区画の中でだけ互いに注意し、元のプレフィックストークンからは見えません。動作トークンはプレフィックス全体を参照します。著者は、これでバックボーン本来の画像・言語のアテンションパターンが保たれると述べています。
- 学習:フローマッチングの動作損失に、圧縮器の特徴再構成損失(重み 1)と KL 損失(重み 10⁻⁴)を加えます。推論時はサンプリングせず事後分布の平均を使います。学習には NVIDIA H100 を 8 基、GPU あたりバッチサイズ 16 で使っています。
著者の出発点は次の観察です。外観特徴だけを保存するメモリは、グリッパーが作業領域を隠したり視点が変わったりすると、物理的に同じ状態の保存フレームと現在のフレームが似て見えなくなり、検索に失敗します。現在フレームだけから計算した空間表現は、シーンのどの部分を方策がすでに変えたかを知りません。本サイトで紹介した他のメモリ方式は保存するものが違います。REKI は動作エキスパート内のレジスタトークンに直近数フレームを保持し、Fast-VLA はエピソードごとに 1 回だけ VLM に KV タスクメモリを作らせます。タスク単位の進み具合の記憶がなぜ手順の繰り返しを減らすかは、フィジカルAIラボ 3.4 でチェーン全体の成功率を使って計算しました。STVLA が新しく加えたのは、メモリの各エントリに明示的な幾何トークンを含めた点です。
どのエントリを呼び出すか:関連性と非冗長性のスコア
16 件のエントリはすべてアテンションに参加し、STVLA は各エントリに共通のバイアスを加えるだけです。j 番目のエントリについて、エントリと現在のトークンのトークン方向の平均 h_j と x̄_t を取り、次の 2 つを計算します。
- 類似度 r_j = (1 + cos(h_j, x̄_t)) / 2
- 差異度 u_j = ‖h_j − x̄_t‖ / (‖h_j‖ + ‖x̄_t‖)
両者の積 s_j をエントリ間で標準化し、β / τ_r を掛けて、そのエントリのすべてのトークンのアテンション logit に加えます。このスコアには学習パラメータがなく、特徴選択の「最大関連・最小冗長」基準から着想を得ています。論文は、この積は特徴空間での代理量であり、タスク固有の情報利得を直接推定するものではないと明記しています。バイアスは重みを変えるだけで、過去のエントリを除外することはありません。
このスコアは β に敏感です。実機のブロック積み上げ(τ_r = 1、各設定 3 種類の高さで計 60 回)では、バイアスを切った β = 0 で成功率 80.0%、β = 0.05、0.3、0.8 はいずれも 71.7% でバイアスなしを下回り、β = 0.5 で 100.0%、β = 1.0 で 81.7% でした。著者も、効果は尺度に依存し、バイアスを強めるほど増えるわけではないと書いています。VGGT-Ω の入力フレーム数 K を 1 から 5 にすると、成功率は順に 88.3%、93.3%、85.0%、100.0%、86.7% で、これも単調ではありません。著者は、フレームが増えると特徴は豊かになるが推論遅延も増えると説明しており、論文に遅延の数値はありません。
4 つのシミュレーションベンチマーク:同じ手順で比べたのは π0.5 だけ
著者は、LIBERO、LIBERO-Mem、MIKASA-Robo、SimplerEnv Bridge のそれぞれで STVLA の平均成功率が掲載手法の中で最も高いと報告しています。表を読むときは、まずどの行を著者自身が実行したかを確かめる必要があります。4 つの表のいずれでも「著者が学習・評価」と記されているのは π0.5 と STVLA だけで、著者はシミュレーションでは両者に同じデータと同じ最適化ステップ数を使ったと明記しています。MemoryVLA などその他の行の多くは MemoryVLA の論文や他の文献からの引用で、評価設定が同じとは限りません。下の表は著者が実行した 2 行だけを示します(成功率 %)。
| ベンチマーク | タスクあたりの試行回数 | π0.5 | STVLA | 差(ポイント) |
|---|---|---|---|---|
| LIBERO(5 スイート、評価シード 7) | 50 | 96.6 | 97.8 | +1.2 |
| LIBERO-Mem(10 タスク) | 20 | 38.0 | 41.0 | +3.0 |
| MIKASA-Robo(5 タスク) | 100 | 32.4 | 45.2 | +12.8 |
| SimplerEnv Bridge(4 タスク) | 24 | 66.7 | 74.0 | +7.3 |
差の列は本サイトが表の数値を引き算したものです。タスク別に見ると、改善は一様ではありません。LIBERO-Mem では、繰り返し配置のタスク B×5 と B×7 がそれぞれ 30 ポイント上がりました(70 対 40、40 対 10)。一方で Cs→Bskt は 55 から 25 に下がり、Bt→P と Swap2 はそれぞれ 5 ポイント低くなっています。SimplerEnv では、スプーンのタスクで π0.5 を下回り(79.2 対 83.3)、ニンジンのタスクで MemoryVLA を下回りました(62.5 対 75.0)。5 タスクすべてで π0.5 を上回ったのは MIKASA-Robo だけです。論文はシミュレーションの成功率について区間も複数シードの結果も示していません。
実機 3 タスクとアブレーション:試行回数から読む
実機は AGIBOT G2 双腕ロボットで、固定ヘッドの RGB カメラ 1 台と手首の RGB カメラ 2 台を備えています。タスクごとのデモ数と STVLA の学習ステップ数は、ブロック積み上げが 817 件・30k ステップ、物品整理が 237 件・20k ステップ、スマートフォン梱包が 203 件・40k ステップです。ブロック積み上げは 3 種類の目標高さで各 20 回、計 60 回、他の 2 タスクは手法ごとに各 20 回試しています。比較手法 2 つは、論文の関連研究の説明によると次のとおりです。Spatial Forcing は VLA の中間特徴を事前学習済み 3D 基盤モデルの表現にそろえ、推論時に明示的な 3D 入力を必要としません。MemoryVLA は有界の知覚・認知メモリバンクを持ちます。成功率(%):
| 手法 | ブロック積み上げ(60 回) | 物品整理(20 回) | スマートフォン梱包(20 回) | 平均 |
|---|---|---|---|---|
| π0.5 | 41.7 | 55.0 | 10.0 | 35.6 |
| Spatial Forcing | 58.3 | 40.0 | 10.0 | 36.1 |
| MemoryVLA | 88.3 | 35.0 | 15.0 | 46.1 |
| STVLA | 100.0 | 85.0 | 45.0 | 76.7 |
著者による失敗の分類は次のとおりです。ブロック積み上げでは、π0.5 と Spatial Forcing の失敗の多くは実行時のためらいか、把持・配置中の落下です。物品整理では、π0.5 の失敗は主にブロックをつかめないことと、最後の手順で左腕のボタンを重ねて押すことでした。スマートフォン梱包では MemoryVLA と STVLA のどちらにもためらいによる失敗はなく、STVLA に残った失敗は充電器の把持か、スマートフォンケースの最後の配置でした。著者はここから、メモリはサブタスク間の移行を助ける可能性があるが、精密な把持と配置はなお難しいと考えています。
論文は実機の成功率に区間を示していません。フィジカルAIラボ 2.8 の Wilson 95% 区間で概算すると次のようになります(本サイトの推算。各試行を独立とみなし、ブロック積み上げでは 3 種類の高さの違いを無視しています)。
- ブロック積み上げ:STVLA 60/60 は約 94.0%〜100%、π0.5 25/60 は約 30.1%〜54.3% で、重なりません。MemoryVLA 53/60 は約 77.8%〜94.2% で、STVLA の区間とわずかに重なります。
- 物品整理:STVLA 17/20 は約 64.0%〜94.8%、π0.5 11/20 は約 34.2%〜74.2% で、重なります。
- スマートフォン梱包:STVLA 9/20 は約 25.8%〜65.8%、π0.5 2/20 は約 2.8%〜30.1% で、重なります。
つまり、π0.5 に対する 30.0〜58.3 ポイントの差のうち、現在のサンプル数で区間がはっきり分かれるのはブロック積み上げだけです。他の 2 タスクも同じ方向ですが、手法ごとに 20 回しかなく、各手法の区間は重なります。重なりはこの概算では両者を区別できないことを示すだけで、差が有意でないことを意味するわけではありません。論文は統計的検定を示していません。
アブレーションもブロック積み上げで行われています。STVLA 全体は 100.0%、メモリなしは 95.0%、空間分岐なしは 96.7% で、60 回に換算すると差は 3 回と 2 回です。概算の Wilson 区間(約 86.3%〜98.3% と 88.6%〜99.1%)はどちらも完全なモデルの区間と重なります。著者は失敗の形の違いも補足しています。メモリなしではためらいが増え、空間分岐なしでは空振りの把持と配置の誤りが出ました。既定値の β = 0.5 と K = 4 は、第 2 節の単調でない探索でそれぞれ最高だった点で、主表の 100.0% と同じタスク・同じ既定設定です。本サイトが読んだ本文には、この 2 つの値を別の評価で事前に選んだかどうかは書かれていません。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者報告 [R] です。独立した再現はありません。論文はどの成功率についても区間、標準偏差、複数シードの結果を示しておらず、上の Wilson 区間は本サイトが回数から概算したものです。
- 著者の所属は AgiBot で、実機の AGIBOT G2 は所属先と同じブランドです。
- シミュレーションについて、著者は π0.5 と STVLA が同じデータとステップ数を使ったと明記しています。実機について、本サイトが読んだ本文には STVLA のデモ数と学習ステップ数しかなく、各ベースラインが同じデータと学習予算を使ったかは書かれていません。
- シミュレーションの各表では MemoryVLA などのベースラインの多くが他の論文からの引用です。「各ベンチマークで平均が最も高い」には、評価設定が一致するとは限らない論文間の比較が含まれます。LIBERO の表の注も、4 スイートと 5 スイートの平均は直接比較できないとしています。
- 著者が明記した制約:事前学習済み 3D モデルの特徴から常に質の高い空間トークンが得られるわけではありません。メモリバンクは短い時間窓(容量 16)しか保持しないため、はるかに長いタスクでは効果が限られます。
- 推論では毎ステップ 1B パラメータの VGGT-Ω を動かします。論文はフレーム数が増えると推論遅延が増えると述べていますが、遅延や制御周波数は報告していません。
- 論文にはプロジェクトサイトのアドレスがありますが、本サイトは開いておらず、コードやモデルが公開されているかも確認していません。
リンク
- STVLA: Spatial-aware and Temporal-memory for Vision-Language-Action Models(arXiv 2611.16589)
- 論文の HTML 版全文
- フィジカルAIラボ 3.4:長期タスク――ステップごとの成功率とチェーン全体の成功率を手で計算し、進み具合の記憶が変える量を確かめ、上位層だけを入れ替えたルーティングのアブレーションを審査する
- フィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求める
- フロンティア・レーダー|REKI:動作エキスパートの 32 個のレジスタトークンが直近数フレームを記憶し、アームが 2 つの姿勢の間を往復する振動エピソードは約 4 分の 1 に
- フロンティア・レーダー|Fast-VLA:4B VLM はエピソードごとに 1 回だけ考え、実行器は動作チャンクごとに固定の KV タスクメモリを参照する
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座


