
很多 VLA 主要根据当前观测决定动作。画面相似、任务进度不同时,策略可能重复已完成的步骤;动作又依赖桌面高度、某个位置是否已被占用这类几何信息时,单帧单视角的 2D 特征表达不出来。arXiv 2611.16589(2026-11-12)的 STVLA 把一个冻结的视觉几何模型 VGGT-Ω 提取的空间 token,和骨干的外观 token 成对存进同一个有界记忆,让策略在出动作时能取回过去的场景结构。作者报告:在 AGIBOT G2 双臂真机的三项任务上,成功率比 π0.5 高 30.0–58.3 个百分点。下文数字均为作者报告 [R],本站没有运行代码,也没有独立复现。
记忆里存的是什么:外观 token 加几何 token
STVLA 在 π0.5 的 PaliGemma 视觉-语言模型和流匹配动作专家之上加了两样东西:空间 token 化和有界的视觉-空间记忆。论文给出的实现如下:
- 空间 token:冻结的 1B 参数 VGGT-Ω 读取固定头部相机的 K = 4 帧(512 px),前几帧作上下文,只取当前帧的特征,每帧 1024 个宽 2048 的 patch 特征。一个可训练的压缩器用一层可学习查询的交叉注意力把它们汇成 N_s = 256 个空间 token,中间经过一个变分瓶颈。
- 记忆库:每一步把当前的 SigLIP 视觉 token 和空间 token 拼成一条记录存进去,容量 L_m = 16,超出时丢弃最旧的一条,每个回合开始时清空。当前 token 通过 L = 2 层交叉注意力查询整个记忆库,查询可以同时看到历史中的视觉和空间 token;取回的特征经逐元素门控与当前 token 融合。
- 动作条件:空间 token 在前缀里单独占一段,只在本段内互相注意,对原有前缀 token 不可见;动作 token 能看到全部前缀。作者说这样保留了骨干原有的图像-语言注意力模式。
- 训练:流匹配动作损失,加上压缩器的特征重建损失(权重 1)和 KL 损失(权重 10⁻⁴);推理时用后验均值,不采样。训练用 8 块 NVIDIA H100,每卡批大小 16。
作者的出发点是:只存外观特征的记忆,在夹爪遮住工作区或视角变化后,当前帧和记忆中物理状态相同的那一帧看起来不再相似,检索就会失败;只对当前帧算空间表示,又不知道哪些部分已经被策略改变过。站内介绍过的其他记忆做法存的东西不同:REKI 在动作专家里用寄存器 token 缓存最近几帧,Fast-VLA 每个回合只让 VLM 生成一次 KV 任务记忆。任务级进度记忆为什么能减少重复步骤,物理AI实验室 3.4 用链式成功率算过。STVLA 的新意在于记忆条目里带了显式的几何 token。
从记忆里取哪几条:相关又不重复的打分
16 条记录都会参与注意力,STVLA 只是给每条记录加一个共享的偏置。对第 j 条记录,先取它和当前 token 的逐 token 均值 h_j 与 x̄_t,算两个量:
- 相似度 r_j = (1 + cos(h_j, x̄_t)) / 2;
- 差异度 u_j = ‖h_j − x̄_t‖ / (‖h_j‖ + ‖x̄_t‖)。
两者相乘得到 s_j,在所有记录间标准化后乘以 β / τ_r,加到这条记录所有 token 的注意力 logit 上。这个分数没有可学习参数,思路借自特征选择里的“最大相关、最小冗余”准则。论文明确说,乘积只是特征空间里的代理量,不是对任务信息增益的直接估计。偏置只改变权重,不会把任何历史条目排除在外。
这个打分对 β 很敏感。在真机积木堆叠上(τ_r = 1,每个设置 3 种高度共 60 次),β = 0 即关掉偏置时成功率 80.0%;β = 0.05、0.3、0.8 都是 71.7%,低于不加偏置;β = 0.5 为 100.0%,β = 1.0 为 81.7%。作者也写明收益取决于尺度,不随偏置增大而单调增加。VGGT-Ω 输入帧数 K 取 1 到 5 时成功率依次为 88.3%、93.3%、85.0%、100.0%、86.7%,同样不单调;作者解释说帧数多了特征更足,但推理延迟也会增加,论文没有给出延迟的数字。
仿真四个基准:同一协议下的对比只有 π0.5
作者在 LIBERO、LIBERO-Mem、MIKASA-Robo 和 SimplerEnv Bridge 上报告 STVLA 的平均成功率在所列方法中最高。读表时要先看哪些行是作者自己跑的:四张表里只有 π0.5 和 STVLA 标了“由作者训练并评测”,并且作者写明仿真中两者用相同数据和相同优化步数;MemoryVLA 等其余行大多取自 MemoryVLA 论文或其他文献,评测设置不一定相同。下表只列作者自己跑的两行(成功率 %):
| 基准 | 每任务试验次数 | π0.5 | STVLA | 差值(个百分点) |
|---|---|---|---|---|
| LIBERO(五个套件,评测种子 7) | 50 | 96.6 | 97.8 | +1.2 |
| LIBERO-Mem(10 项任务) | 20 | 38.0 | 41.0 | +3.0 |
| MIKASA-Robo(5 项任务) | 100 | 32.4 | 45.2 | +12.8 |
| SimplerEnv Bridge(4 项任务) | 24 | 66.7 | 74.0 | +7.3 |
差值一列是本站按表中数字相减。分任务看,提升并不均匀。LIBERO-Mem 里,重复放置任务 B×5 和 B×7 各高 30 个百分点(70 对 40、40 对 10),但 Cs→Bskt 从 55 降到 25,Bt→P 和 Swap2 各低 5 个百分点。SimplerEnv 上 STVLA 在放勺子一项低于 π0.5(79.2 对 83.3),在放胡萝卜一项低于 MemoryVLA(62.5 对 75.0)。MIKASA-Robo 是唯一一个五项任务都高于 π0.5 的基准。论文没有给出仿真成功率的区间或多种子结果。
真机三项任务与消融:按试验次数读
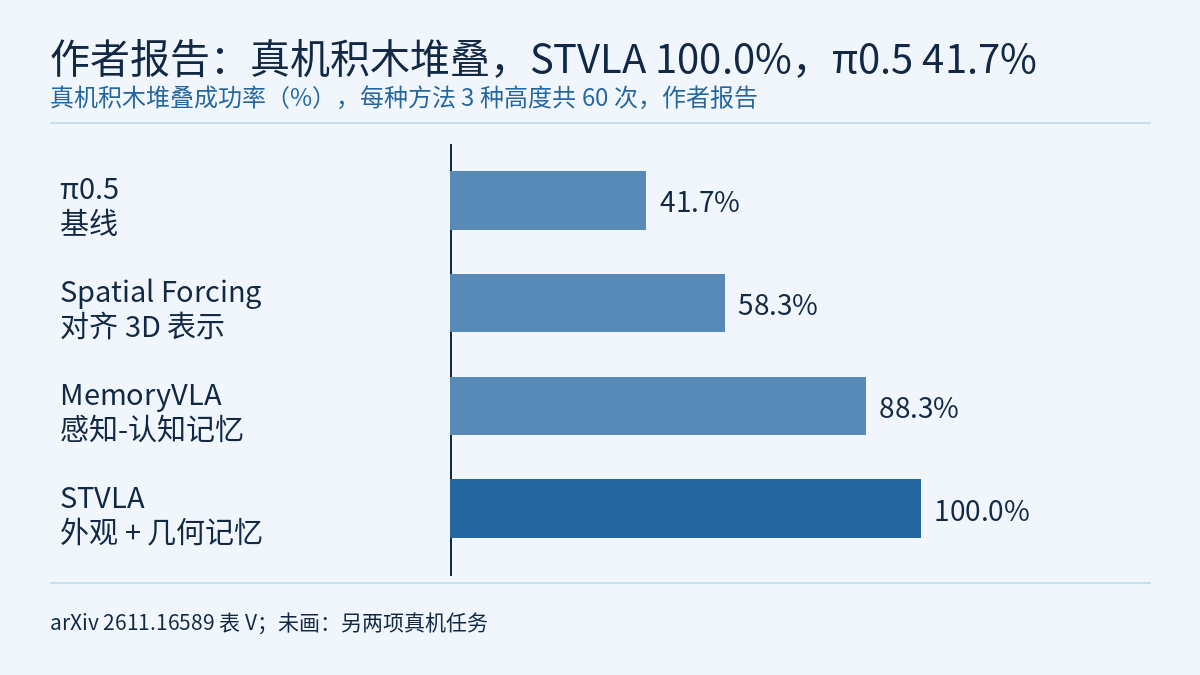
真机平台是 AGIBOT G2 双臂机器人,一个固定头部 RGB 相机加两个腕部 RGB 相机。三项任务的示范数和 STVLA 的训练步数分别是:积木堆叠 817 条、30k 步;物品整理 237 条、20k 步;手机装盒 203 条、40k 步。积木堆叠测 3 种目标高度,每种 20 次,共 60 次;另两项每种方法各 20 次。两个对照方法按论文的相关工作介绍:Spatial Forcing 把 VLA 的中间特征与预训练 3D 基础模型的表示对齐,推理时不需要显式 3D 输入;MemoryVLA 维护一个有界的感知-认知记忆库。成功率(%):
| 方法 | 积木堆叠(60 次) | 物品整理(20 次) | 手机装盒(20 次) | 平均 |
|---|---|---|---|---|
| π0.5 | 41.7 | 55.0 | 10.0 | 35.6 |
| Spatial Forcing | 58.3 | 40.0 | 10.0 | 36.1 |
| MemoryVLA | 88.3 | 35.0 | 15.0 | 46.1 |
| STVLA | 100.0 | 85.0 | 45.0 | 76.7 |
作者对失败的归类:π0.5 和 Spatial Forcing 在积木堆叠中多因执行犹豫或抓放时掉落而失败;物品整理中 π0.5 的失败主要是没抓住积木,以及最后一步重复按左臂按钮;手机装盒中 MemoryVLA 和 STVLA 都没有出现犹豫类失败,STVLA 剩下的失败在充电器抓取或手机壳最后放置。作者据此认为记忆可能让子任务衔接更顺,精确抓放仍然困难。
论文没有给出真机成功率的区间。按 物理AI实验室 2.8 的 Wilson 95% 区间粗算(本站推算,把每次试验当作独立,积木堆叠忽略三种高度之间的差异):
- 积木堆叠:STVLA 60/60 约 94.0%–100%,π0.5 25/60 约 30.1%–54.3%,两者不重叠;MemoryVLA 53/60 约 77.8%–94.2%,与 STVLA 的区间刚好重叠。
- 物品整理:STVLA 17/20 约 64.0%–94.8%,π0.5 11/20 约 34.2%–74.2%,有重叠。
- 手机装盒:STVLA 9/20 约 25.8%–65.8%,π0.5 2/20 约 2.8%–30.1%,有重叠。
也就是说,三项“比 π0.5 高 30.0–58.3 个百分点”中,在当前样本量下区间明显分开的只有积木堆叠一项。另两项方向一致,但每种方法只有 20 次,单组区间相互重叠;区间重叠只说明这种粗算分不开两者,不等于差异不显著,论文也没有给出统计检验。
消融也都在积木堆叠上做。完整 STVLA 为 100.0%,去掉记忆为 95.0%,去掉空间分支为 96.7%,按 60 次折算分别差 3 次和 2 次;粗算的 Wilson 区间(约 86.3%–98.3% 和 88.6%–99.1%)都与完整模型重叠。作者补充了失败形态上的区别:去掉记忆后犹豫更多,去掉空间分支后出现空抓和放置错误。β = 0.5 和 K = 4 两个默认值各是第二节非单调扫描中的最高点,与主表 100.0% 属于同一任务、同一默认配置;所读文本没有说明这两个值是否在另一组评测上预先选定。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],没有独立复现;论文没有给出任何成功率的区间、标准差或多种子结果,上文的 Wilson 区间是本站按计数粗算。
- 作者单位是 AgiBot,真机平台 AGIBOT G2 与作者单位同一品牌。
- 仿真里作者写明 π0.5 与 STVLA 用相同数据和步数;真机部分所读文本只写了 STVLA 的示范数和训练步数,没有写明各基线是否用了相同的数据和训练预算。
- 各仿真表中 MemoryVLA 等基线多数取自其他论文,“在每个基准上平均最高”包含跨论文、评测设置不一定一致的比较;LIBERO 表注也写明四套件与五套件的平均值不能直接比较。
- 作者写明的局限:预训练 3D 模型的特征不一定能产生高质量的空间 token;记忆库只覆盖很短的时间窗(容量 16),对更长程的任务帮助有限。
- 推理时每步都要运行 1B 参数的 VGGT-Ω,论文提到帧数增加会抬高推理延迟,但没有报告延迟或控制频率。
- 论文给出了项目网站地址,本站没有打开,也没有查到代码或模型是否公开。
链接
- STVLA: Spatial-aware and Temporal-memory for Vision-Language-Action Models(arXiv 2611.16589)
- 论文 HTML 全文
- 物理AI实验室 3.4:长程任务,手算单步与整条链的成功率,看进度记忆改变了哪一项,再审一次只换高层的路由消融
- 物理AI实验室 2.8:可复现评测,手算 Wald 与 Wilson 区间,从 1/√n 定评测次数,再给零失败算出失败率上界
- 前沿雷达|REKI:动作专家里的 32 个寄存器 token 记住最近几帧,手臂在两个位姿间来回振荡的回合约少到四分之一
- 前沿雷达|Fast-VLA:每个回合只让 4B VLM 想一次,执行器每块动作都去查固定的 KV 任务记忆
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程


