
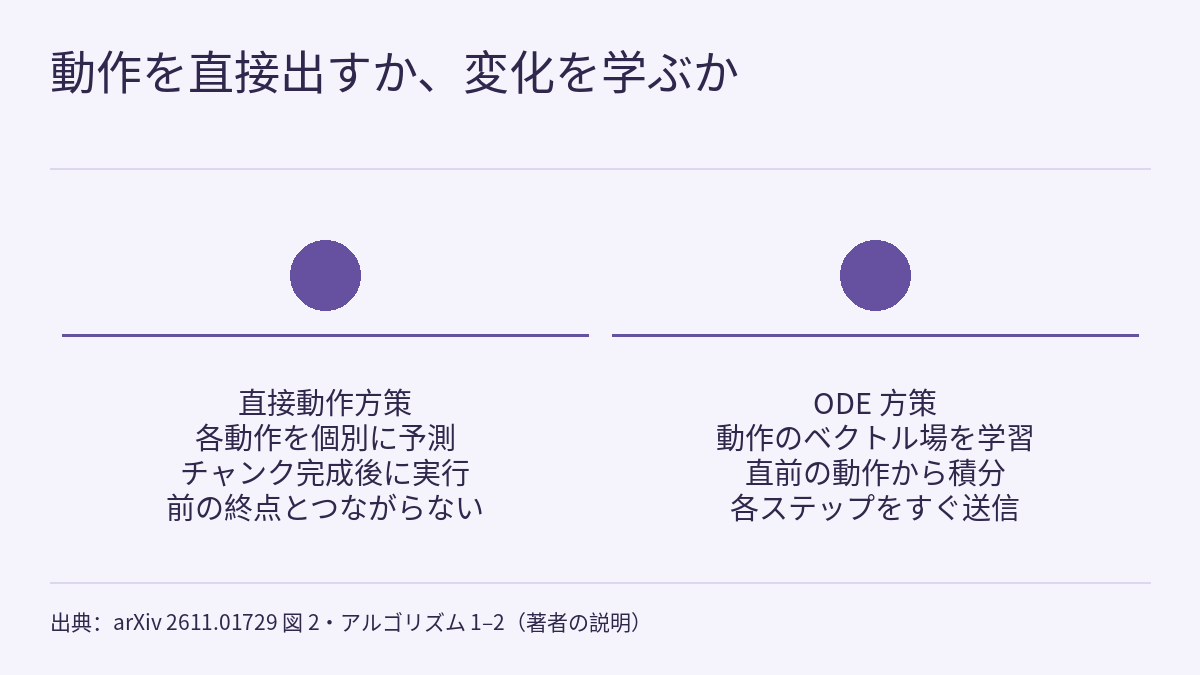
プレプリント ODE Policy(arXiv 2611.01729、2026-11-01、南洋理工大学 MARS Lab)は、ロボット方策が何を出力するかを変えます。ネットワークは制御ステップごとの動作値を直接出すのではなく、動作が変化する速度、つまり動作のベクトル場を学習し、直前の動作から次の動作を積分します。そのため、実行される動作軌道は構造上連続になり、隣り合う動作チャンクの境界でも指令が飛びません。著者は同じ定式化を、視覚運動方策、π0.5 と ImageWAM の動作ヘッド、人型ロボット上の GR00T N1.7 の動作ヘッド、SuperMimic の RL アクターとして使っています。結果を読む際は、最大の優位が学習の初期に現れ、いくつかの設定では後にベースラインが追いついている点に注意してください。以下の数値はすべて著者報告 [R] で、本サイトは再現していません。
直接動作方策に欠けているもの
論文は既存の方策を「直接動作方策」(direct-action policy)と総称します。観測と固有受容状態を符号化し、将来の動作の値を直接出力する方策です。回帰ヘッドでも、拡散・flow matching の生成ヘッドでも、RL のアクターでも、各動作は個別の値で、モデル自体は隣り合う動作の関係を何も制約しません。運動の連続性はデータから暗黙に学ぶしかありません。著者は 3 つの帰結を挙げています。
- 独立に予測されたチャンクは境界で食い違うことがあり、指令が飛びます。
- 拡散と flow matching も推論時に微分方程式を解きますが、積分変数は物理的な意味を持たない「生成時間」です。途中のサンプルはロボットが取りうる状態ではなく、各チャンクは前のチャンクがどこで終わったかに関係なく新たに生成されます。生成型の方策はチャンクごとに複数回のネットワーク評価も必要で、チャンク全体が生成されるまで最初の動作を実行できません。
- RL では、明示的な正則化がないと、アクターの動作が制御ステップ間で高い周波数で振動しがちです。
出発点は、ロボットが時間的に連続して動くマクロな系であり、遠隔操作のデモは連続した動作軌道を制御周波数でサンプリングしたものにほぼ等しい、という見方です。論文は、ダイナミック・ムーブメント・プリミティブのように ODE でロボットの運動を表す手法には長い歴史があるものの、それらはベクトル場の形を固定するかアトラクタへの収束を課すため、1 つのモデルが表せる運動が少数に限られるとも述べています。ODE Policy はベクトル場に構造上の制約を置かず、1 つの場で大規模なタスクを扱います。
学習と実行の仕組み
ベクトル場。画像の履歴と指示を z_t に符号化し、ネットワーク f_θ(a(t), s_t, z_t) が動作の速度を出力します。時間 t は制御ステップ単位で数えるロボットの物理時間です。固有受容状態 s_t は観測と一緒に符号化するのではなく、ベクトル場に直接入力されます。積分されるのは低レベル制御器に送る目標動作で、計測したロボットの状態ではありません。
チャンク単位の積分とパス損失。z_t は決定ステップごとに 1 回だけ計算してチャンクの間は固定し、直前の動作 â_{t−1} から H ステップ積分してチャンクを得ます。学習では、デモの動作から H ステップ積分し、積分した経路とデモとの二乗誤差を損失にします。チャンクが短いため、勾配は随伴法(adjoint)を使わずにソルバーのステップを直接通して逆伝播します。ベクトル場をデモの差分から求めた速度ラベルに回帰させることもしません。著者は、そうするとデモのジッターを増幅しかねないと述べています。
収縮摂動(contractive perturbation)。実行時、方策は自分の直前の出力から積分を続けるので、誤差は次のステップ、次のチャンクへ持ち越され、状態は徐々にデモから離れていきます。学習時には確率 p で始点にガウス摂動 δ を加え、積分経路が第 k ステップで a_{t+k} + ρ^{k+1}δ(0 < ρ < 1)に戻るよう求めます。ずれが等比級数的に縮むので、ベクトル場は近くの状態をデモへ引き戻すことを学びます。これはベクトル場が現在の動作を入力に取ることに依存しており、著者は直接動作方策には対応する手法がないと指摘しています。追加のデータも、推論時の追加計算も必要ありません。
推論。各動作は直前の動作から 1 回の積分ステップで得られ、次のチャンクは計測状態からやり直すのではなく、前のチャンクの最後の動作から積分を続けます。論文はこれをシームレス・チャンキング(seamless chunking)と呼びます。著者が挙げる利点は 3 つです。チャンク同士が指令の飛びなしにつながること、チャンク全体を待たずに各動作を積分したそばから制御器へ送れること、そして積分の刻み幅を配備時に選べること(たとえばより高い制御周波数に合わせる)です。
多様性ヘッド。決定論的なベクトル場はデモの平均速度に当てはまるため、障害物を左から回るデモと右から回るデモが平均され、障害物にまっすぐ向かってしまいます。著者は軽量なヘッドを加えました。各チャンクの開始時に K 成分のガウス混合から方向 ε を、ステップごとに非負の速さ λ_k をサンプルし、λ_k ⊙ ε を速度に足します。ベクトル場の隠れ特徴を勾配を止めて読むので、ベクトル場の勾配は変わりません。著者は、強い多峰性は一部のタスクにしか現れないとも述べています。LIBERO では同じ観測に対する動作の差はわずかで、IL の実験はすべてこのヘッドを含みますが、LIBERO ではサンプリングではなく成分の平均を使っています。
RL。アクターは制御ステップごとに 1 つの動作を出し(H = 1)、直前の動作から Euler 法で 1 ステップ進みます:â_t = â_{t−1} + f_θ(…)。クリティックとアルゴリズムは変えません。SuperMimic は 32 ステップの想像上のロールアウトを通して収益を逆伝播しますが、このステップによって ∂â_t/∂â_{t−1} が単位行列を含むので、勾配は動作の連鎖に沿って初期の動作まで届きます。
結果は学習エポックごとに読む
要旨のまとめでは、模倣学習において flow matching と比べ、1 エポック後に成功率 5.9 倍、汎化 5.4 倍、モードの均衡 3.9 倍に達し、動作の生成は 10.8 倍速いとしています。本文の詳細を見ると、最初の 3 つの倍率は学習の初期に集中しています(10.8 倍は推論速度で、学習エポックとは関係ありません)。
| 設定 | 1 エポック後 | その後 |
|---|---|---|
| 視覚運動方策、LIBERO の 4 スイート(3 シード) | 79.2%、6 つのベースラインの最高は 43.2% | 第 2 エポックで 85% を超え、第 100 エポックでも首位 |
| π0.5 の動作ヘッド(1 シード) | 96.0%、ランダム初期化した FM エキスパートは 75.5% | π0.5 の事前学習済み重みで初期化した FM エキスパートが第 2 エポックから追いつく |
| ImageWAM の動作ヘッド(1 シード) | 82.6%、元のヘッドは 24.6% | 3 種類のヘッドが第 6 エポックから収束 |
| LIBERO-plus のゼロショット摂動(視覚運動方策) | 30.1%、ACT は 22.6% | その後は最強のベースラインと同等 |
| 4 経路の 2D ナビゲーション、モード均衡 γ | FM-DiT の 3.9 倍 | 第 10 エポックでは FM-DiT のほうが均衡、第 20 エポックでは同程度 |
要旨と序論は「96.0% 対その flow matching エキスパートの 75.5%」と書いていますが、第 6.1.2 節によれば、75.5% はランダム初期化した FM エキスパートの値です。ODE ヘッドは約 13.7M パラメータで、元の 430M の動作エキスパートを置き換えます(論文によれば約 3%)。こちらもランダム初期化です。
データとパラメータに関する結果も LIBERO によるものです。タスクあたり 20 本のデモで第 100 エポックに 87.7% に達し、50 本すべてで学習した FM-DiT(85.4%)を上回りました。エンコーダ以外のパラメータが 1.5M しかない ODE Policy は第 10 エポックで 92.5% に達し、48M の FM-DiT のどのエポックの成績(最高 87.5%)よりも高くなりました。著者は、優位がモデルの容量ではなく ODE という定式化から来ていると結論づけています。
速度については、Euler 法で 8 動作のチャンク 1 つが 5.7 ms で、A2A-DiT と同等、FM-DiT の 10.8 倍、DDPM の約 100 倍の速さです。ACT はわずかに速いものの、成功率はずっと低くなります。π0.5 では、ODE ヘッドは 10 ステップのデノイズを行う FM エキスパートより約 14 倍速く、モデル全体の時間を約 3 分の 1 削ります。チャンク境界での指令の変化は約半分です。ImageWAM では、チャンクあたりの時間が約 4 分の 1 になります。
実機の 14 タスクと RL
実機の部分では 4 台のロボットを使います。単腕の Franka Research 3、双腕の Galaxea R1 Lite、Sharpa の多指ハンドを付けた Sharpa North、Inspire DFX の多指ハンドを付けた人型ロボット Unitree G1 です。各タスクは 20 回の試行で評価し、学習は既定で 300 エポック、単腕は 50 エポックのみ(意図的に初期の性能を見るため)、人型は 90 エポックです。比較するベースラインはロボットごとに異なります。著者は、ODE Policy が 14 タスクすべてで最も高い成功率を示したと報告しています。いくつかの結果は次のとおりです。
- 単腕(タスクあたり 40 本のデモ):靴下をたたむ 15/20、ブロックを差し込む 14/20。最良のベースラインはそれぞれ 8/20 と 4/20 です。
- 双腕:34 本のデモだけで学習した電子レンジのタスクで 75%、FM-DiT は 20%。どちらの腕がリンゴを置いてもよい多峰的な引き出しタスクでは、左腕が 8 回、右腕が 12 回リンゴに向かい、全体の成功は 60% でした。FM-DiT も両方の腕でリンゴに向かいましたが、一度も置けませんでした。
- 多指ハンド:別の研究室が公開した SharpaDex のデータ(タスクあたり 50 本)だけで学習し、著者の研究室に配備しました。倒れたコップを起こす 17/20(FM-DiT は一度もコップをつかめず)、両手で錠剤を移す 17/20(FM-DiT は 10/20)、キューブを積む 13/20(2 つのベースラインはすべて失敗)です。
- 人型:GR00T N1.7 の動作ヘッド(約 5M パラメータのベクトル場、H = 16、Euler 法)として、タスクあたり 90 本のデモで、歩行とつかみを組み合わせた 2 つの長期タスクで 60% と 70%。GR00T の元の動作ヘッドは 35% と 30% でした。
タスクあたり 20 回なので、1 回は 5 ポイントに相当します(本サイトの換算)。読んだ本文には実機結果の信頼区間はありません。3 台のロボットでそれぞれ 1 タスクを測ったところ、チャンクの生成は拡散・flow matching のベースラインより 3.5〜27 倍速く、チャンク境界での指令の加速度はデモと同等以下(単腕ではデモに近い値)にとどまりました。ベースラインはデモの数倍に達しています。
RL の部分では、SuperMimic のアクターを ODE アクターに置き換え、世界モデル、クリティック、報酬、ハイパーパラメータはそのままにしています。シミュレーション上の Unitree G1 が LAFAN1 の 40 本のモーションクリップを追従し、手法ごとに 3 シード、GPU 1 基で 3 時間学習しました。0.75 時間の時点で学習収益は 37% 高く(0.630 ± 0.007 対 0.460 ± 0.008)、40 クリップすべての評価収益は 0.4 時間で 30% 高く、学習終了時には 0.885 ± 0.007 対 0.845 ± 0.009 でした。PPO は 3 時間後に 0.452 ± 0.021 です。最初の想像上の動作に対する勾配ノルムと最後の動作に対するものの比は、直接動作アクターで約 0.57、ODE アクターで 1.0〜1.1 でした。著者は、高速化はこの勾配経路から来ている「可能性が高い」と述べています。3 時間後、ODE アクターの動作の加速度は元のアクターより 21% 小さくなりました。
どの設計が効いているか:アブレーション
- チャンク長。学習と実行の両方で H = 1 にすると、第 100 エポックで 76.4% にとどまり、動作あたりの時間も最も長くなります(毎ステップでエンコーダを実行するため)。H = 4 以上では成功率が 91% を上回り、既定の H = 8 が最良です。H ≥ 12 では学習中に損失のスパイクが時折出ます。
- ソルバー。RK4 を RK2 や Euler 法に替えても、第 100 エポックの成功率の変化は 1 ポイント未満で、シード間のばらつきの範囲内です。著者は、性能が正確なソルバーではなく ODE という定式化から来ていると結論づけています。Euler 法なら学習時間は FM-DiT と同程度です。
- 収縮摂動。これを除くと、1 エポック後の成功率は 79.8% から 58.4% に下がり(このアブレーションはタスクあたり 10 エピソードなので、既定値が 79.2% ではなく 79.8% になります)、差は第 20 エポックまでに消えます。摂動を既定の 2 倍にすると、後半はわずかに低くなります。
- シームレス・チャンキング。代わりに各チャンクを計測状態からやり直すと、1 エポック後の成功率は 79.8% から 47.8% に下がります。論文の説明では、目標動作が計測状態より先行している分が失われるためです。
本サイトの読みでは、この 2 つのアブレーションから、初期の大きなリードのかなりの部分が、学習時にベクトル場へデモに戻ることを教えることと、実行時に最後の指令から積分を続けることに由来していると考えられます。この帰属は論文自身の記述ではありません。論文は第 8 節で、摂動を除いても ODE policy は 1 エポック後に FM-DiT と A2A-DiT を大きく上回っていると付け加えています。読んだ本文にあるのは初期の数値で、後半のエポックの曲線は図 17 にありますが、本サイトは図中の値を読んでいません。
本サイトの講座とフロンティア・レーダーとの関係
フィジカルAIラボ 1.6:模倣学習 では 2 つの点を扱いました。行動クローニングの誤差がロボットをデモのカバー範囲の外へ連れ出すこと、そして障害物を回る 2 つの正しいやり方が平均されて衝突になりうることです。ODE Policy はそれぞれに構造上の手当てをしています。収縮摂動は学習時に、ずれた状態をデモへ引き戻すようベクトル場に教え、多様性ヘッドは各チャンクの開始時に方向を 1 つ選びます。1.6 の ACT の動作チャンキングもそのまま使いますが、チャンクを積分の単位として扱います。
フィジカルAIラボ 2.3:SmolVLA をファインチューニングする の動作エキスパートは、flow matching でノイズを少しずつ整えてチャンクにします。非同期推論は、現在のチャンクを実行しながら次のチャンクを計算するものです。ODE Policy の「ストリーミング実行」は別のもので、チャンクの中で各動作を積分したそばから送り、次のチャンクは前のチャンクの終点から計算を続けます。フィジカルAIラボ 2.6:エッジへ ではチャンク長のトレードオフを扱いました。本論文の H のアブレーションは、同じトレードオフを 1 つの具体的な手法で測った数値ですが、LIBERO だけで測られています。RL の節のアクターと収益は、フィジカルAIラボ 1.7:強化学習 と併せて読めます。
フロンティア・レーダー|ActionUNet も VLA の動作の滑らかさを扱いますが、凍結したバックボーンの動作特徴に時間 U-Net と連続デコーダーを加える方法です。ODE Policy は動作ヘッド全体を置き換えます。両者はベンチマークも比較対象も異なるので、数値は比べられません。本論文の表を読む際は、フィジカルAIラボ 1.8:評価 の方法で問い直せます。π0.5 と ImageWAM はシードが 1 つだけで、実機は各タスク 20 回です。初期の優位が学習の終わりまでどこまで続くのかも確かめる必要があります。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者報告 [R] です。本サイトは再現していません。論文の冒頭にはプロジェクトページとコードが挙がっていますが、本サイトは開いて確認していません。
- 本サイトが読んだ本文は第 8 節のアブレーションの途中で終わっています。第 9 節(計測状態しかない場合に目標動作と計測状態の差をどう扱うか、グリッパーをベクトル場で積分するアブレーションを含む)と、付録・補足の表はすべて読んでいません。
- 「5.9 倍、5.4 倍、3.9 倍」はいずれも 1 エポック学習した後の比です。π0.5 では事前学習済みの FM エキスパートが第 2 エポックから追いつき、ImageWAM では 3 種類のヘッドが第 6 エポックから収束し、LIBERO-plus では後半に最強のベースラインと同等になり、ナビゲーションのタスクでは第 10 エポックで FM-DiT のほうが均衡しています。
- 視覚運動方策の実験は 3 シード、π0.5 と ImageWAM の結果は 1 シードです。実機は各タスク 20 回で、ベースラインはロボットごとに異なり、人型では GR00T の元の動作ヘッドとしか比べていません。読んだ本文には実機結果の信頼区間がありません。
- LIBERO では二値のグリッパー指令を別の分類ヘッド(0.27M パラメータ)で予測しており、ベクトル場では積分していません。LIBERO では多様性ヘッドは成分の平均を使い、サンプリングしません。
- 積分されるのは低レベル制御器に送る目標動作です。計測状態しかないデータ(UMI で集めたデータや人の動画など)については著者が第 9 節で論じていますが、本サイトは読んでいません。
- LIBERO-plus でカメラを変えると、すべての手法が失敗します。RL の結果はシミュレーション上のモーション追従だけで、実機での RL はありません。いずれの結果もハードウェアの安全性検証ではありません。
リンク
- ODE Policy: Robot Learning via Action Dynamics, Not Actions(arXiv 2611.01729)
- 論文の HTML 全文
- フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読む
- フィジカルAIラボ 1.7:強化学習――1 回分の収益を手で計算して報酬の抜け道を見つけ、論文の地形カリキュラムとタイムアウト時のリセットを読む
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フィジカルAIラボ 2.3:SmolVLA をファインチューニングする――指示に合わせてお手本を計画し、各数字が何を測ったかを確かめ、非同期の動作キューの時間を計算する
- フィジカルAIラボ 2.6:エッジへ――遅延のログから制御周波数の上限を求め、量子化で減るのが容量か時間かを見分け、動作チャンクの長さを決める
- フロンティア・レーダー|ActionUNet:VLA の動作特徴に時間 U-Net と連続デコーダーを加え、多重スケールと滑らかさを両立する
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)


