
プレプリント DEED(arXiv 2610.40430、2026-10-29、南京大学の Jingxu Gu と Dongze Lian)は、コンペティション参加手法の報告です。事前学習済みの VLA である Xiaomi-Robotics-1 を、MetaFine の 5 つのシミュレーション上の精密操作タスクに適応させています。新しいモデル構造は提案していません。変えたのは 2 点で、モデルに与えるデモの分布と、モデルが予測した動作チャンクをロボットへの指令に変える方法です。著者は公式の総合スコア(Overall)85.55% を報告しており、同じリーダーボードで公表された π0 ベースラインは 43.01% です。この論文で読む価値が高いのは内訳のほうです。5 タスクのうち 2 つは約 64.6% にとどまり、方策を固定した比較では、実行ステップ数、ノイズ除去ステップ数、グリッパーの対応づけといったデプロイ時の設定だけで成績がはっきり変わっています。以下の数字はすべて著者報告 [R] で、本サイトでは再現していません。
MetaFine は何を測るのか、そのままのファインチューニングでは何が足りないのか
論文の説明によると、MetaFine は 5 つのタスクで精密操作を評価します。部品レベルの把持、方向を指定した移動、スイッチの切り替え、物体の仕分け、文字の挿入です。論文の表 1 の指示に従うと、それぞれ T1(部品 cap または body)、T2(前・左・右)、T3(赤または青のスイッチ)、T4(赤・青・緑のキューブ)、T5(文字 C・o・R・L)に対応します。評価は 3 つの観点で行います。Perception(P、カメラと照明の変化の下での知覚。成功率曲線の下の面積 AUSC で採点)、Understanding(U、指示に応じて行動を変えられるか)、Controlled Behavior(B、実行中の制御された振る舞い)です。各タスクのスコアは P・U・B の平均、Overall は 5 タスクのスコアの平均です。
著者は、提供されたデモで事前学習済み VLA をそのままファインチューニングすると、3 つの不足が残ると述べています。
- シーンと指示が交絡する。異なる指示が異なるシーンにしか現れないと、方策は指示を読まずにシーンを見分けて目標を選べてしまいます。著者が T5 の公開メタデータを調べたところ、文字ごとのサブセットでシーンのシードが重なっておらず、この近道が生じる余地がありました。
- 視覚的なカバー範囲が狭い。デモに含まれるカメラ位置と照明条件が少なすぎます。
- 実行インターフェースが合わない。実行ステップ数、逆運動学による変換、グリッパーの意味づけがシミュレータのインターフェースと合わないと、予測した動作チャンクが失敗することがあります。
デモの拡張:同じシーンに別の指示、同じ軌道に別の画像
指示のペア化。1 つの初期シーンについて、公式のエキスパートプランナーがそのシーンの指示ファミリーの指示ごとに軌道を生成します。初期配置は共通で、目標とその後の動きが指示によって変わります。ファミリー内のすべての指示で成功した場合にだけ、その組を残します。こうすると同じ初期画像から異なる判断が求められるので、方策が両者を区別するには指示を読むしかありません。
物理状態からの再描画。ベンチマーク付属の ManiSkill3/SAPIEN シミュレータで、保存した軌道の各状態を復元し、新しいカメラと照明のパラメータでベースカメラとハンドカメラの画像を描画し直します。固有受容の入力と将来の動作目標は変えず、元の物理状態に結びついたままです。論文は、変わるのは観測の生成だけなので、視点に依存する幾何と動作ラベルの対応が保たれると強調しています。摂動は 3 段階で、カメラの並進の上限は 0.03・0.06・0.12 m、回転の上限は 2°・6°・12°、照明は環境光 RGB 0.5 を中心に半幅 0.10・0.25・0.40 です。5 タスクすべてでカメラと照明の摂動を使い、T5 だけはカメラと照明の複合摂動も加えています。複合摂動の描画は 120 本の元の軌道をカバーします。
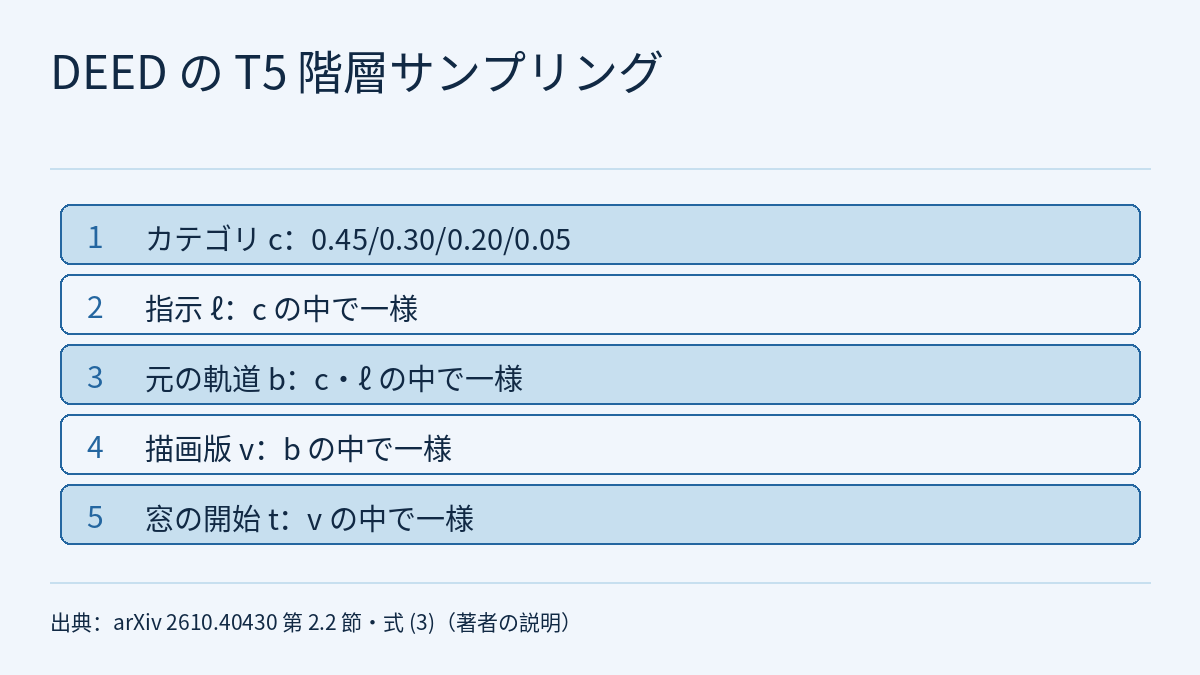
階層サンプリング。拡張後は、描画コピーの多い軌道ほど多く引かれてしまいます。そこで T5 のデータローダーは階層ごとに順にサンプリングします。まず決められた確率で拡張カテゴリを引き(クリーン、カメラ、照明、複合がそれぞれ 0.45、0.30、0.20、0.05)、次にそのカテゴリ内で指示を一様に、続いて元の軌道を一様に、その軌道の描画バリアントを一様に、最後に学習窓の開始位置を一様に引きます。元の軌道を描画バリアントより先に引くので、同じカテゴリと指示の中では、描画コピーを増やしてもある軌道が引かれる確率は上がりません。論文は、この確率が学習データのサンプリング分布であり、方策の行動確率ではないと明記しています。
T5 の最終的なデータには、成功した異なる軌道が 2,800 本、描画後のレコードが 7,840 件あり、そのうち 2,000 本は 4 つの指示を持つ 500 のシーンから新たに生成した動きです。ほかのタスクのレコード数(描画バリアントを含む)は、T1 が 6,400、T2 が 3,300、T3 が 2,080、T4 が 2,940 です。
モデルの入力は、タスクの指示、ベースとハンドアイの 2 系統の RGB 画像、関節とグリッパーの状態(アームの 7 関節の位置と 2 本の指の位置の平均)です。一度に K = 30 個のエンドエフェクタ動作を予測し、flow matching で生成します。著者は Xiaomi-Robotics-1 の構造と公開された学習実装をそのまま使っています。T5 の最後の追加学習は BF16 で 12,000 回の更新(バッチ 4)、学習率は 3 × 10⁻⁶ から 5 × 10⁻⁷ へのコサインスケジュール、ウォームアップは 300 回です。
実行の設計:動作チャンクを関節指令に変える
デプロイ時には、方策が出力したローカルなエンドエフェクタのオフセットをワールド座標系の目標に変換し、逆運動学で 7 つの関節の増分を求めます。指の目標は −0.01〜0.04 m の範囲に制限し、タスクの閾値 θ_g を下回る目標はすべて完全な閉鎖(−0.01 m)に対応づけます。連続的なグリッパー目標を残すのは T3 だけです。ロボットは 30 ステップの予測のうち最初の H ステップだけを実行し、観測し直して再び予測します。これは receding horizon 型の再計画です。H、ノイズ除去ステップ数 D、θ_g は、すべての接触に 1 つの設定を当てはめるのではなく、タスクごとの評価で選んでいます(論文の表 1)。
| タスク | ペアにした指示 | レコード数 | H | D | θ_g(mm) |
|---|---|---|---|---|---|
| T1 | cap / body | 6,400 | 10 | 5 | 35 |
| T2 | 前 / 左 / 右 | 3,300 | 25 | 2 | 15 |
| T3 | 赤 / 青のスイッチ | 2,080 | 25 | 5 | —(連続) |
| T4 | 赤 / 青 / 緑のキューブ | 2,940 | 25 | 5 | 35 |
| T5 | C / o / R / L | 7,840 | 25 | 30 | 35 |
結果:1 つの総合スコアと、2 種類のタスク
公式の最終成績(論文は 2026-10-24 更新の主催者リーダーボードを引用しています):
| タスク | P | U | B | タスクスコア |
|---|---|---|---|---|
| T1 | 68.96 | 62.50 | 62.50 | 64.65 |
| T2 | 98.47 | 100.00 | 100.00 | 99.49 |
| T3 | 98.96 | 100.00 | 100.00 | 99.65 |
| T4 | 98.15 | 100.00 | 100.00 | 99.38 |
| T5 | 61.15 | 66.25 | 66.25 | 64.55 |
| 平均 | 85.14 | 85.75 | 85.75 | 85.55 |
- 85.55% は 2 つのグループの平均です。T2・T3・T4 はいずれも 99% を超え、部品レベルの把持 T1 と文字挿入 T5 は 64.65% と 64.55% にとどまります。π0 ベースラインを 42.54 ポイント上回るというのはこの総合スコアの話で、読んだ本文には π0 のタスク別スコアはありません。
- U と B はどの行でも同じ値です。5 タスクすべてで U と B の列が完全に一致しています。読んだ本文に理由の説明はなく、本サイトも推測はしません。
論文では、方策を固定したローカルな比較もいくつか行っています(各比較の中では重みと正規化を固定し、flow ノイズのシードは 0)。
- T1 の実行ステップ数。20 シーンを 3 バッチ、計 60 シーンで、H の値ごとに 540 エピソードです。H = 10 で P 93.75・U 78.33・SR 90.19、H = 25 で 84.03・69.17・80.93、H = 5 で 85.56・65.83・81.30 でした。SR は、シーンごとに指示のクリーンなエピソード 2 回と知覚のエピソード 7 回を同じ重みで合算したものです。H = 10 は長い設定と短い設定の両方を上回り、著者はここから、実行窓をさらに短くしても一貫して有利になるわけではないと述べています。シーンごとに指示のエピソードが 2 回あるとすると、U の 78.33% と 69.17% は 120 回中およそ 94 回と 83 回の成功に当たります(本サイトの計算)。
- T3 のノイズ除去ステップ数。新しい 40 シーンで、D の値ごとに 360 エピソードです。D = 3 とデプロイで使った D = 5 は同じ結果(P 98.13・U 97.50・SR 98.06)で、D = 10 は P が 0.83 ポイント、U が 2.50 ポイント低く、同じ計算では 80 回中およそ 2 回少ない成功です(本サイトの計算)。この掃引では D = 1 を試していません。
- グリッパーの対応づけ。より早い段階の、部分的にしか適応していない T1 の方策で 20 シーンを試しています。連続的なグリッパー目標では P = 27.92%、U = 14/40(35.00%)、閾値による完全な閉鎖では P = 57.92%、U = 22/40(55.00%)でした。古い方策での結果なので、最終的に提出した方策にそのまま当てはめることはできません。
- 指示は読まれているか。エキスパートが選別した T5 の 8 シーンで、正しい指示では 32 回中 21 回成功(65.63%)、文字の指示を巡回的に入れ替えると 32 回すべて失敗(0%)でした。初期状態と画像はペアごとに一致させています。本サイトの読み方では、この 8 シーンでは成功が正しい指示に依存しており、シーンを見分けるだけで成功しているわけではないことを示しています。
これらの比較について、著者自身が 2 つの注意を書いています。各設定でシーンのシードは共通ですが、環境の履歴によってその後の物理的な初期状態が変わりうるため、これは集計値の比較であり、初期状態を完全に一致させた反実仮想の比較ではありません。また H を変えると、動作チャンクの番号に結びついた flow ノイズの系列も変わります。さらに、ローカルの掃引では H = 10 の T1 の P が 93.75 ですが、公式成績の T1 の P は 68.96 です。両者は別々の評価で、論文はこの差を説明しておらず、ローカルの数字を公式成績の代わりに使うことはできません。
本サイトの講座やフロンティア・レーダーとの関係
DEED の指示のペア化と再描画は、フィジカルAIラボ 1.5:データはどこから来る?で扱った「合成」というルートの具体的なやり方の 1 つで、論文も MimicGen を引用しています。1.5 が強調した「生成した本数は、カバーした状況の数とは違う」という点に、DEED はもう一歩加えています。「同じシーンで異なる指示」という軸も制御し、描画コピーが学習の分布を知らないうちに変えないよう、階層サンプリングを使っています。物理状態からの再描画は、フィジカルAIラボ 2.5:sim2real のドメインランダム化とシステム同定で扱ったドメインランダム化と同じ系統です(論文は Tobin らの研究を引用しています)。ただしここでランダム化するのはカメラと照明だけで、目的は評価に含まれる視覚的な摂動をカバーすることです。読んだ本文は実機への移行には触れていません。
「最初の H ステップを実行してから観測し直す」は ACT の動作チャンクの考え方を引き継いでいます。フィジカルAIラボ 1.6:模倣学習を参照してください。エンドエフェクタの目標を逆運動学で関節の増分に変える部分は、フィジカルAIラボ 1.1:座標系と運動学で扱いました。フロンティア・レーダー|PAV も動作チャンクをどこまで実行するかを扱いますが、こちらは実行時に予測した結果からチャンクごとに決めます。DEED はオフラインでタスクごとに掃引し、タスクごとに固定の H を決めています。2 つの論文はベンチマークも方策も違うので、数字は比べられません。「シーンのシードが共通でも初期状態が一致するとは限らない」「1 つの平均値がタスクごとの差を隠す」という読み方は、フィジカルAIラボ 1.8:評価の対応表で練習できます。
制約と注意点
- arXiv のプレプリントで、数字はすべて著者報告 [R] です。公式成績は論文が引用した主催者のリーダーボードによるもので(論文には 2026-10-24 更新、2026-10-28 閲覧とあります)、本サイトはリーダーボードを開いて確認しておらず、どの結果も再現していません。
- 実験はすべて MetaFine のシミュレーション環境で行われています。読んだ本文に実機の実験はなく、これらの結果はハードウェアの安全性検証ではありません。
- 再描画、階層サンプリング、複合摂動の詳細は主に T5 について示されています。ほかのタスクの拡張の規模は、表 1 のレコード数からおおよそ見当をつけられるだけです。
- ローカルの比較はどれも flow ノイズのシード 1 つだけで、読んだ本文には信頼区間や有意性検定がありません。グリッパーの比較は以前の部分的に適応した方策によるもので、指示の入れ替えテストは 8 シーン、条件ごとに 32 回だけです。
- 論文の本文は公式成績の表を「Table 3」と呼んでいますが、その表のキャプション番号は Table 2 で、ローカルのアブレーションの表が Table 3 です。HTML 版での番号の食い違いです。
- 読んだ本文には、DEED のコードや拡張したデータを公開するかどうかの記載がありません。約 94/120、83/120、80 回中 2 回少ないという数字は、論文が示すエピソードの構成から本サイトが計算したものです。
リンク
- Improving Fine-Grained Manipulation through Demonstration Expansion and Execution Design(arXiv 2610.40430)
- 論文の HTML 全文
- フィジカルAIラボ 1.5:データはどこから来る?――SO-101 のメタデータからお手本の長さを求め、三つの入手ルートの単位と動作空間を見分ける
- フィジカルAIラボ 2.5:sim2real のドメインランダム化とシステム同定――二本の論文の数字を元の設定に戻し、コップを押した一本の軌跡から摩擦を手で求める
- フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読む
- フィジカルAIラボ 1.1:座標系と運動学――2 リンクのアームがコップに届く計算を手で追う
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フロンティア・レーダー|PAV:VLA 自身の表現空間で各動作プレフィックスの結果を予測し、動作チャンクをどこまで実行するかを決める
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)


